Werkstattnotizen
KI-Architektur: Die Entscheidungen hinter den Systemen, die ich baue
Jeder Beitrag zerlegt eine Architekturentscheidung aus einem System, das ich baue, oder ein Ergebnis, das ich nachweise: den Fehler, den ich finde, die Korrektur, die ich anwende, und die Kennzahl, die sie bewegt.
-
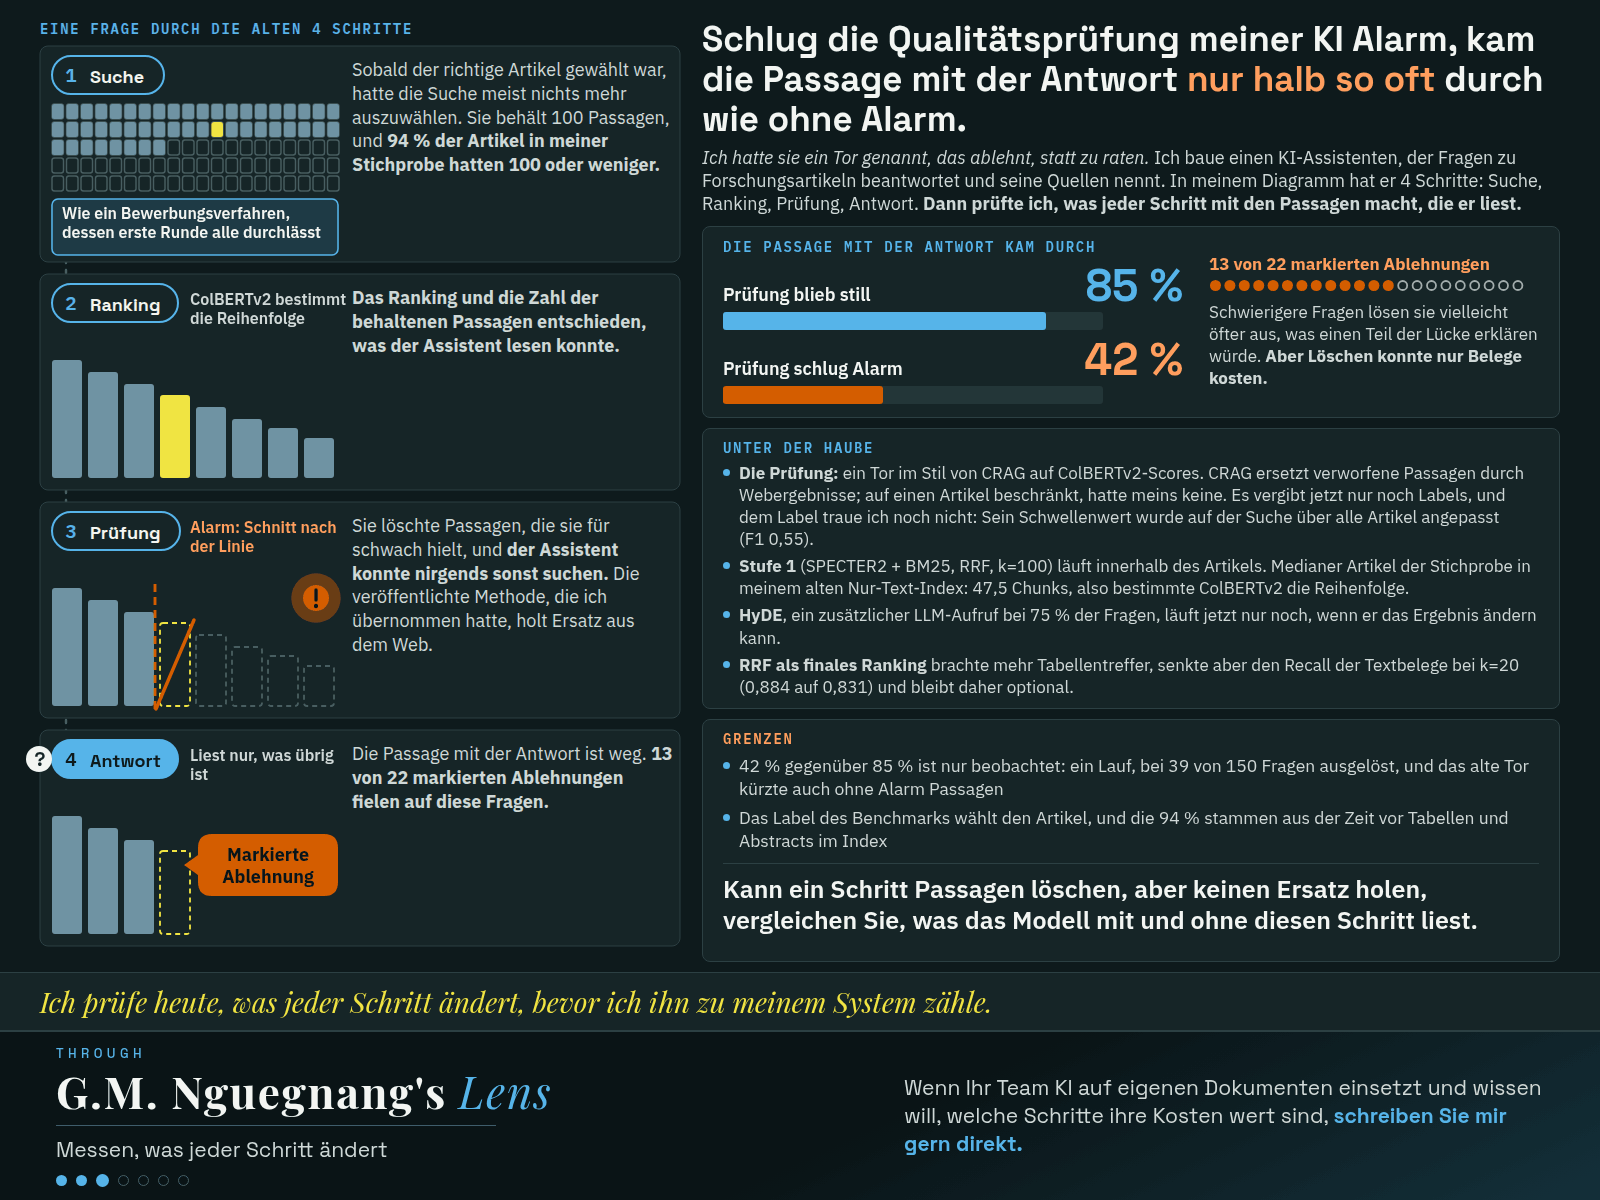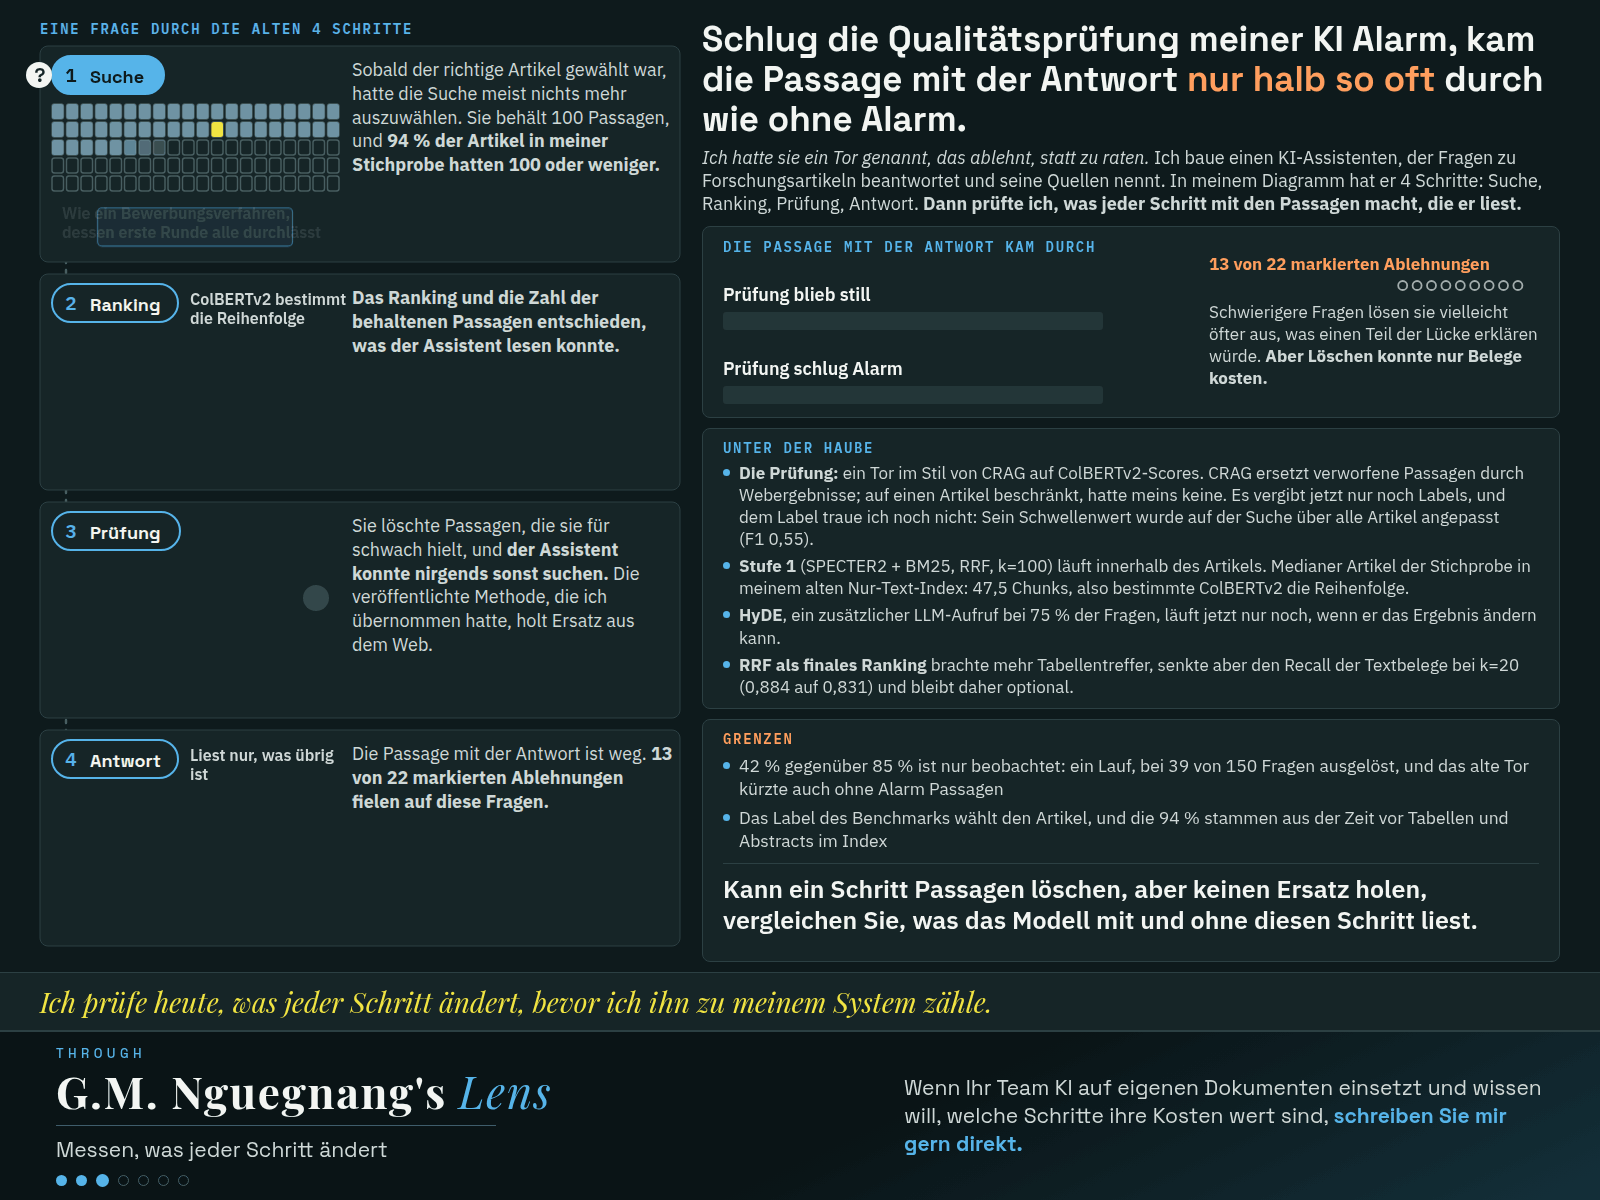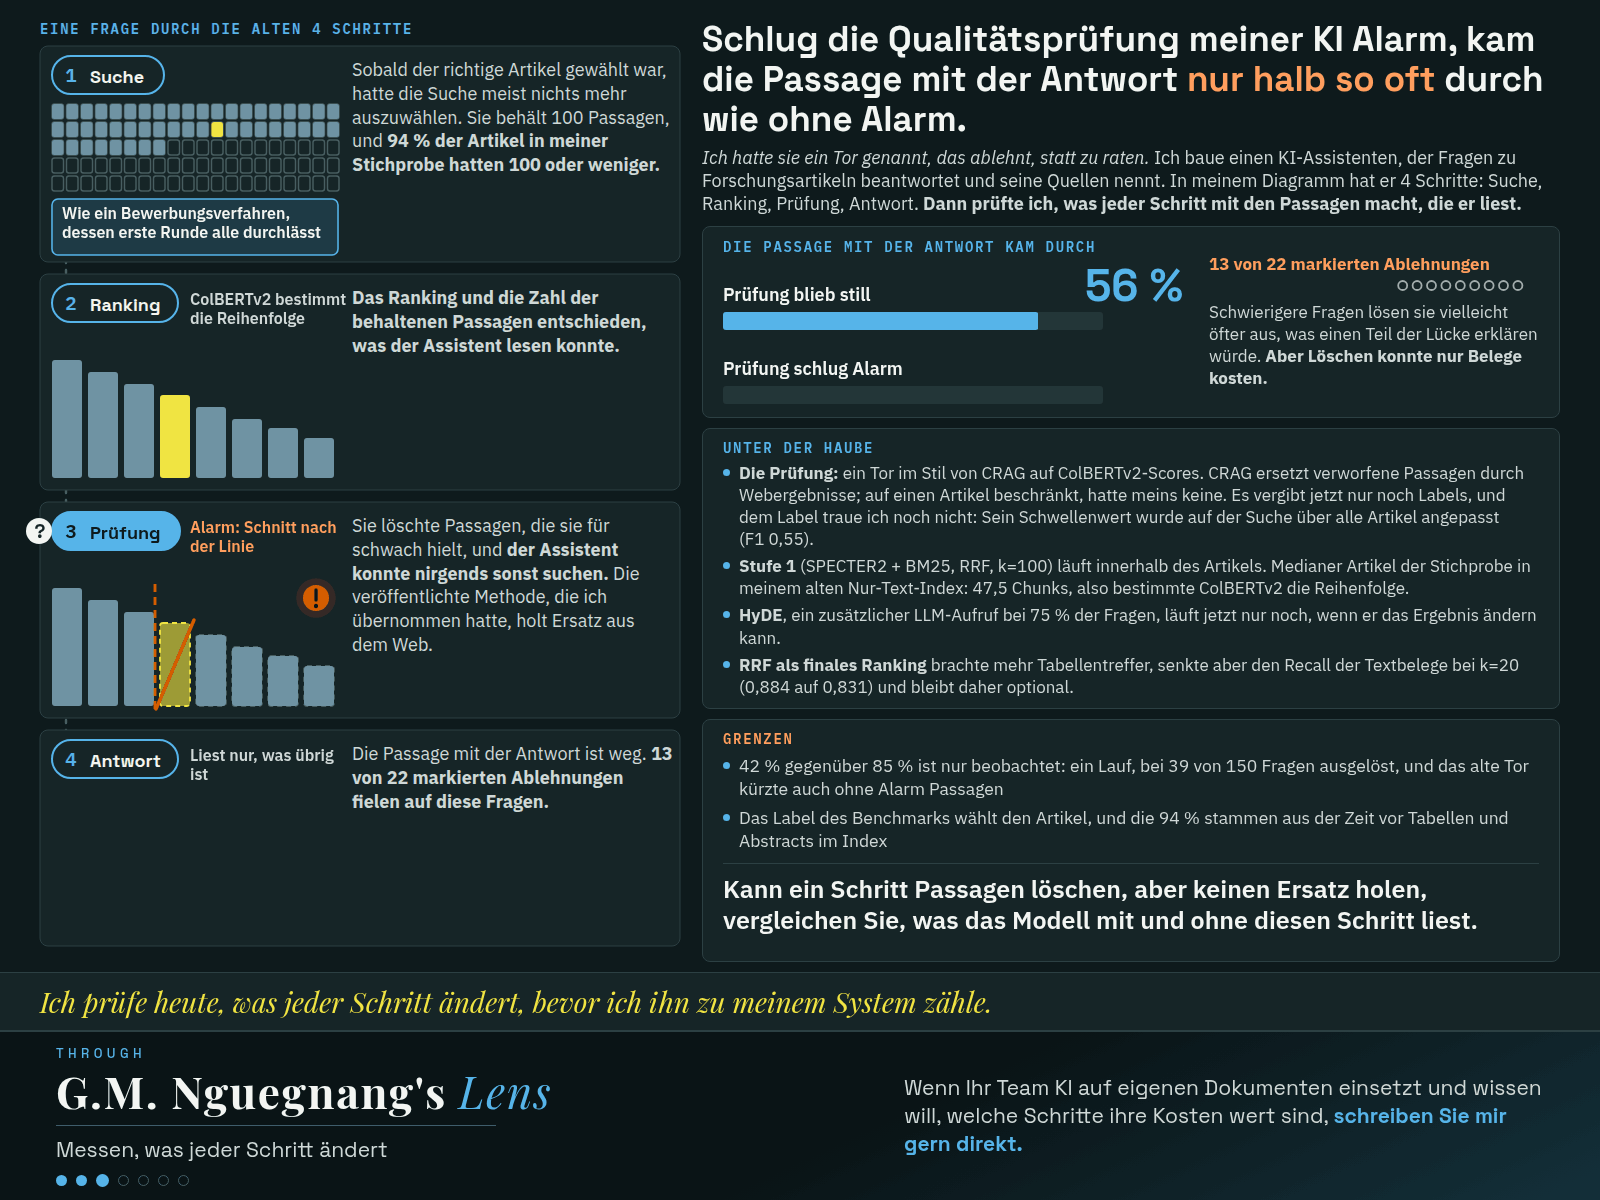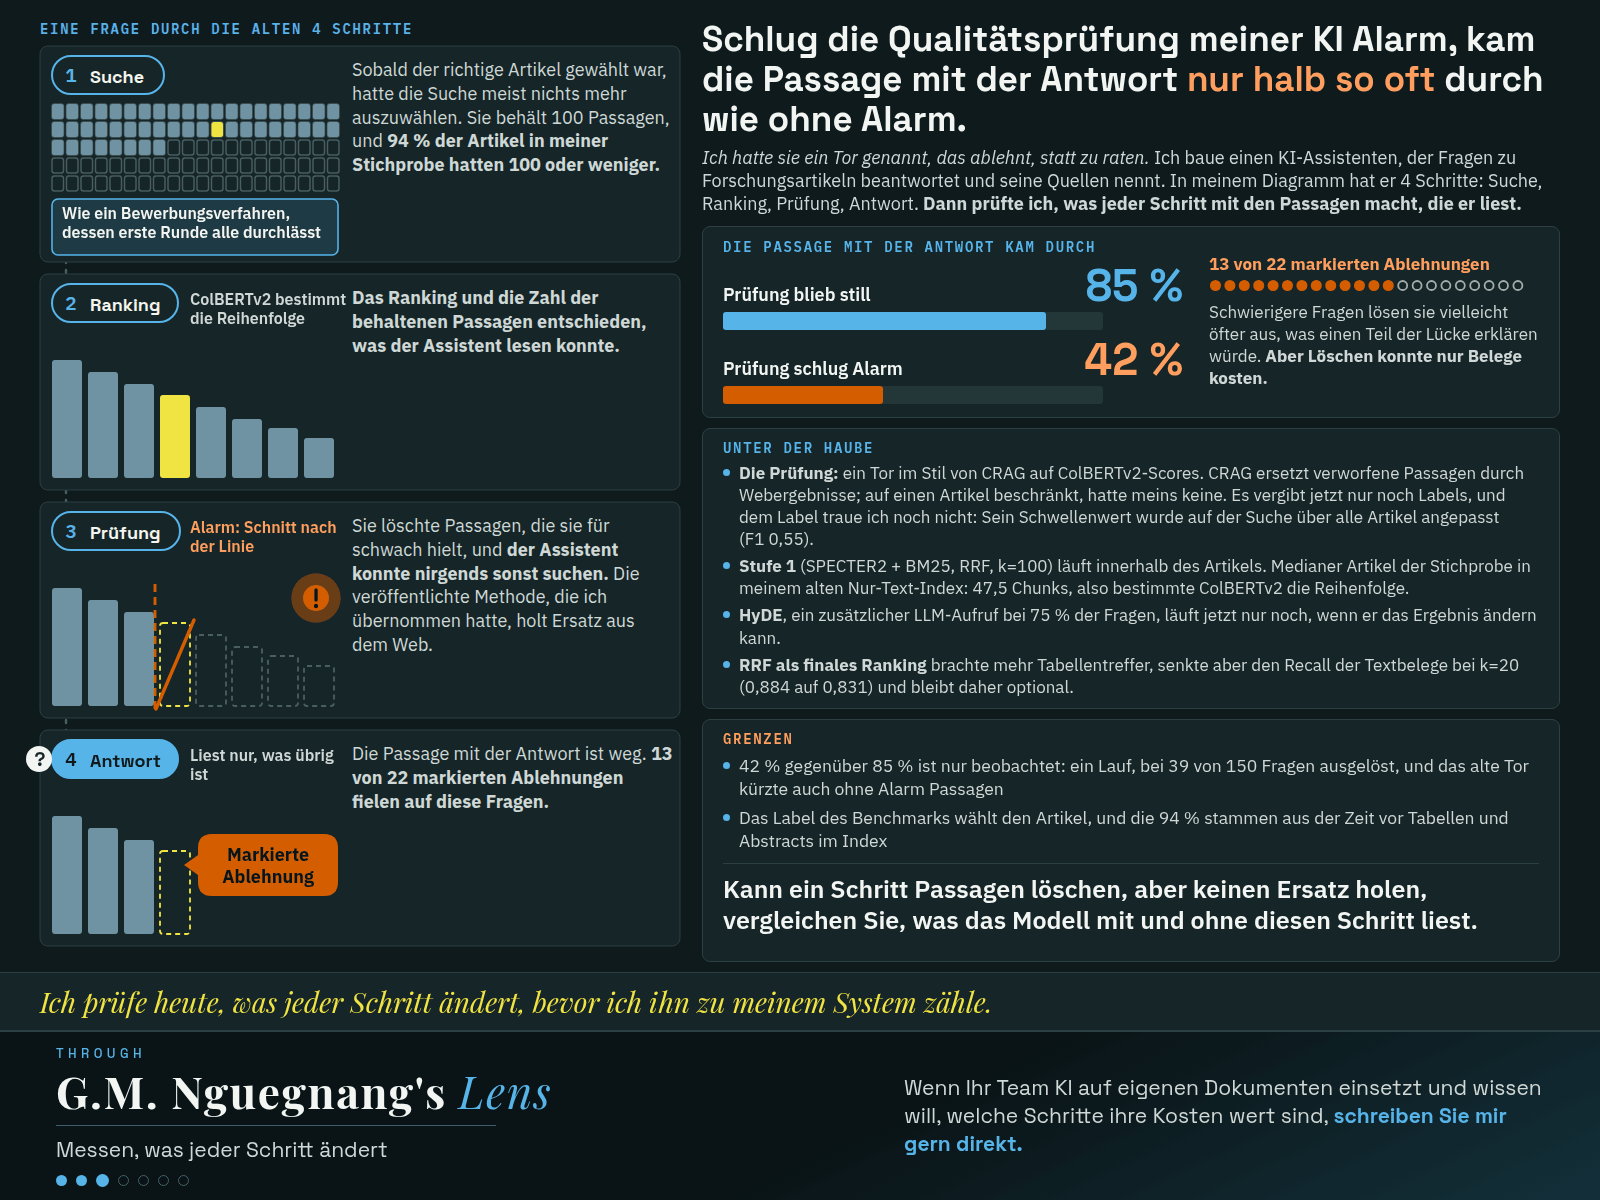
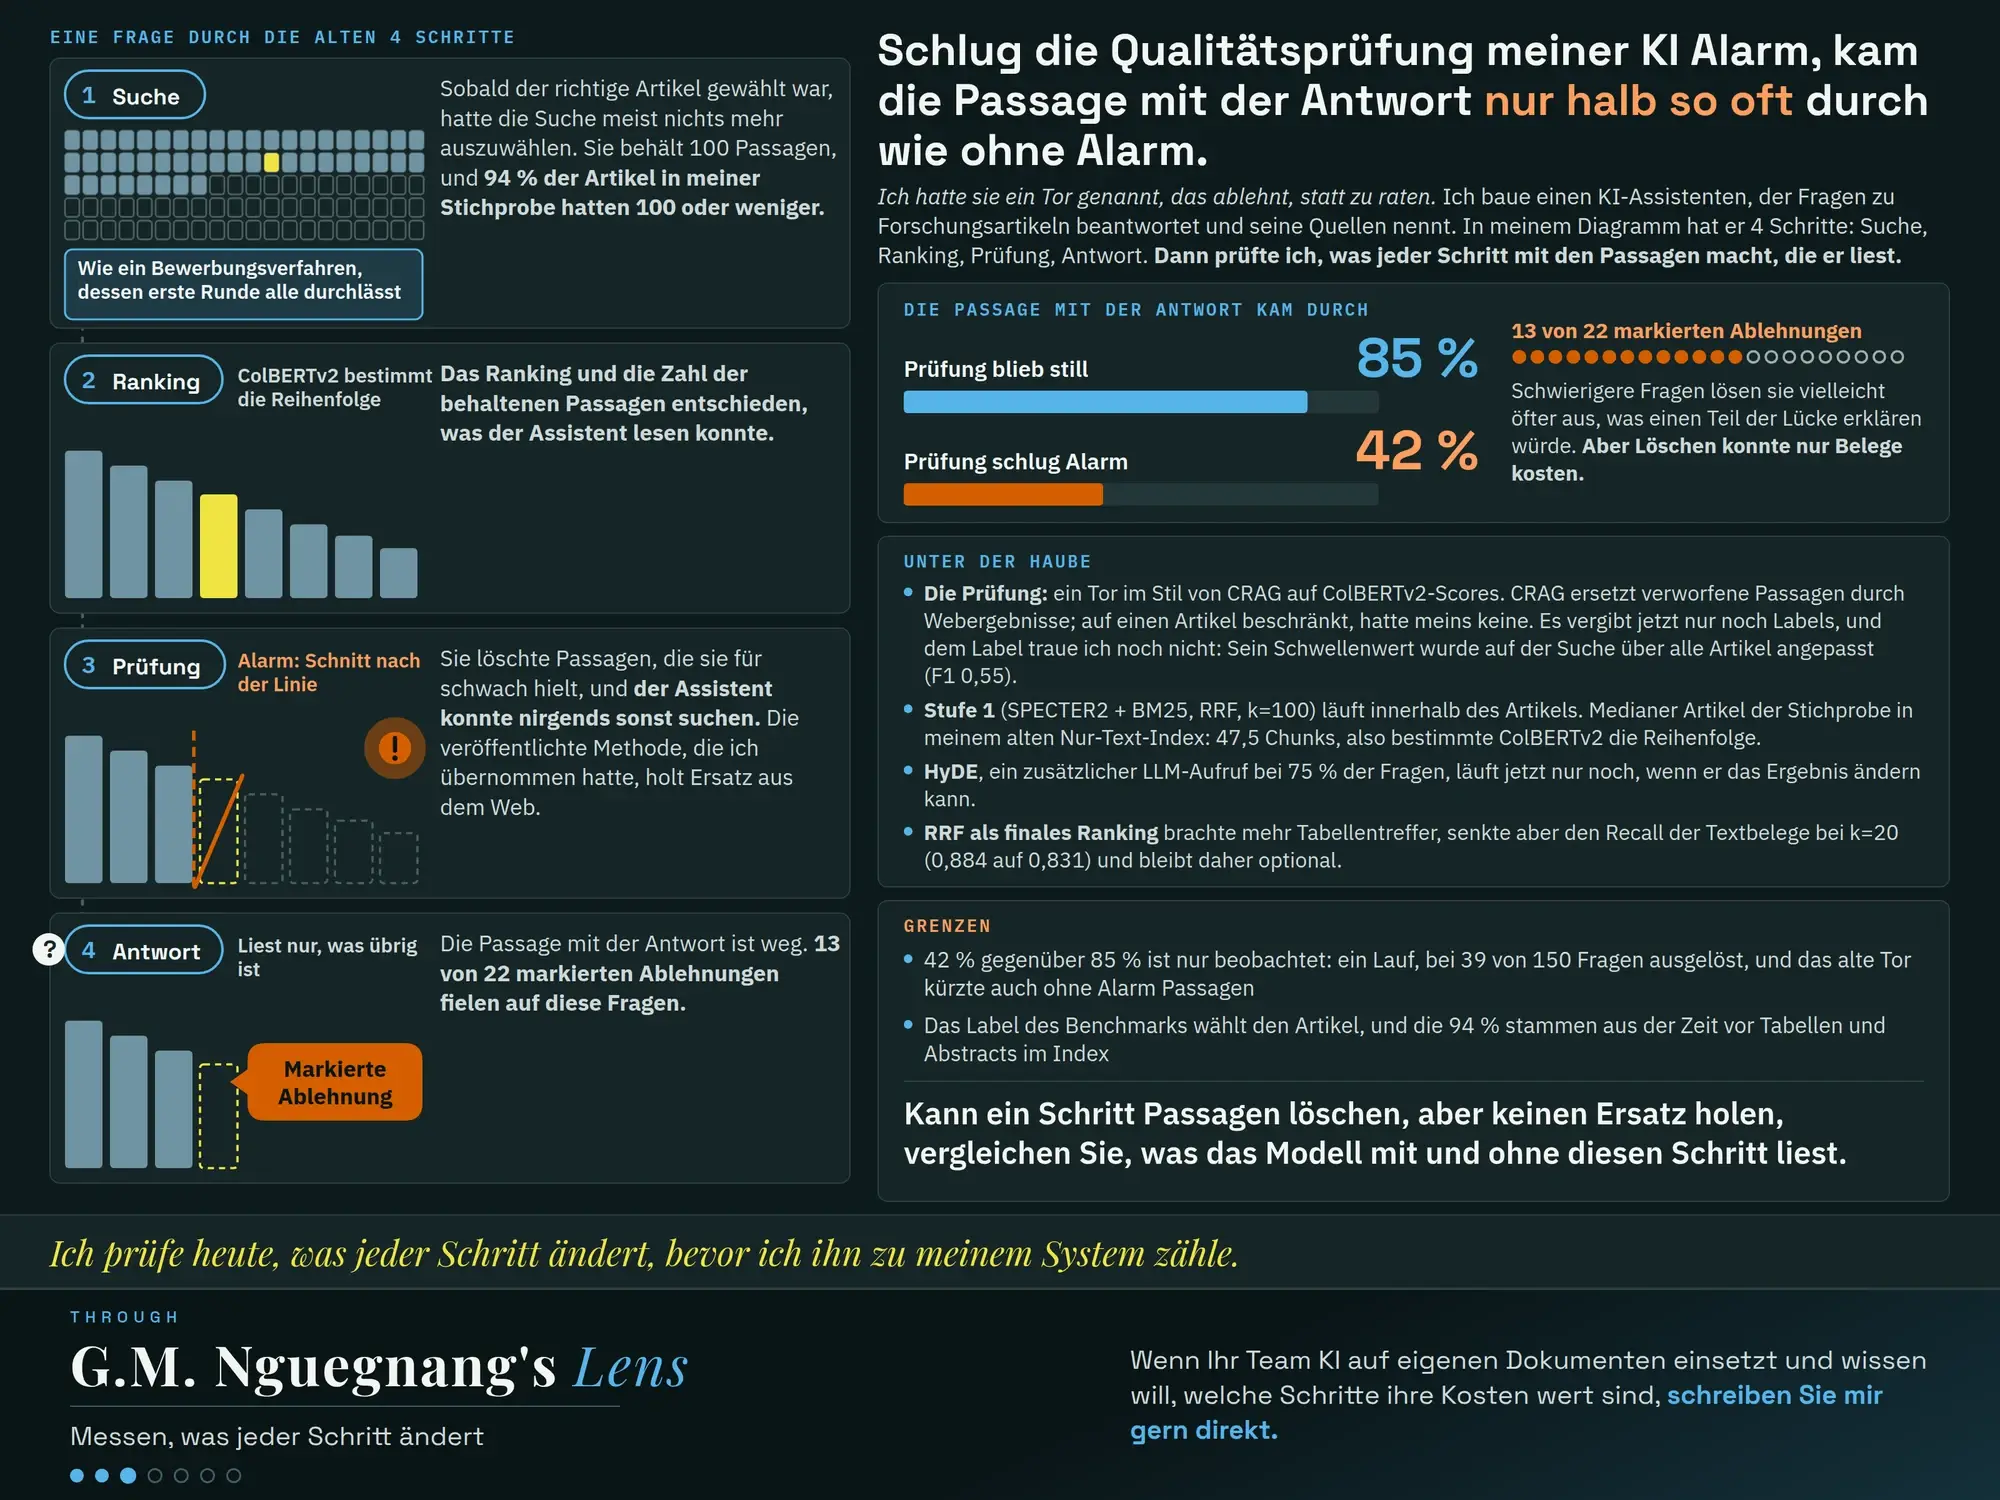
Schlug die Qualitätsprüfung meiner KI Alarm, kam die Passage mit der Antwort nur halb so oft durch wie ohne Alarm
Auf dem Papier hat mein KI-Assistent 4 Schritte: Suche, Ranking, Prüfung, Antwort. Als ich maß, was jeder davon mit den gelesenen Passagen macht, zeigte sich: Einer wählte kaum etwas aus, ein anderer konnte nur Belege verlieren.
-
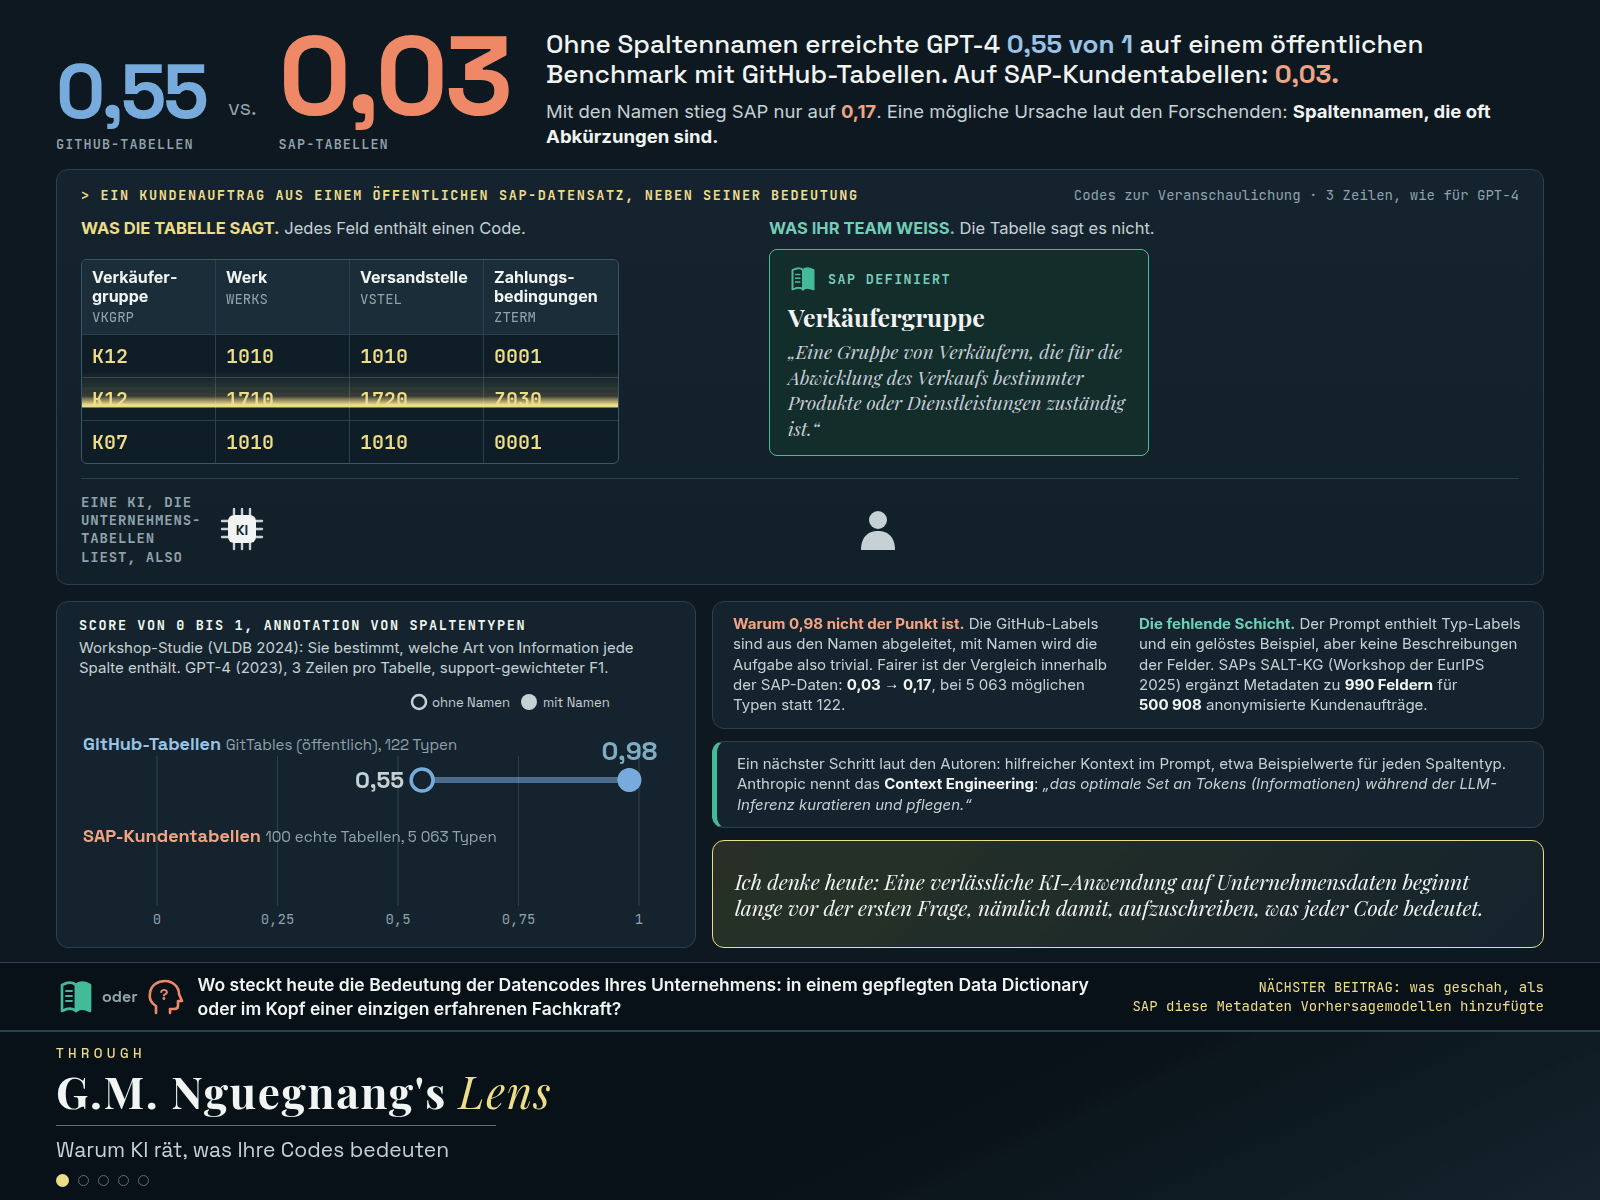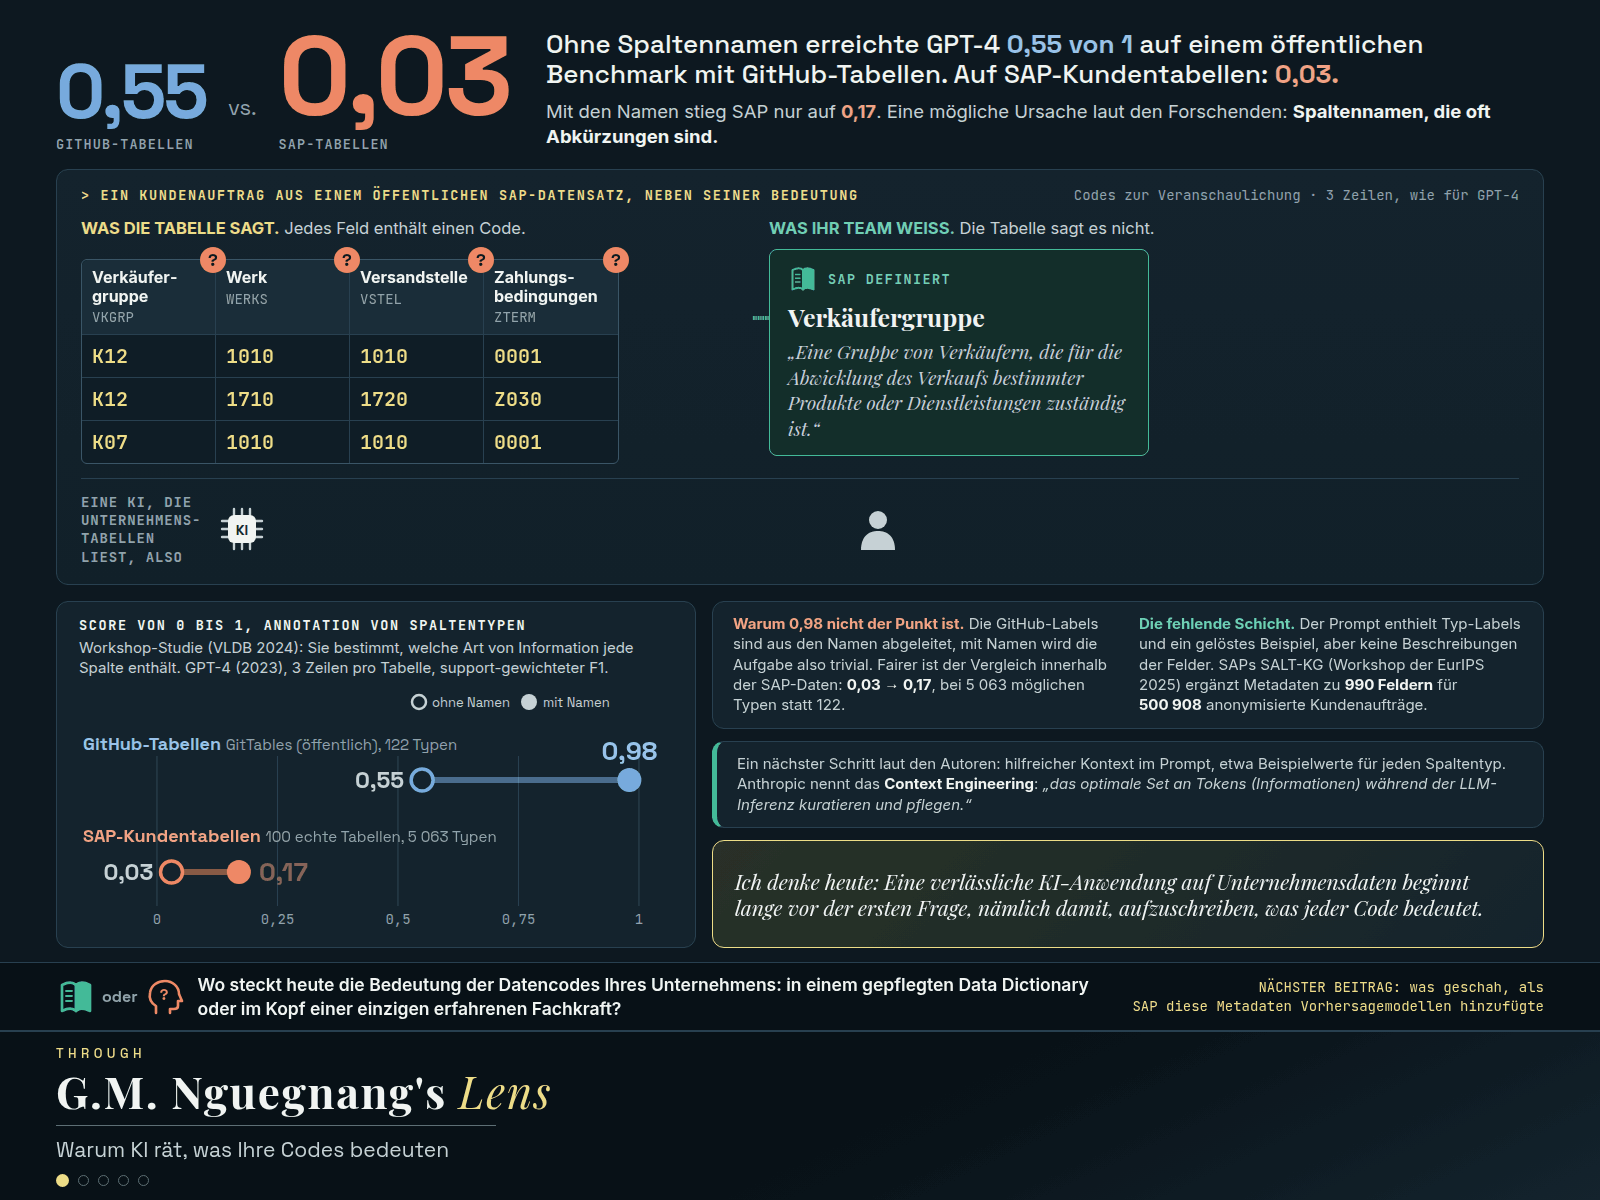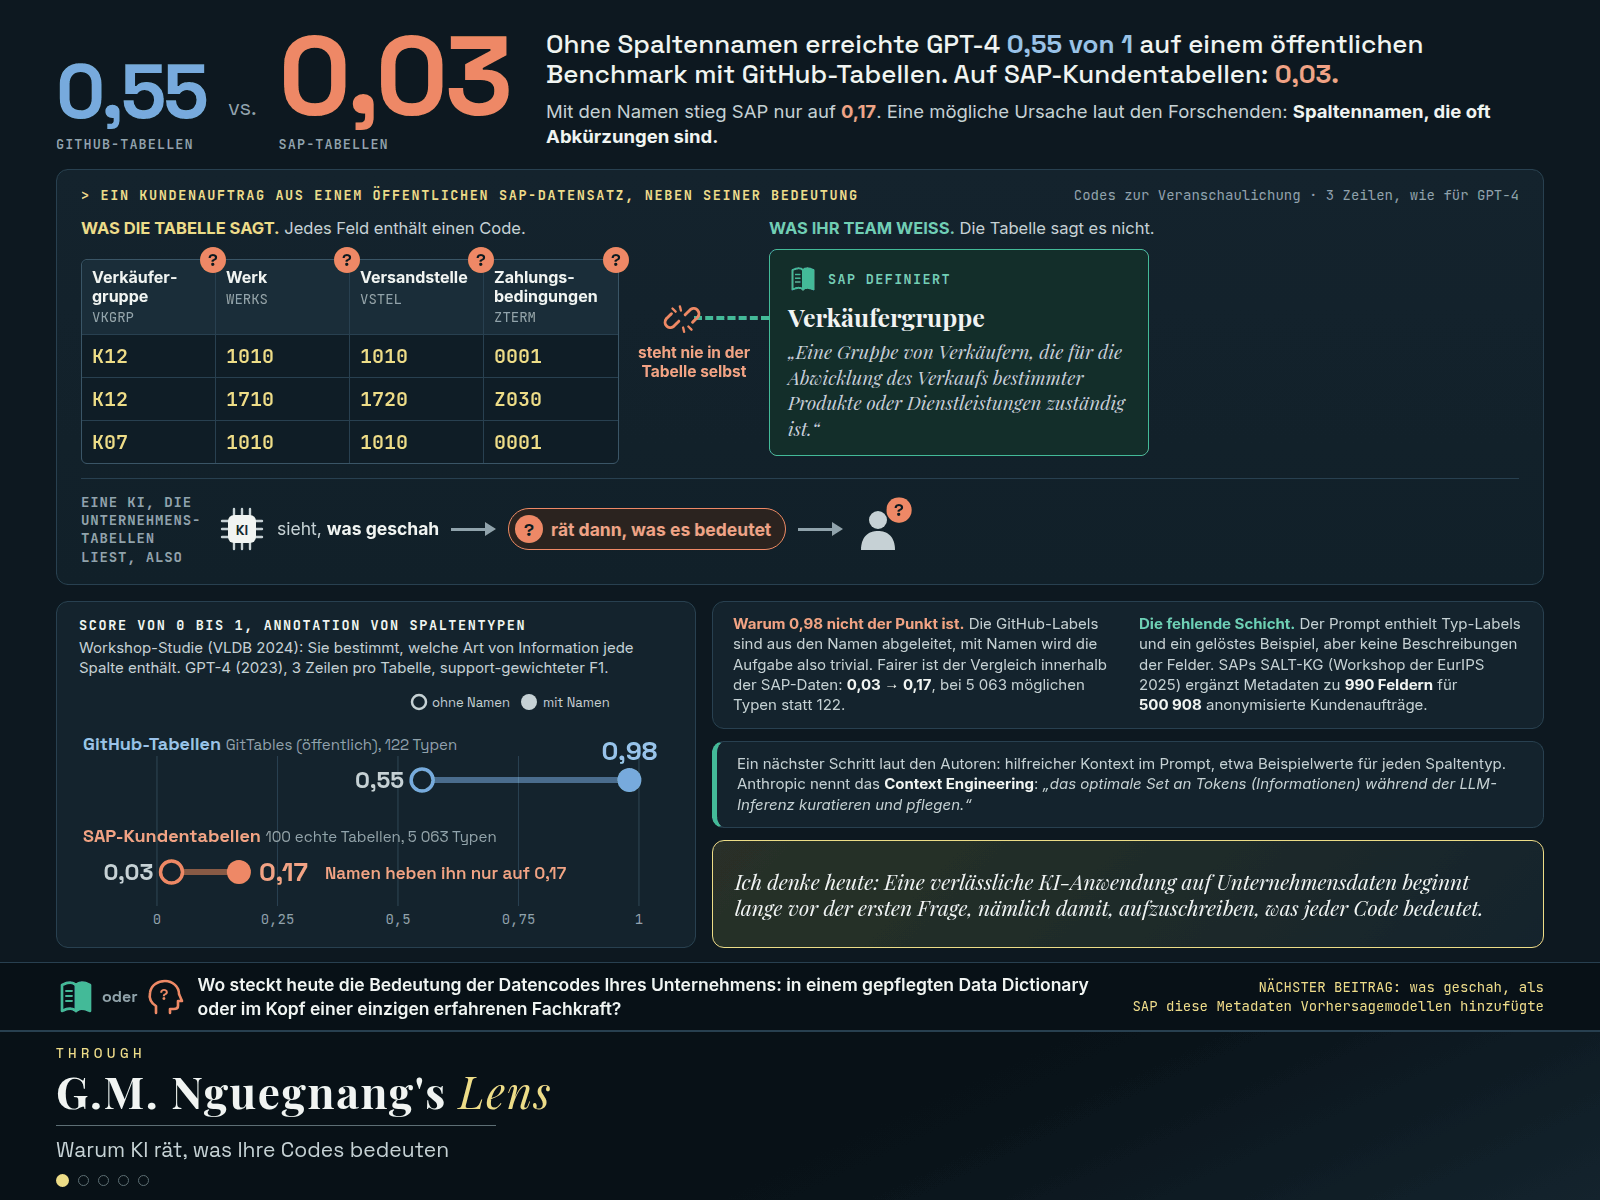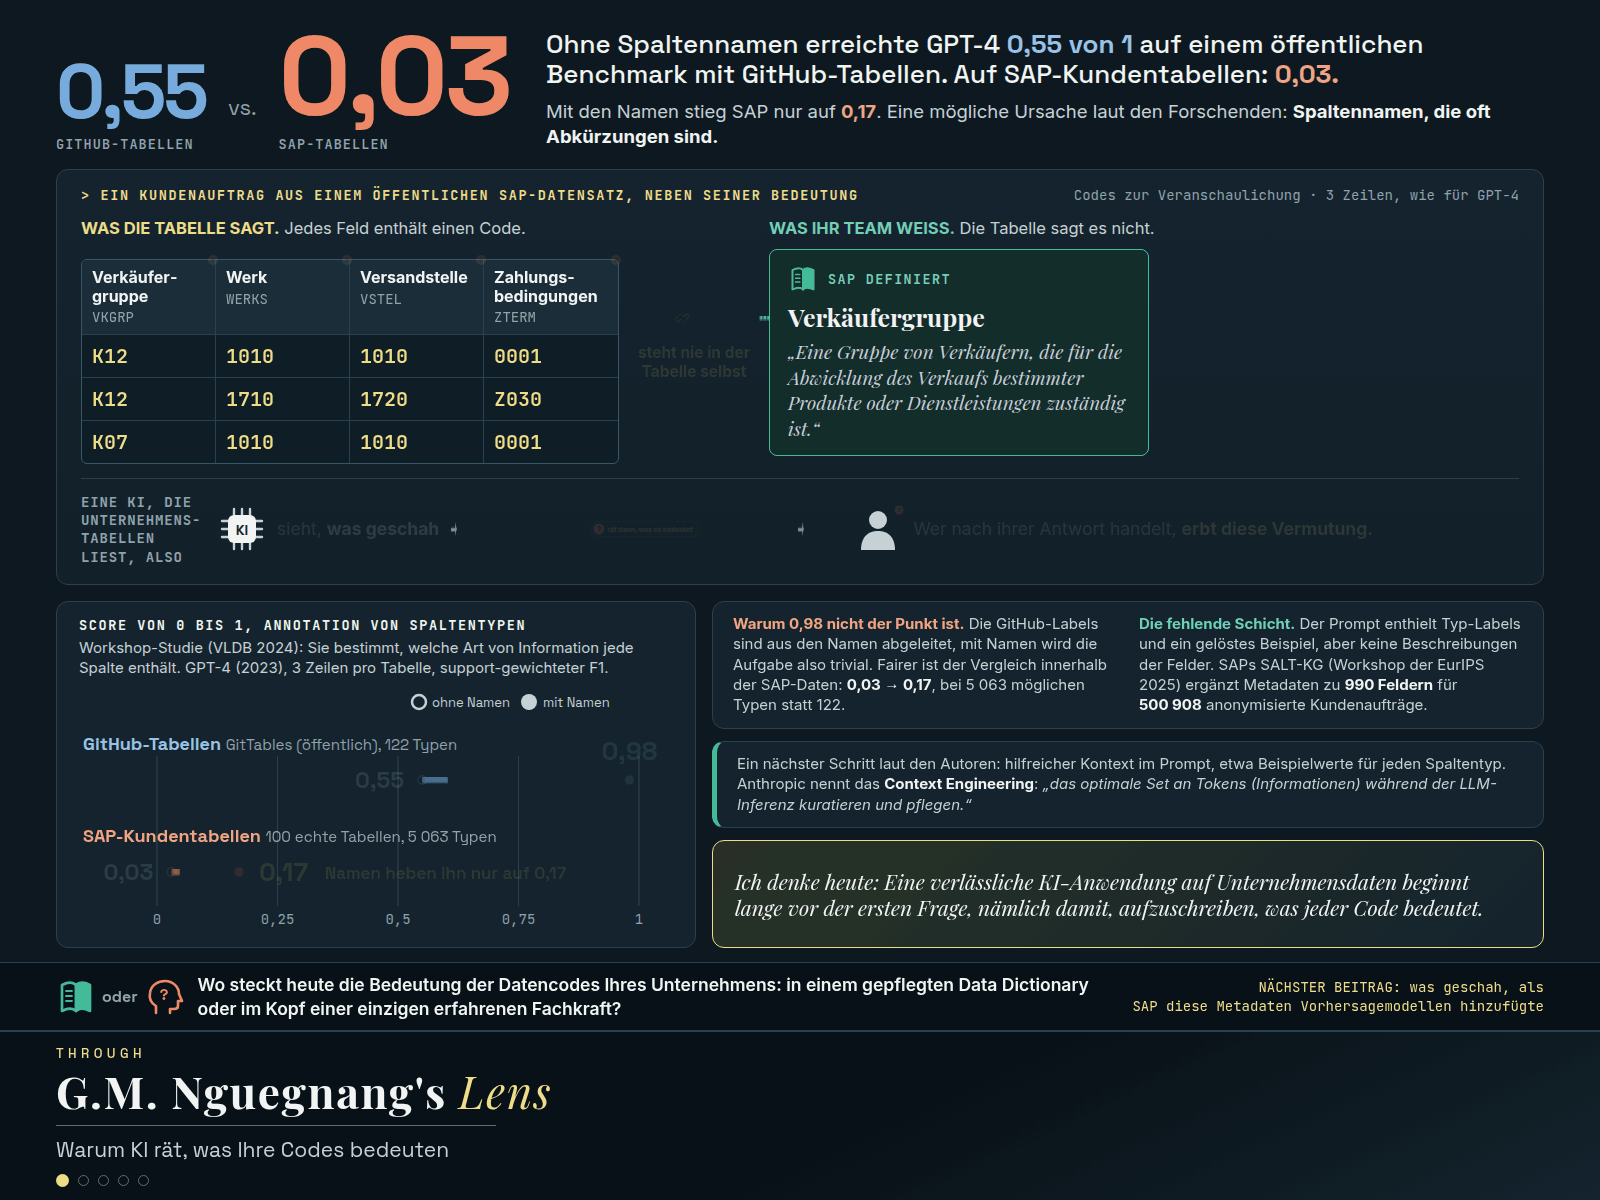
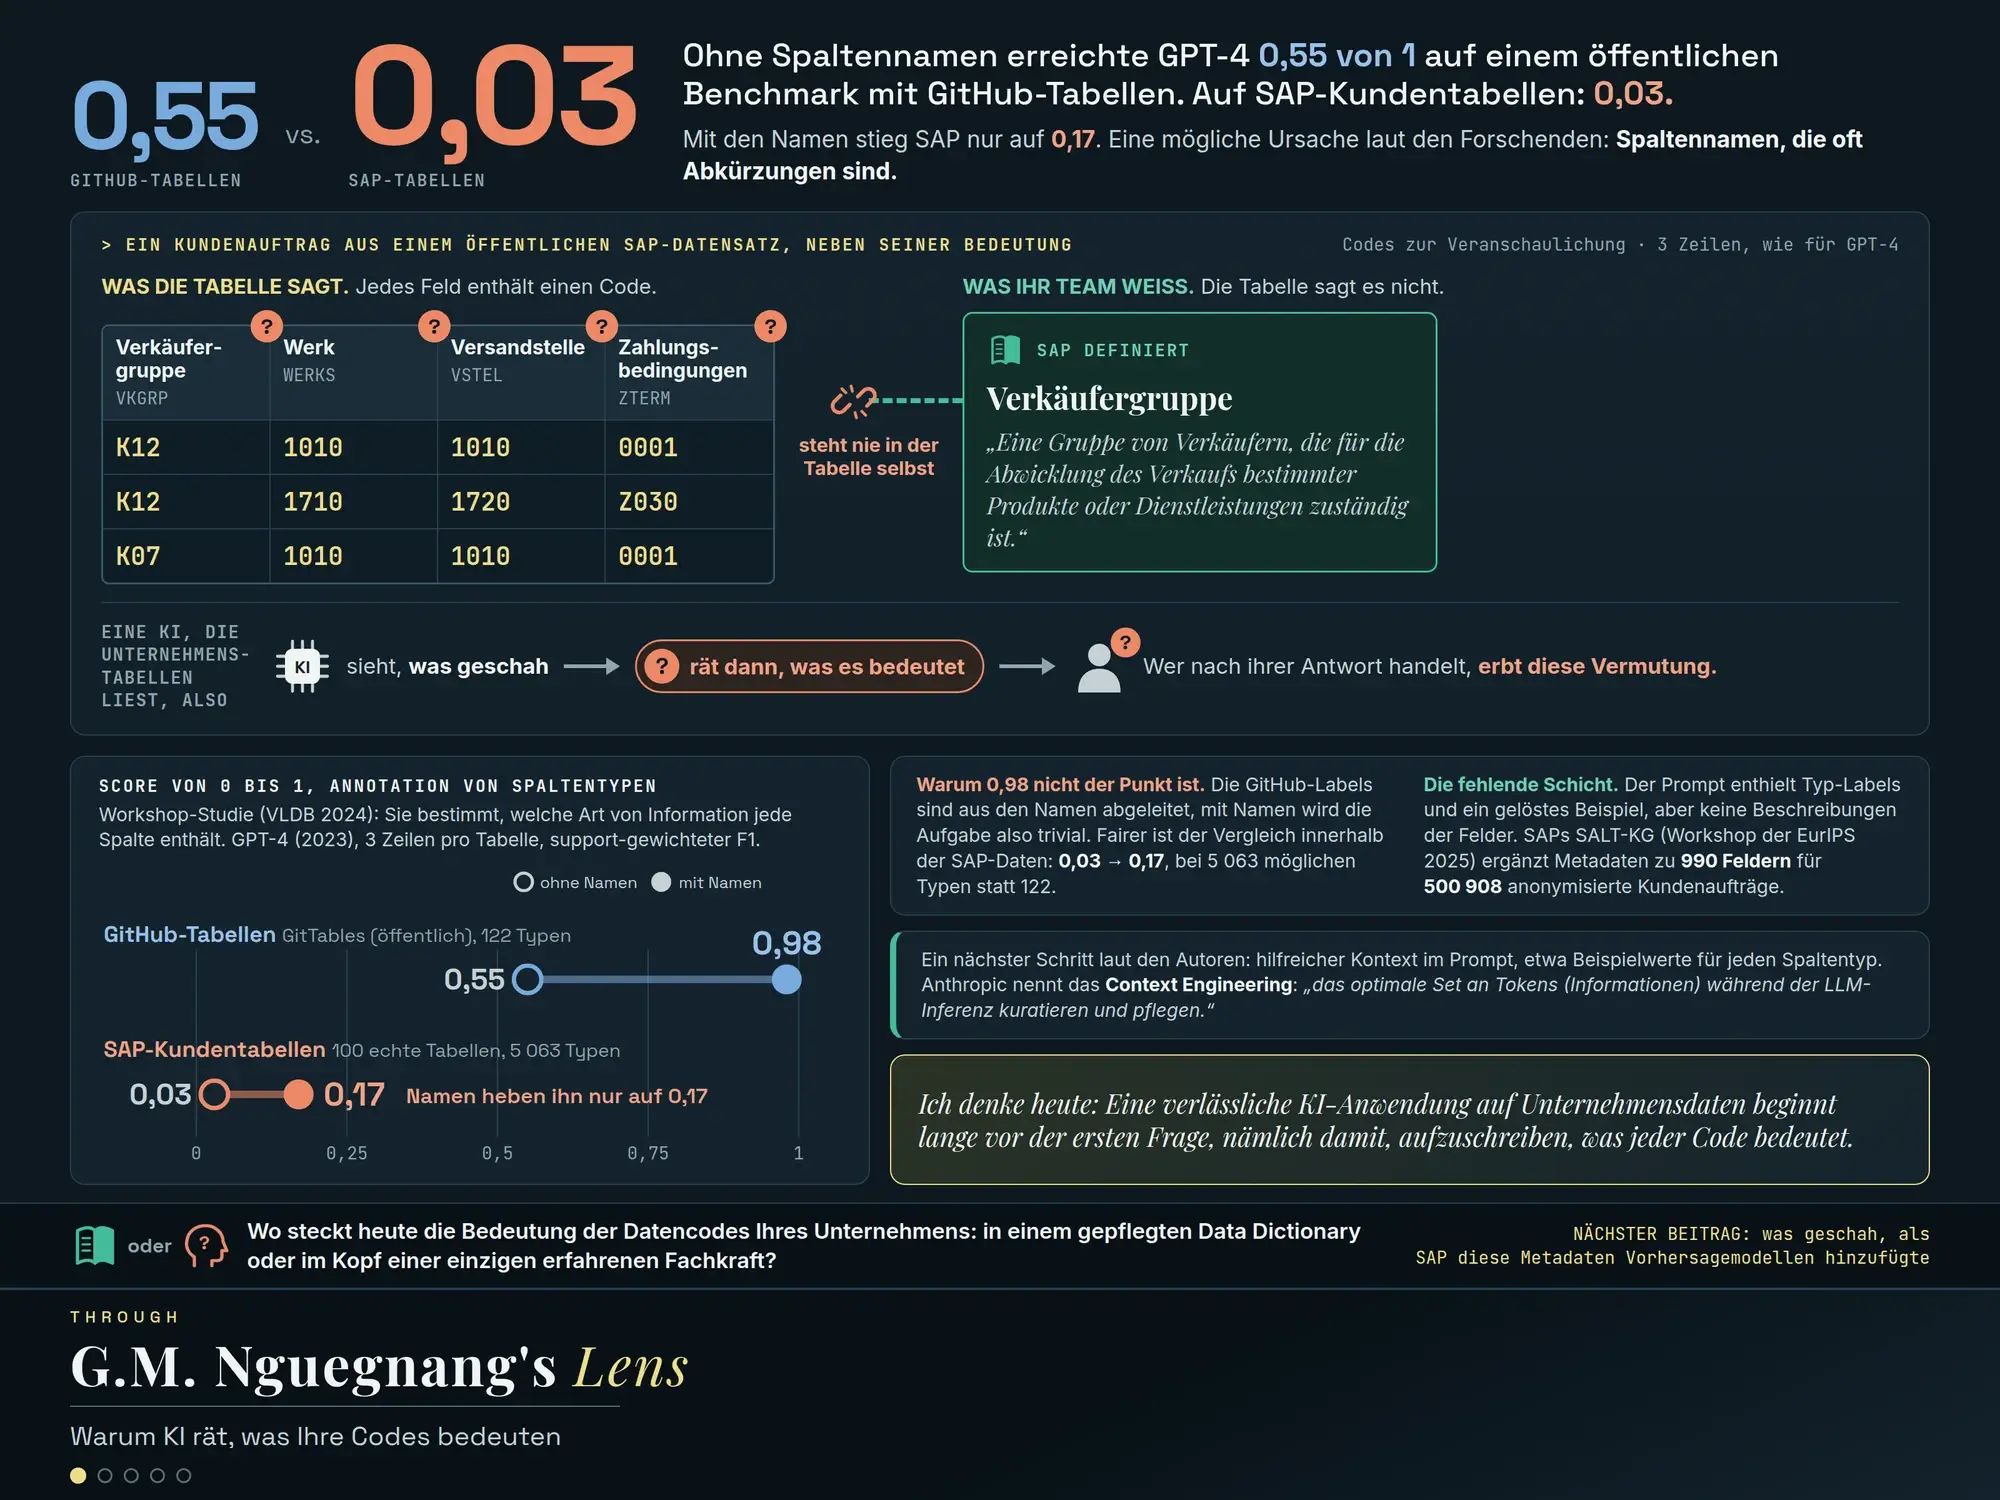
Ohne Spaltennamen erreichte GPT-4 auf GitHub-Tabellen 0,55 von 1. Auf SAP-Kundentabellen: 0,03
Unternehmenstabellen speichern Codes, nicht ihre Bedeutung. Eine Studie zu GPT-4 auf echten SAP-Kundentabellen zeigt, was eine KI daraus macht: Sie sieht, was geschah, und rät dann, was es bedeutet.
-
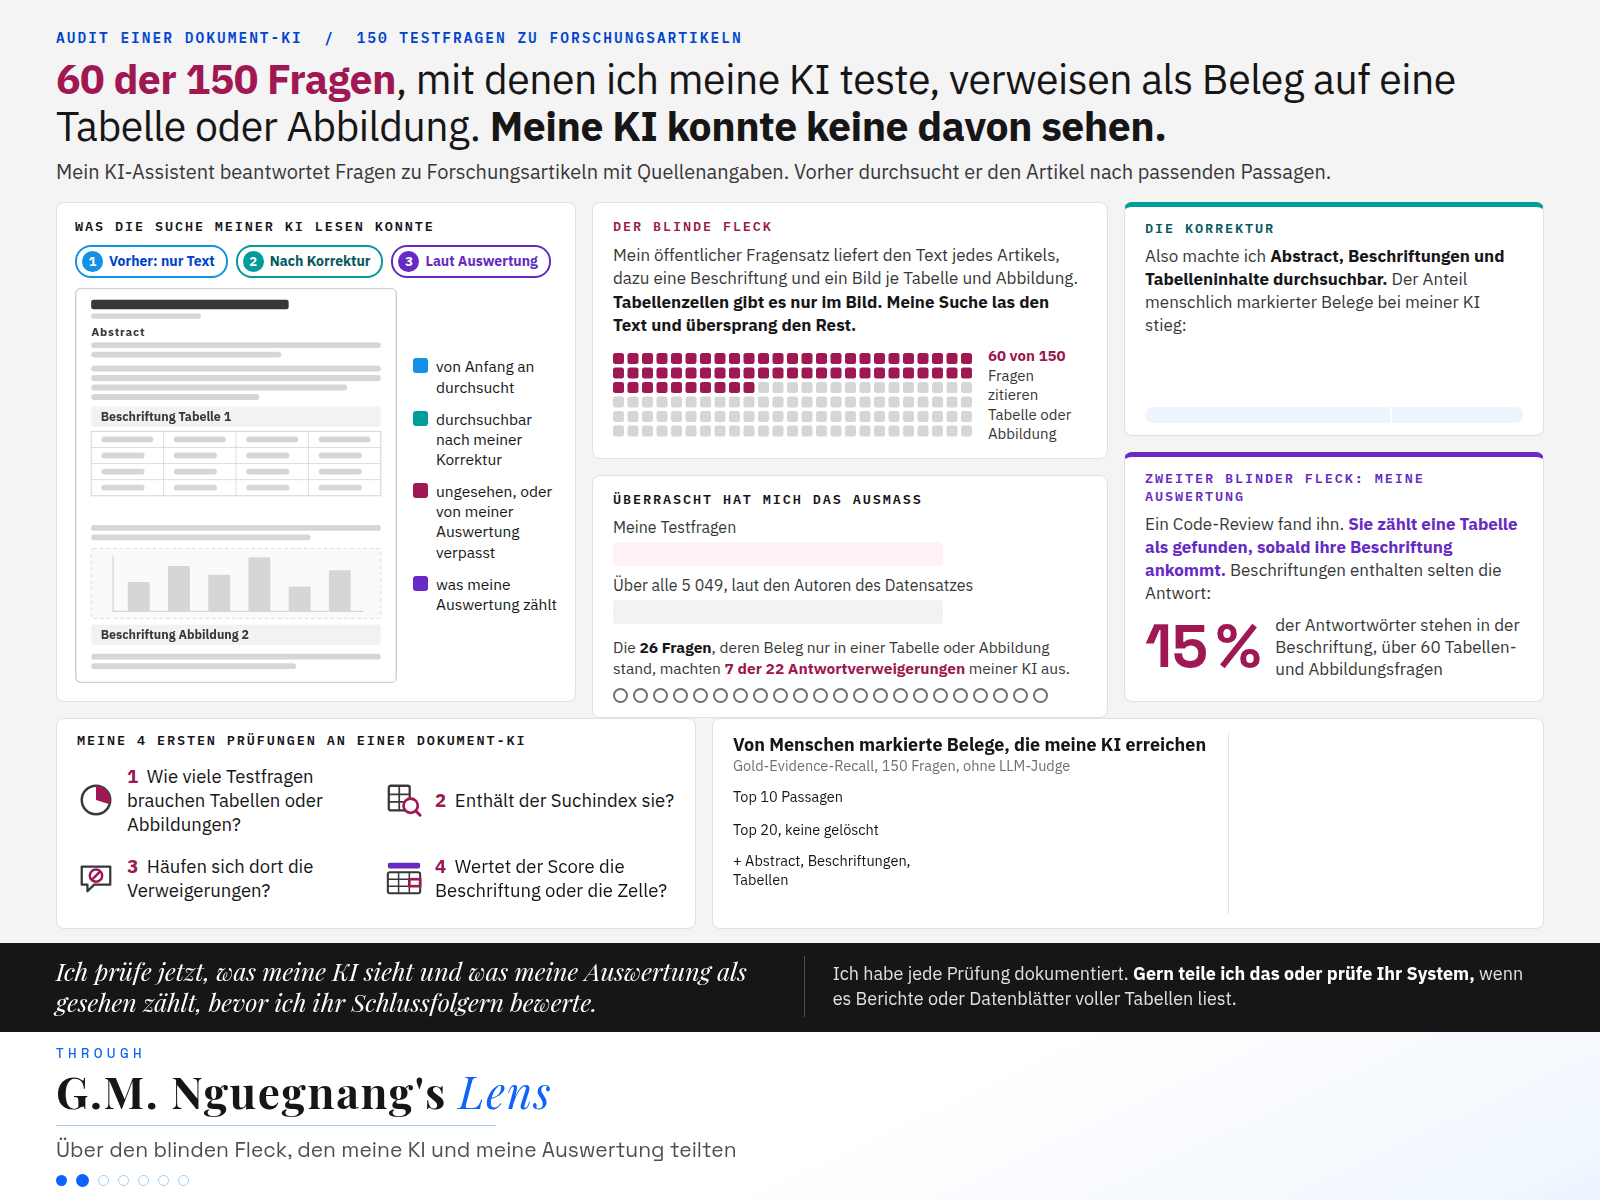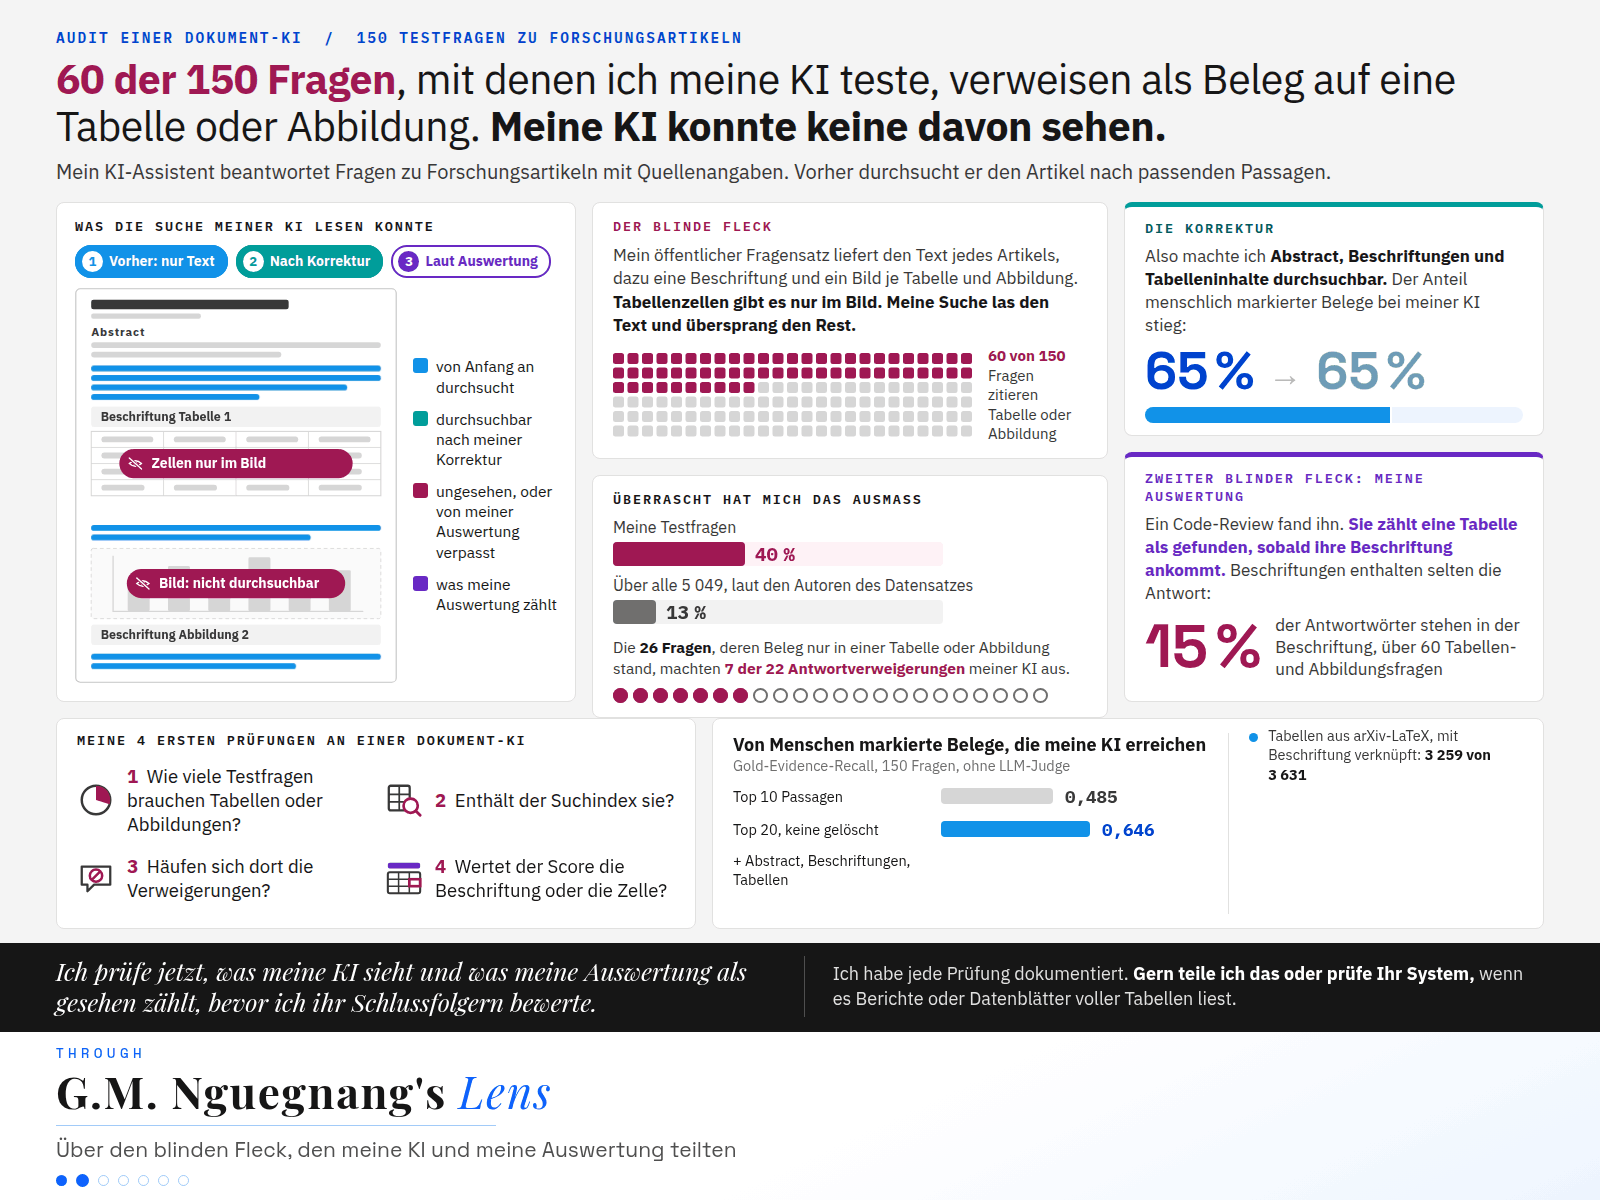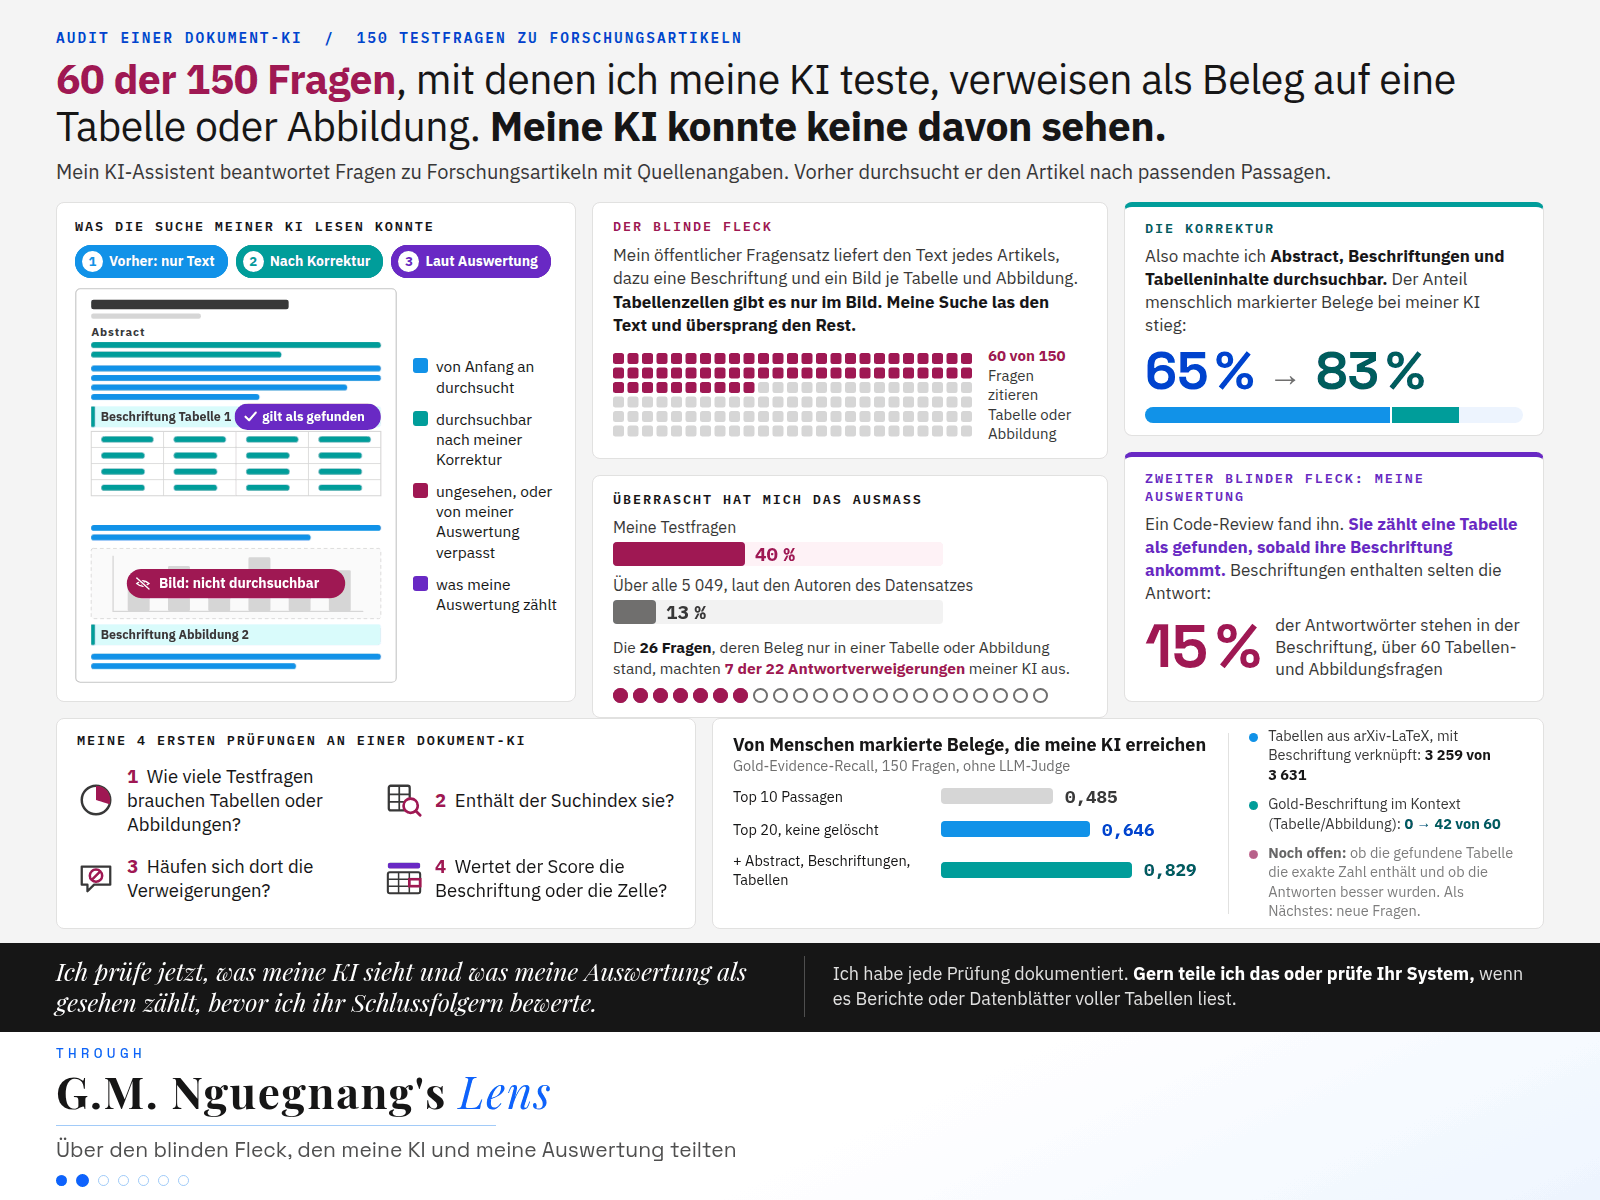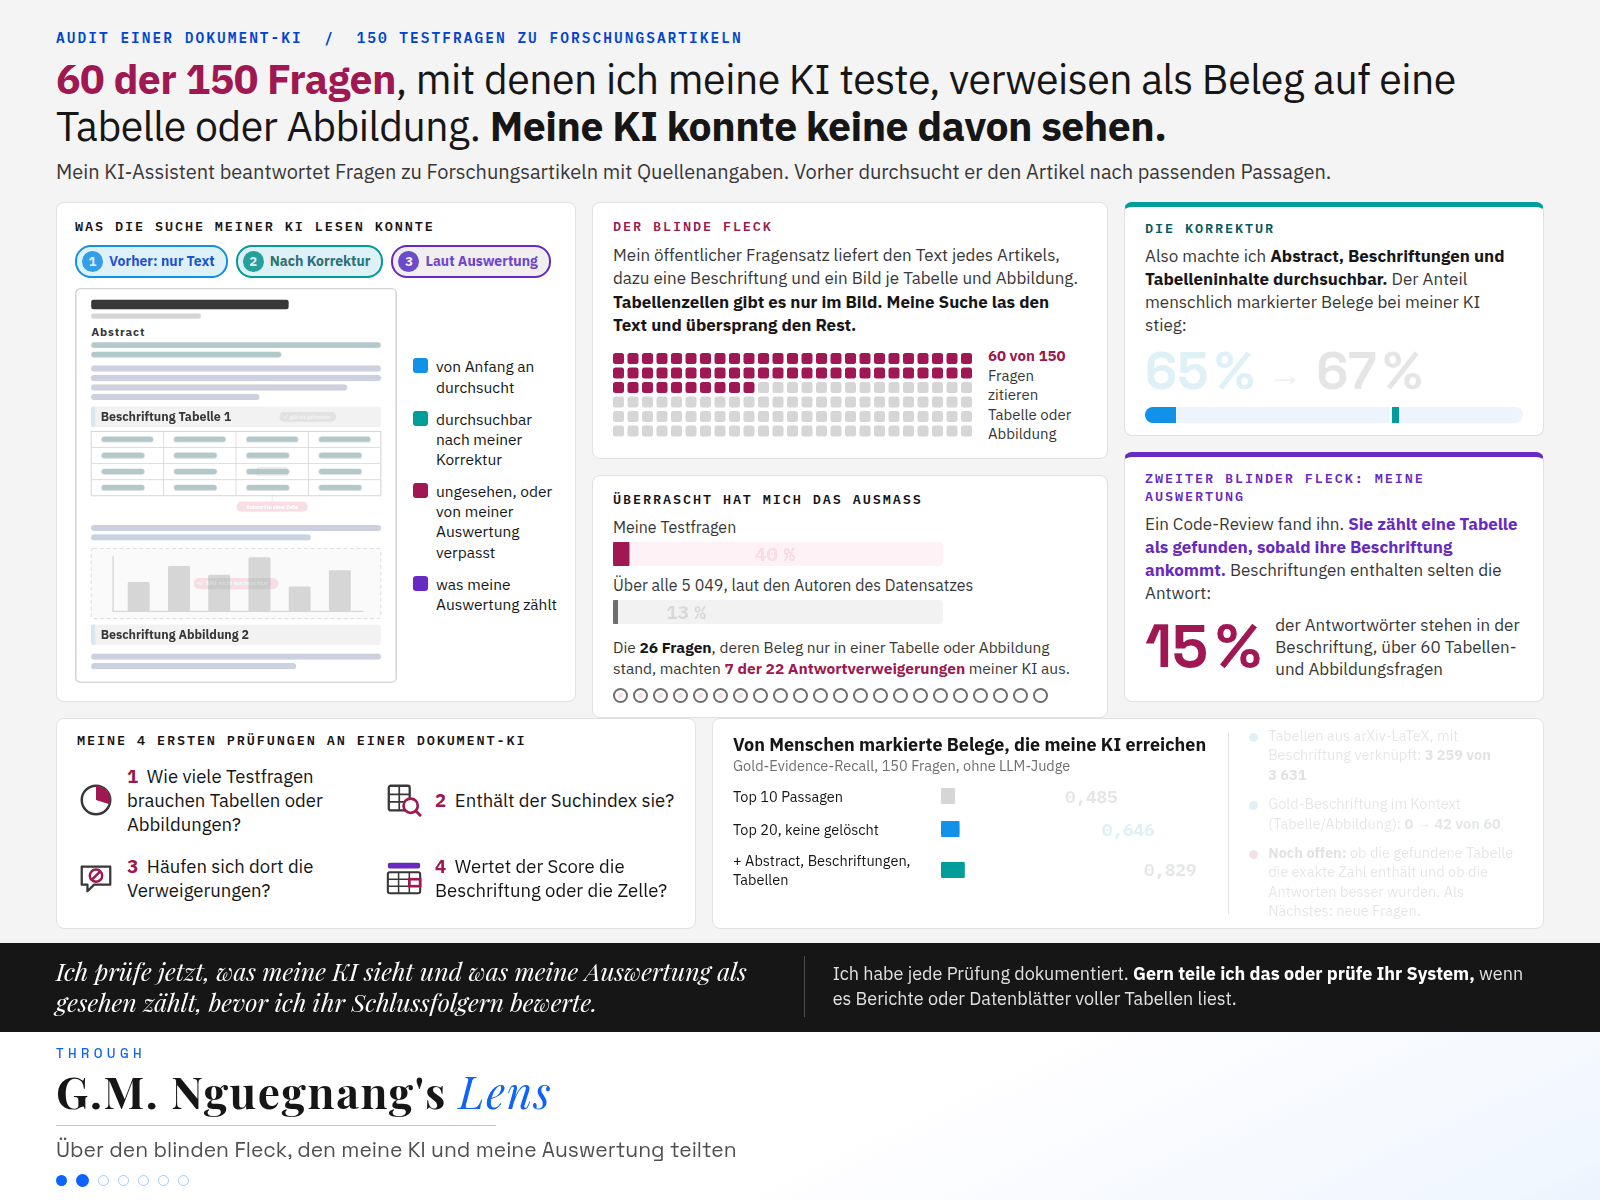
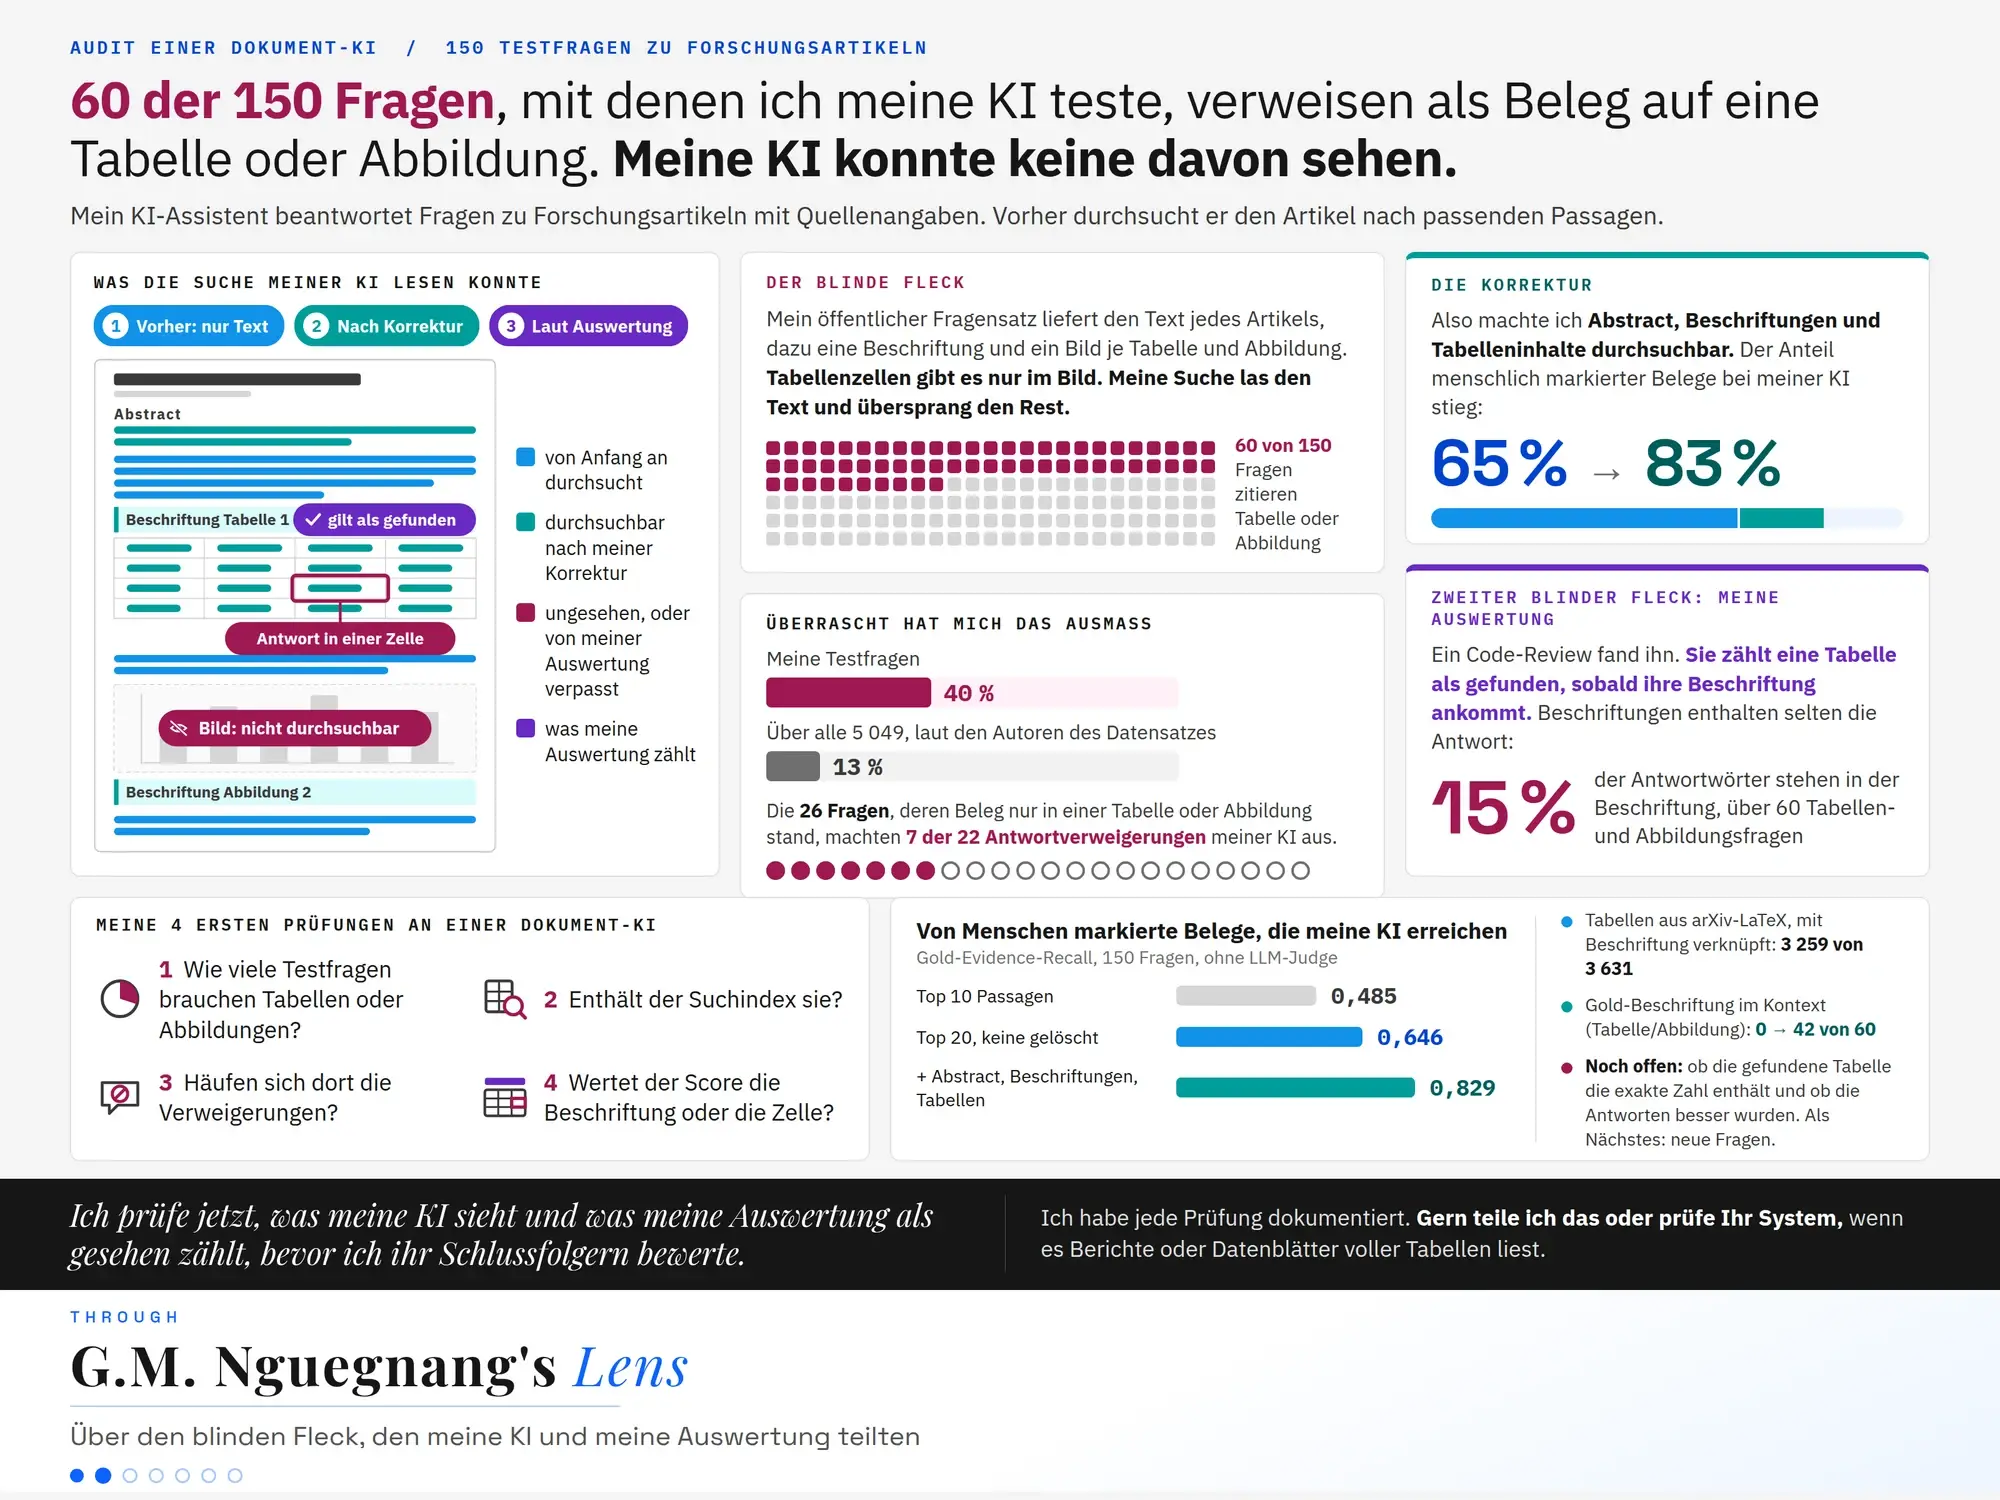
60 der 150 Fragen, mit denen ich meine KI teste, verweisen auf eine Tabelle oder Abbildung. Meine KI konnte keine davon sehen
Mein KI-Assistent durchsucht Forschungsartikel, bevor er antwortet, und seine Suche übersprang jede Tabelle und Abbildung. Die Korrektur deckte einen zweiten blinden Fleck auf, in der Auswertung, mit der ich ihn bewerte.
-
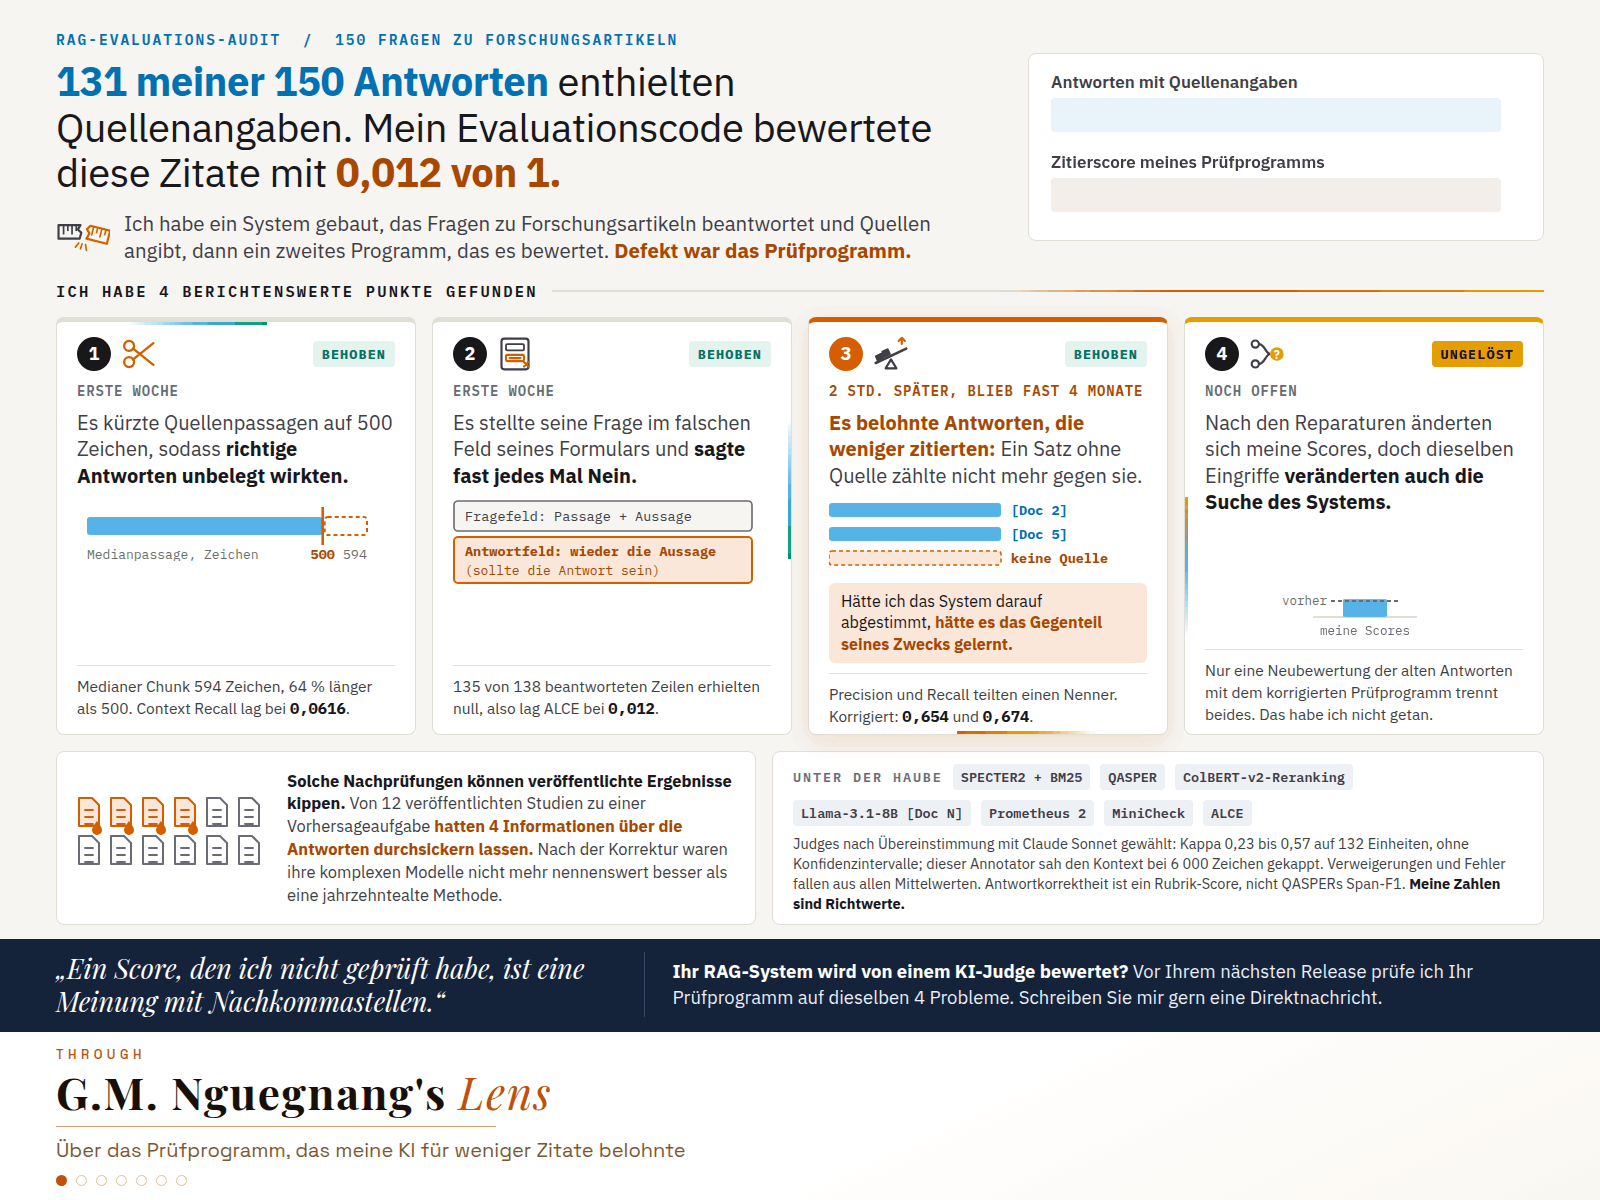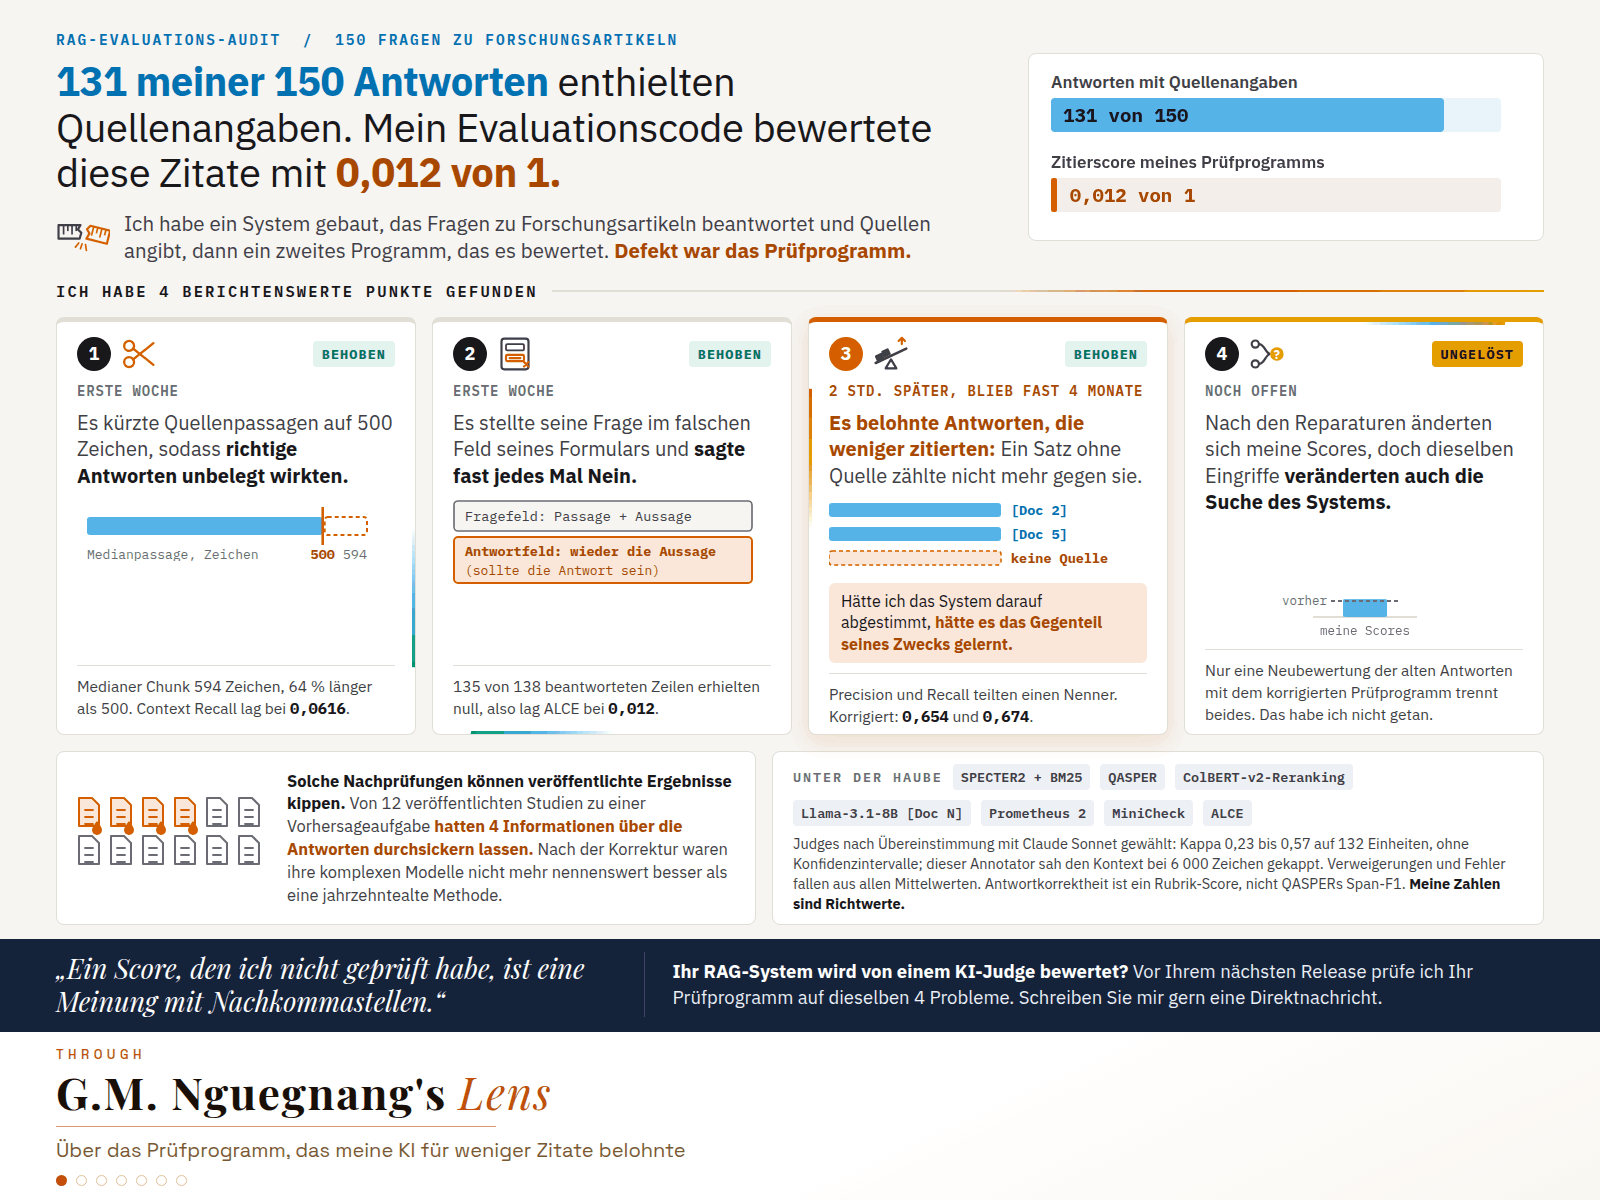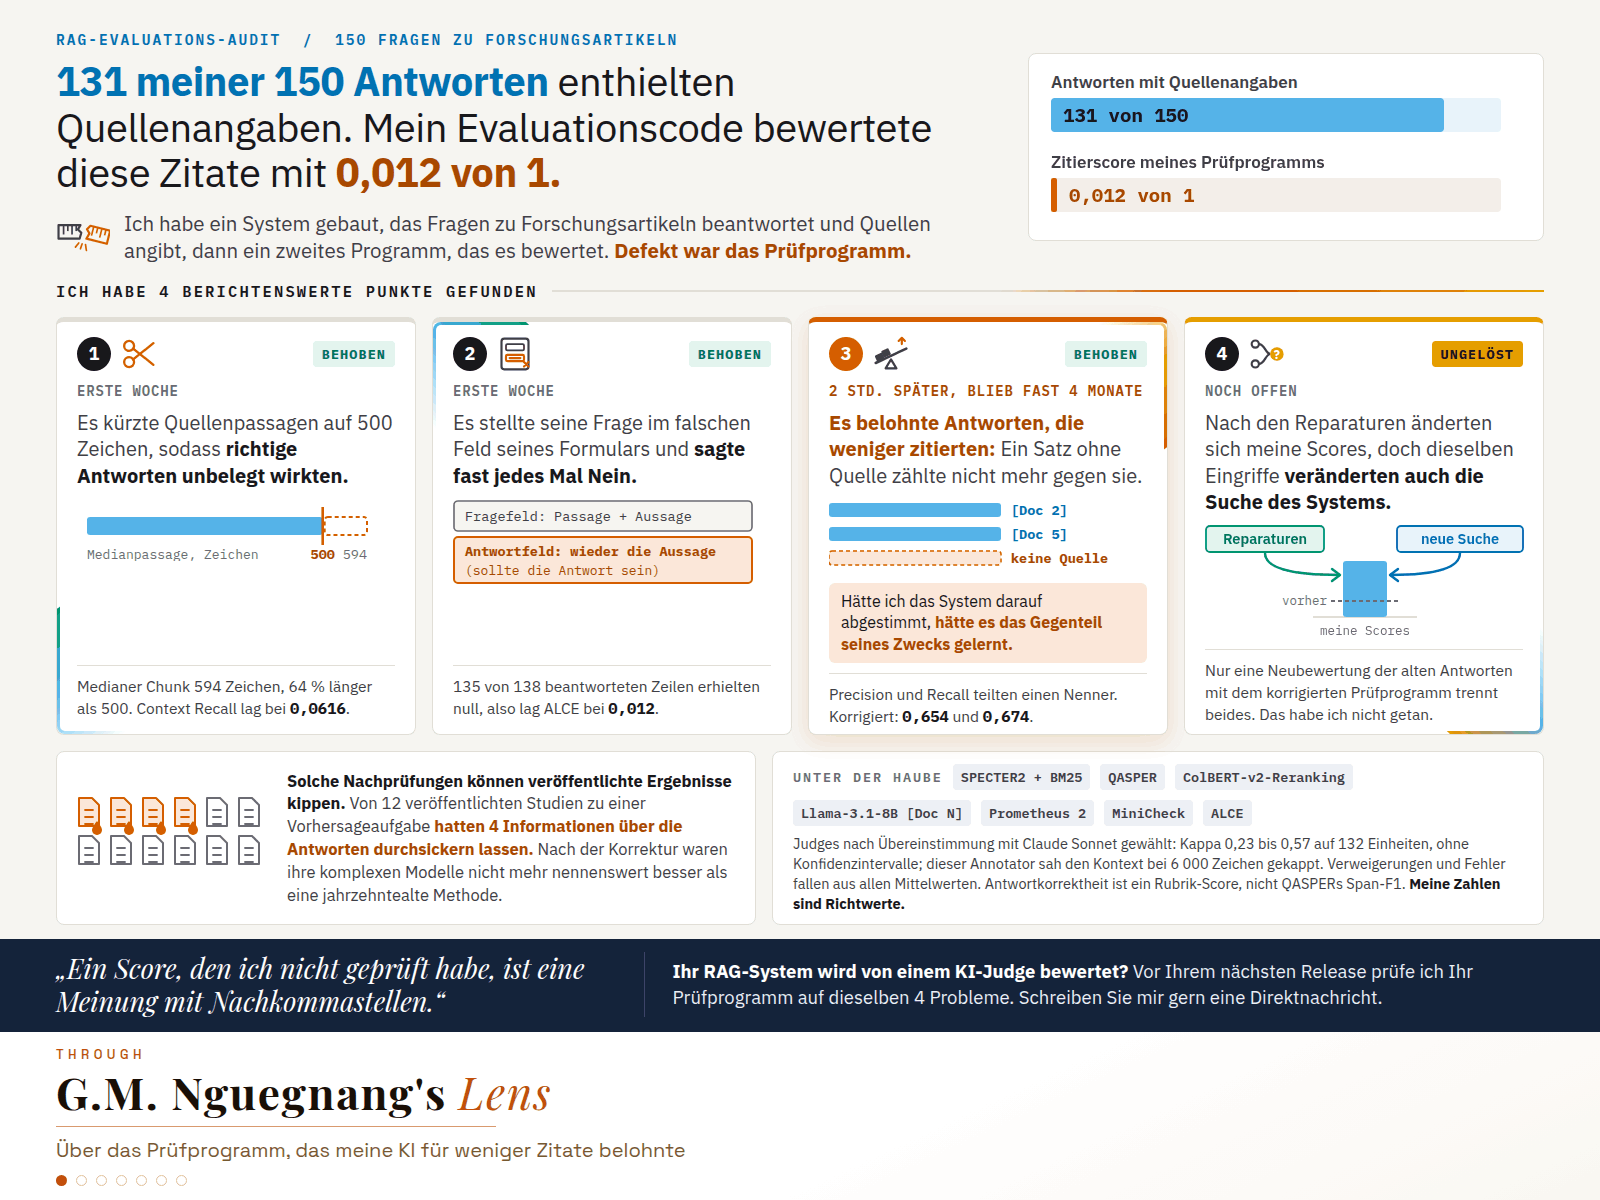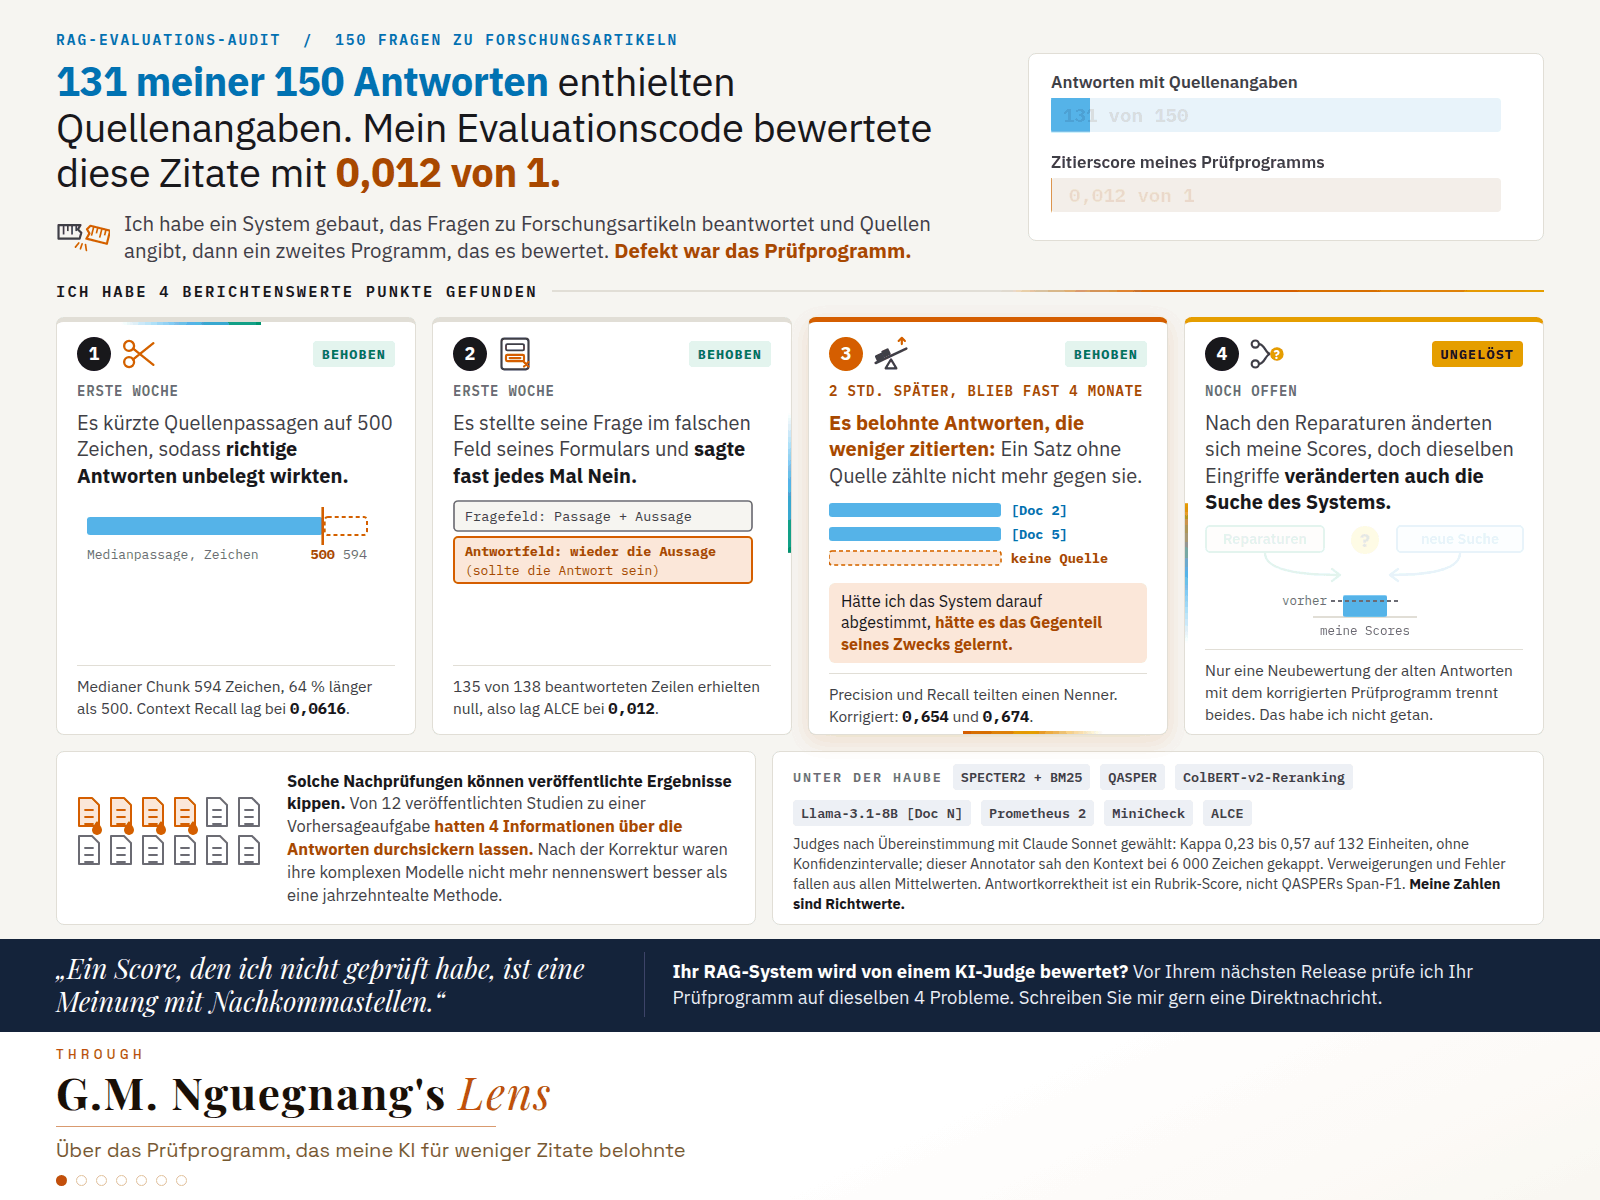
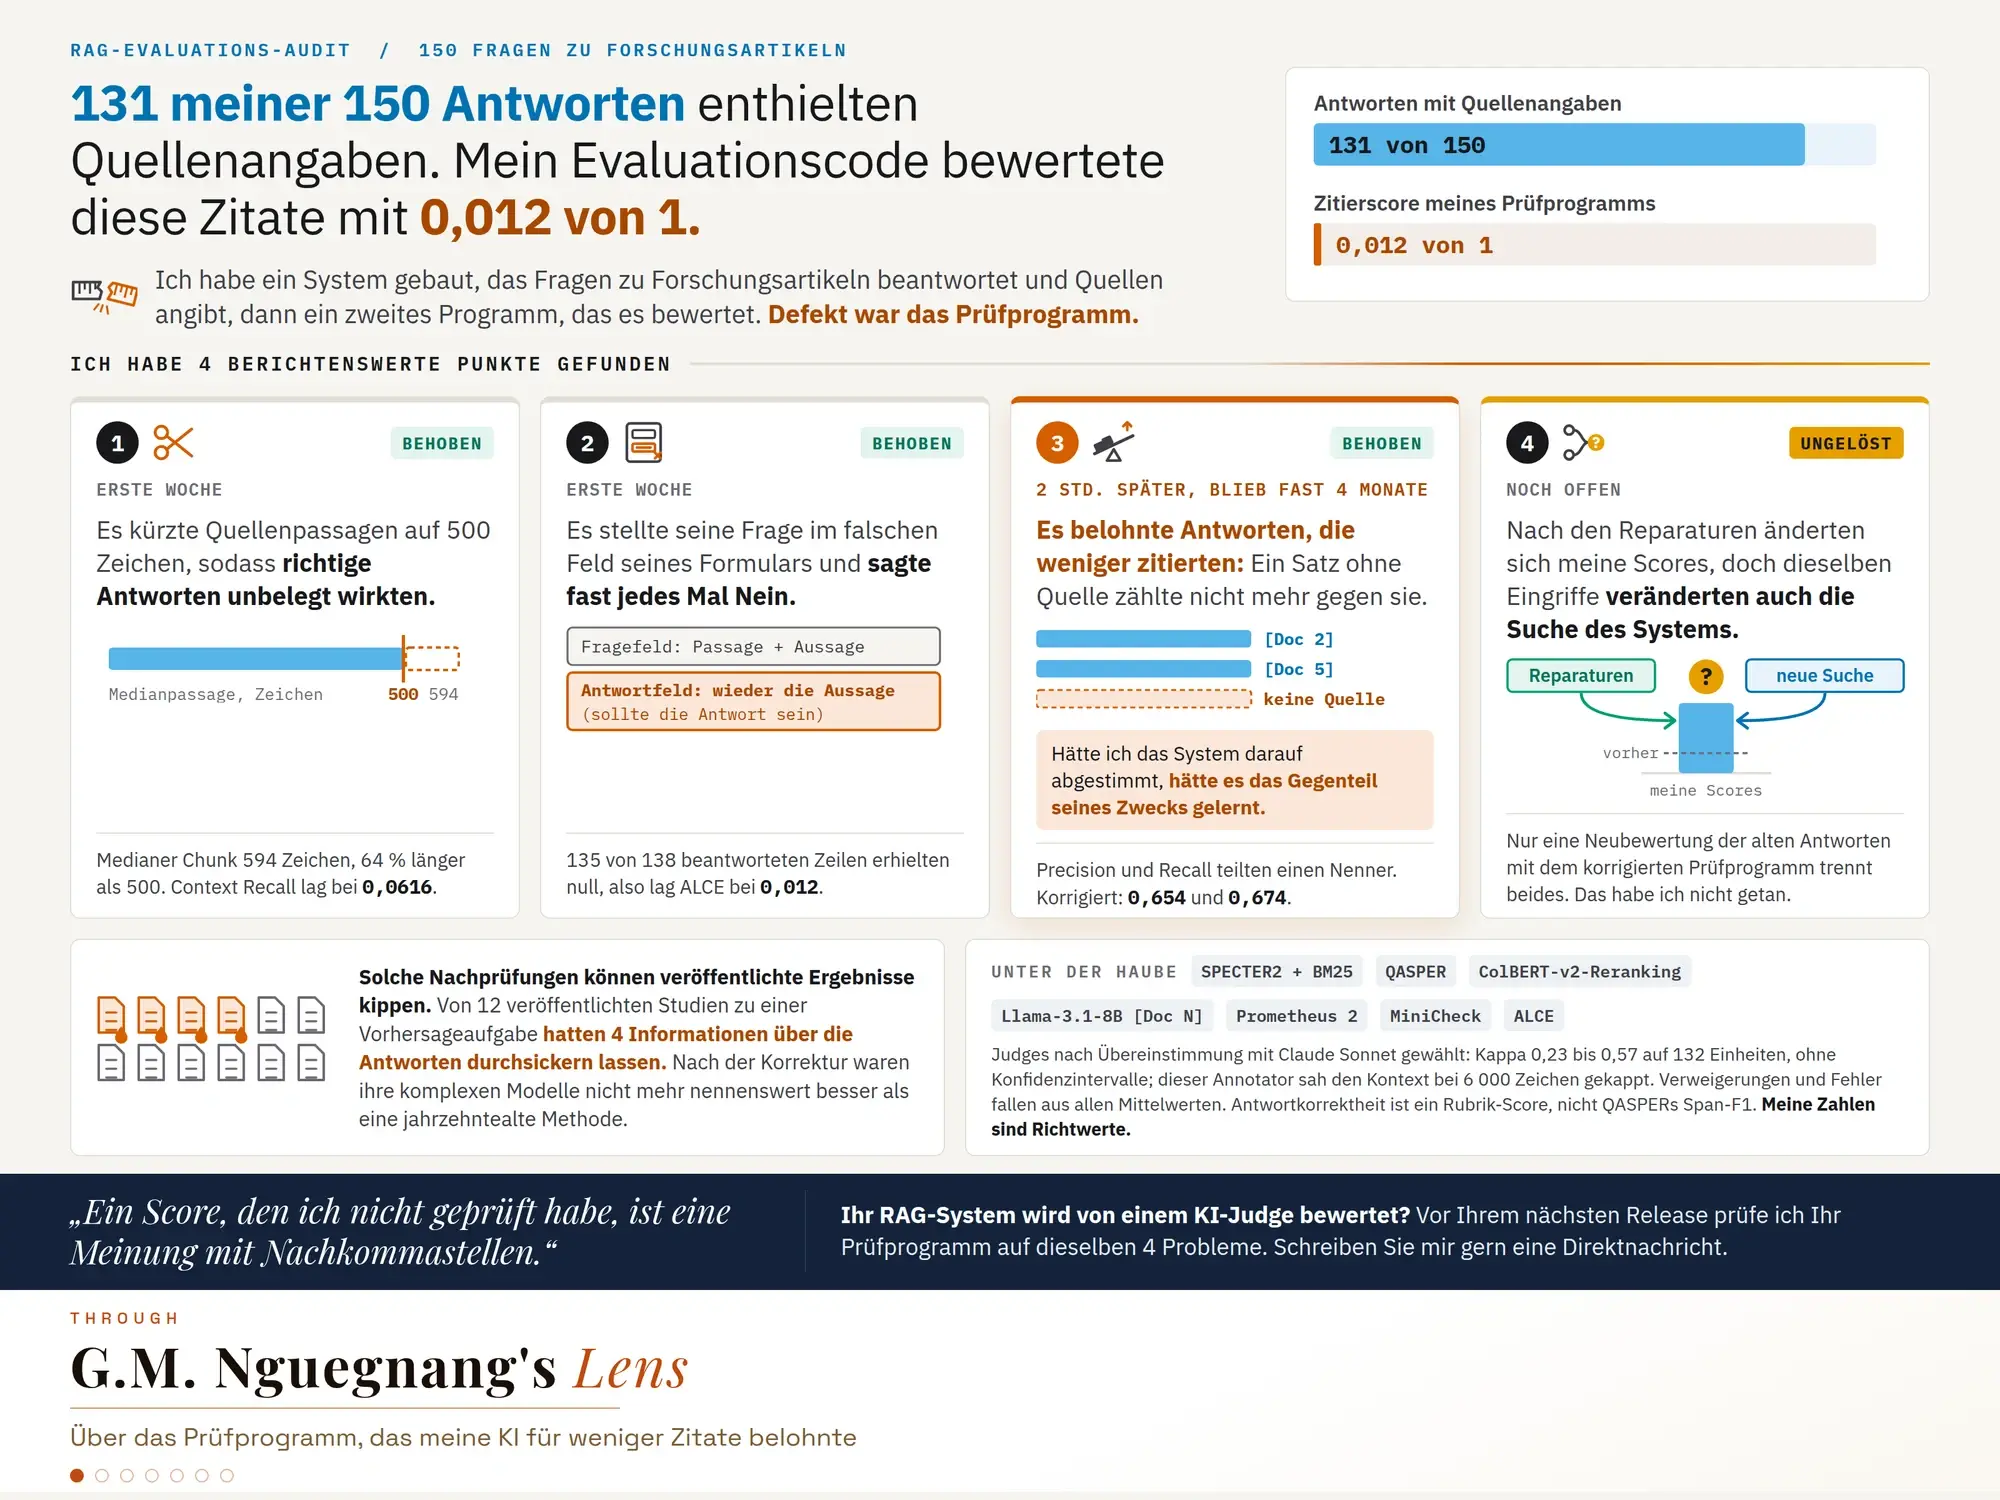
131 meiner 150 Antworten enthielten Quellenangaben. Mein Prüfprogramm bewertete sie mit 0,012 von 1
Ich habe ein System gebaut, das Fragen zu Forschungsartikeln beantwortet und seine Quellen angibt, dann ein zweites Programm, das es bewertet. Defekt war das Prüfprogramm: Ich fand 4 Probleme, behob 3, und eines ist noch offen.
-
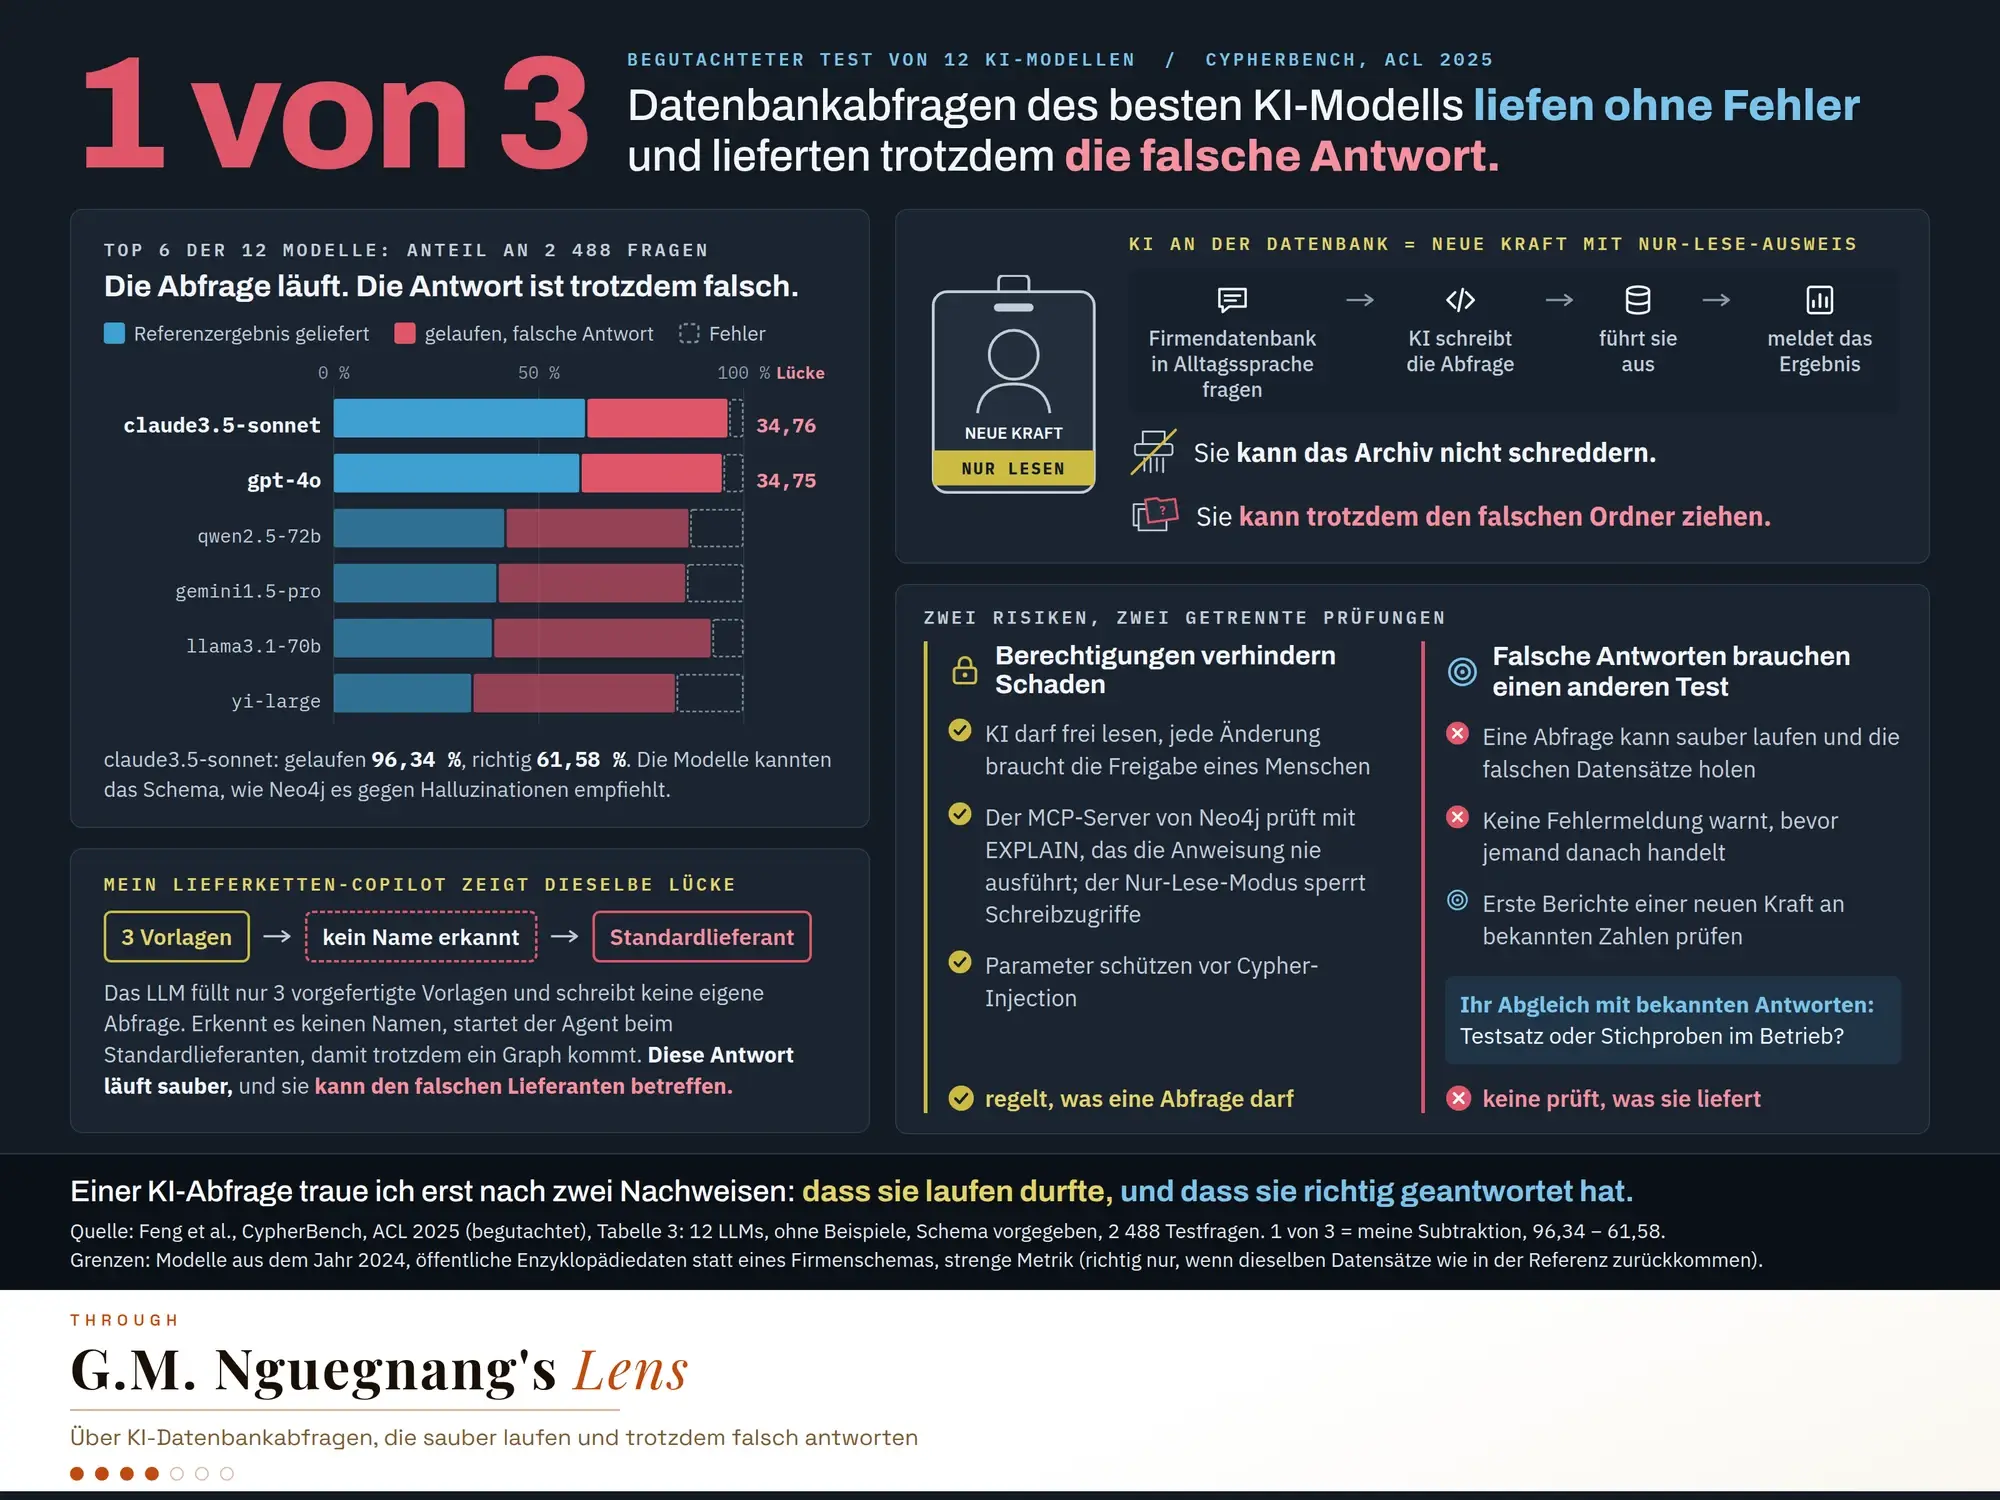
1 von 3: KI-Datenbankabfragen, die fehlerfrei laufen und trotzdem falsch antworten
Ein begutachteter Test von 12 KI-Modellen: Die Abfragen des besten Modells liefen fast immer, doch etwa 1 von 3 lieferte trotzdem die falsche Antwort. Berechtigungen verhindern Schaden. Eine falsche Antwort erkennen sie nicht.
-
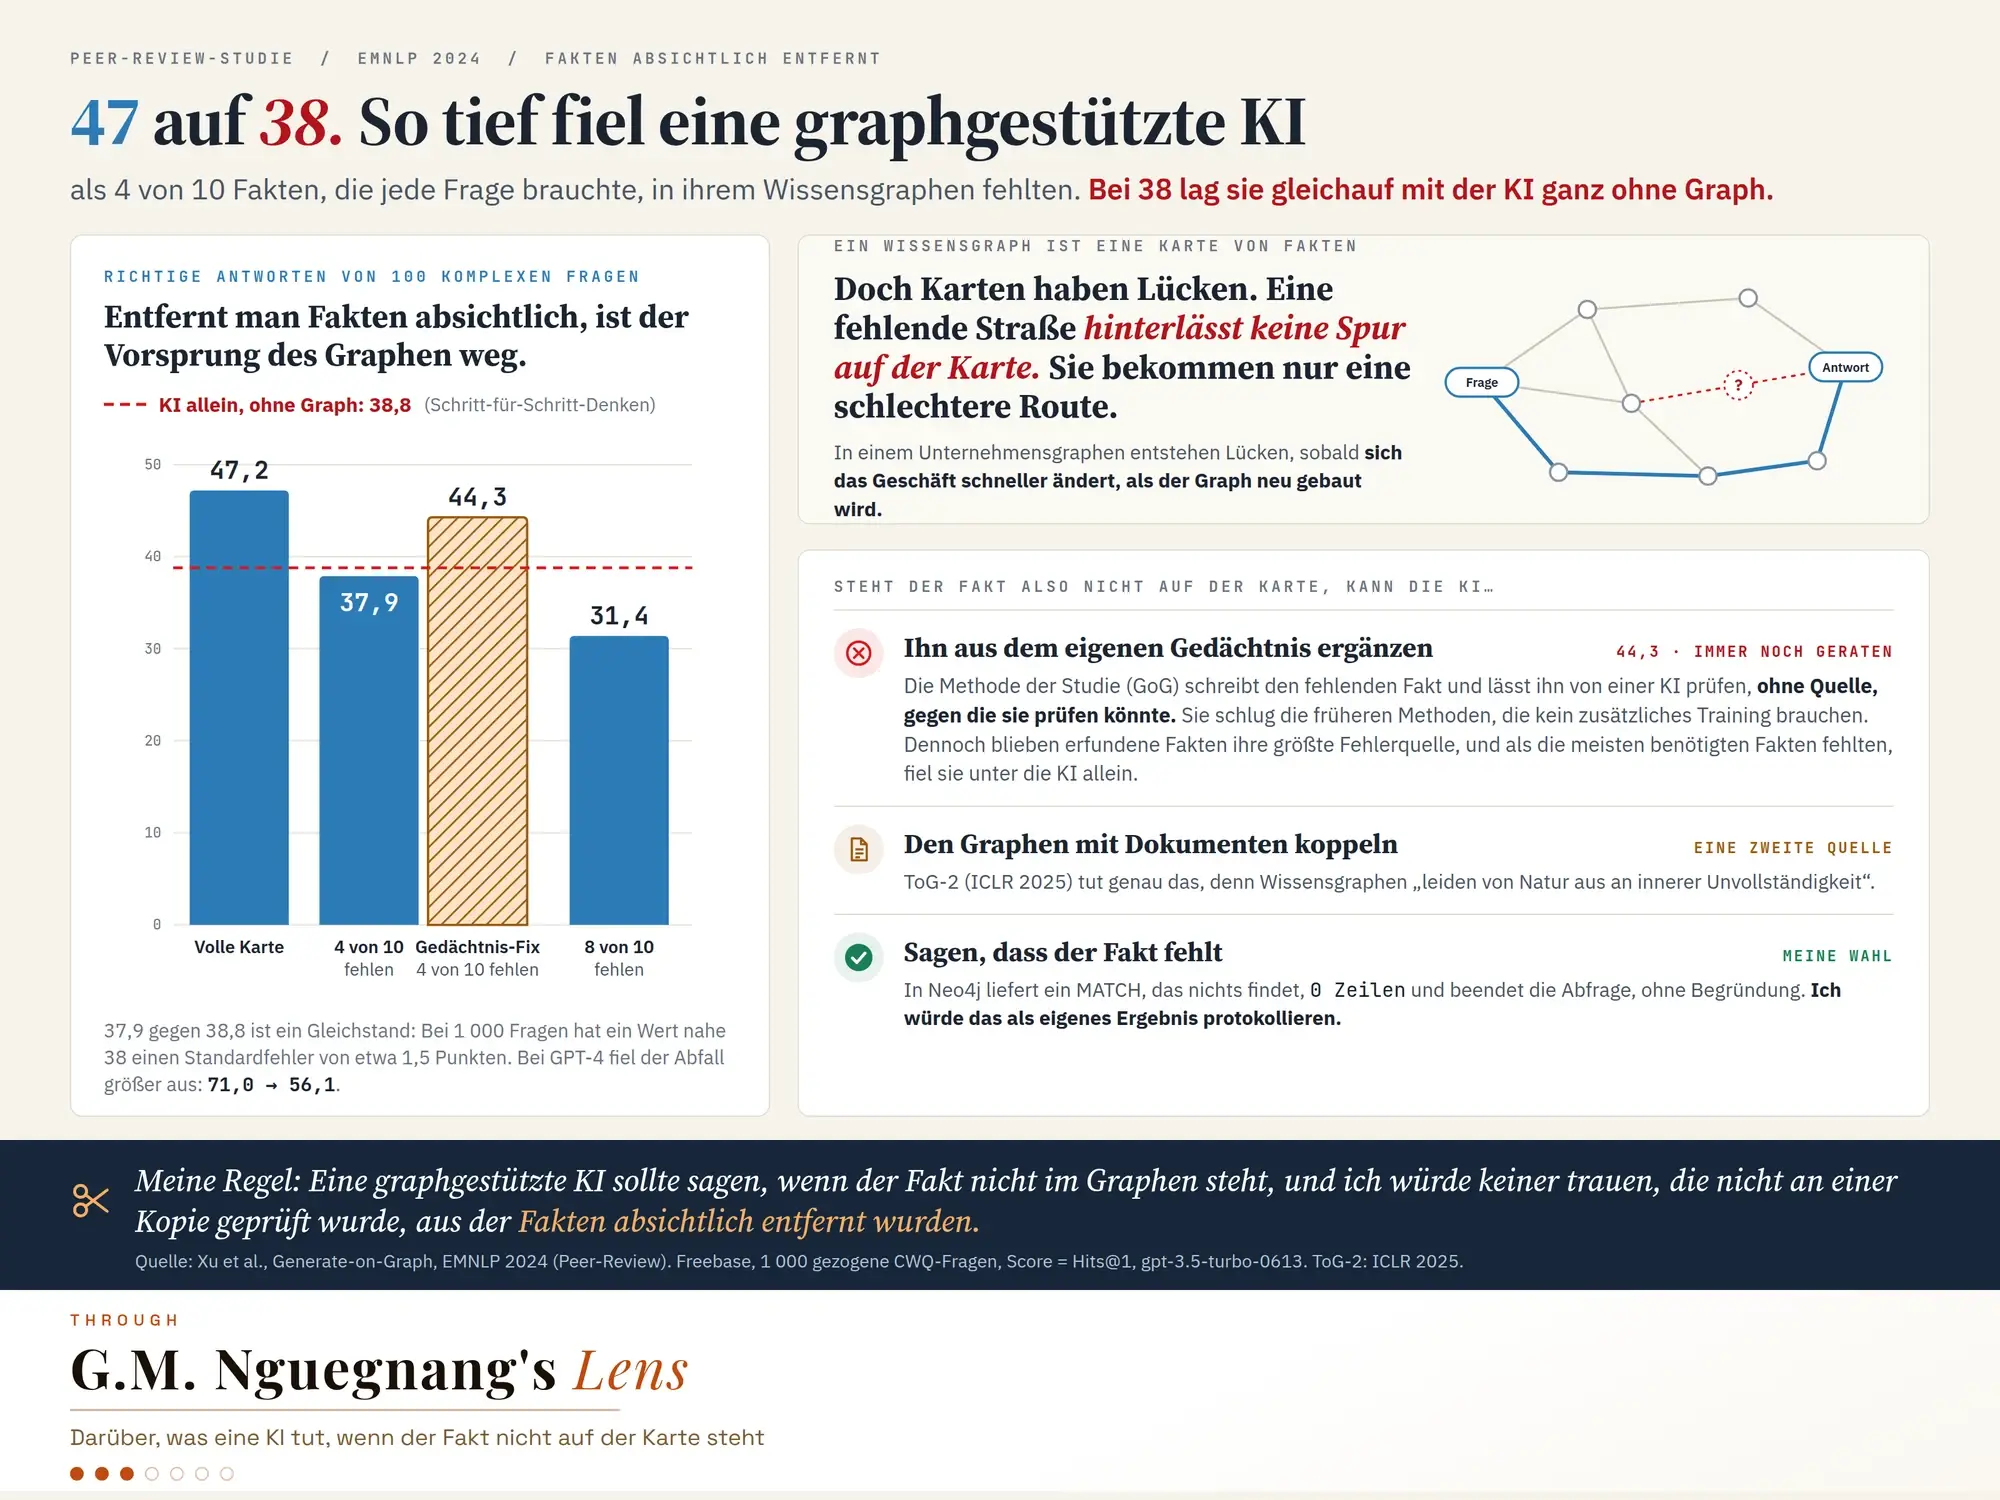
47 auf 38: So tief fiel eine graphgestützte KI ohne ihre Fakten
Eine begutachtete Studie entfernte absichtlich Fakten aus einem Wissensgraphen. Mit 4 von 10 benötigten Fakten weniger erreichte das graphgestützte System genau den Wert des Modells ganz ohne Graph.
-
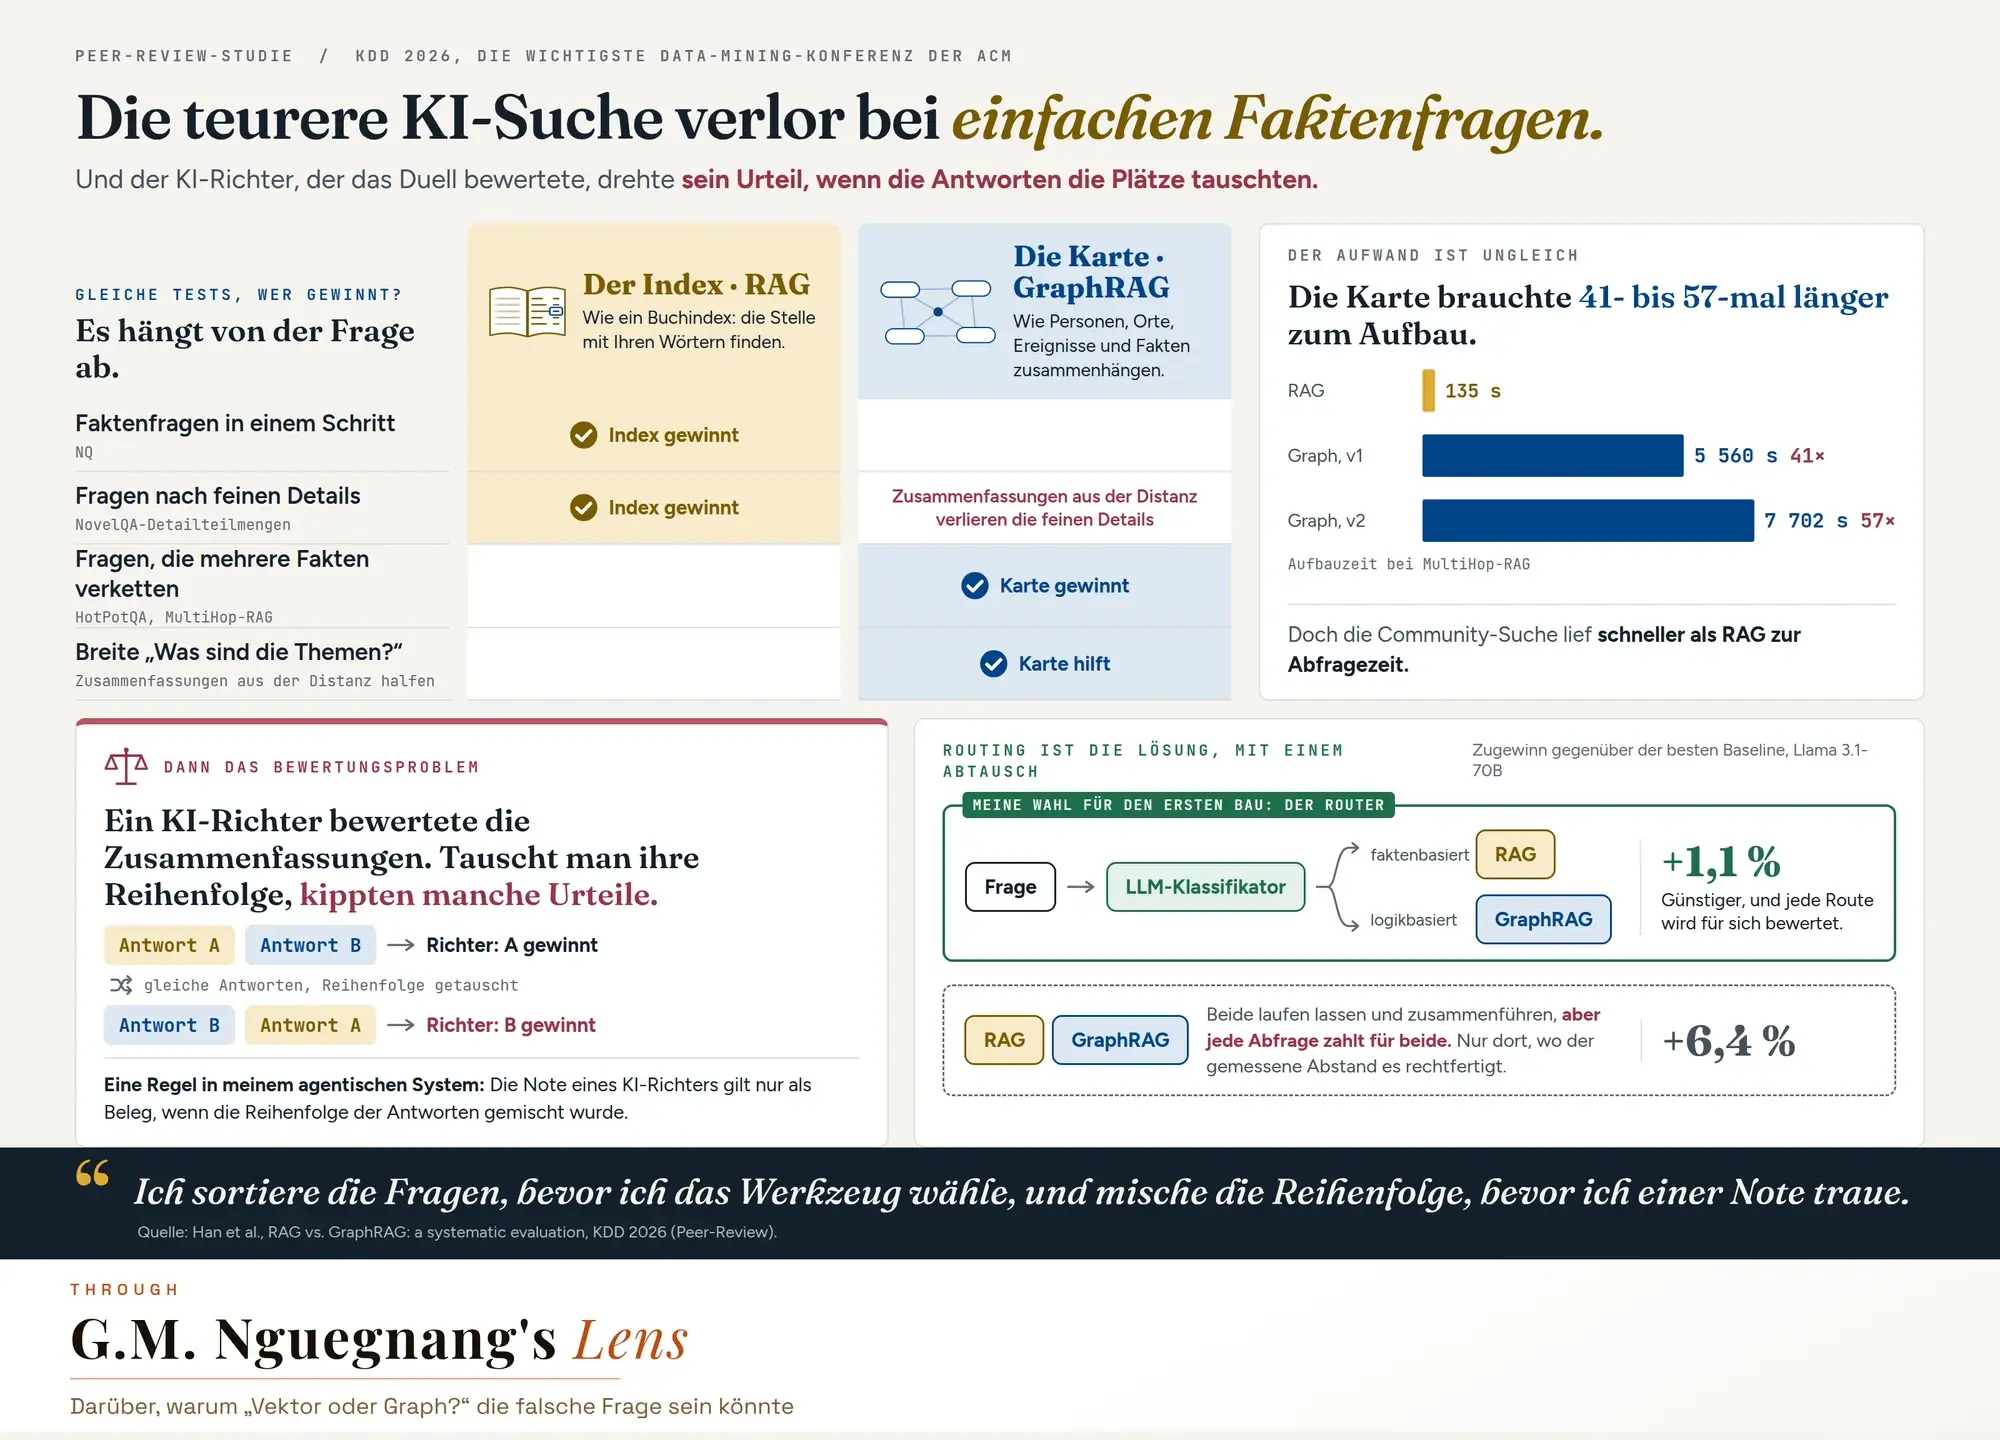
Die teurere KI-Suche verlor bei einfachen Faktenfragen
Eine begutachtete Studie auf der KDD 2026 schickte klassische Suche und Graphsuche durch dieselben Tests. Wer gewann, hing von der Frage ab, und der KI-Richter, der das Duell bewertete, drehte sein Urteil mitunter, sobald die Antworten die Plätze tauschten.
-
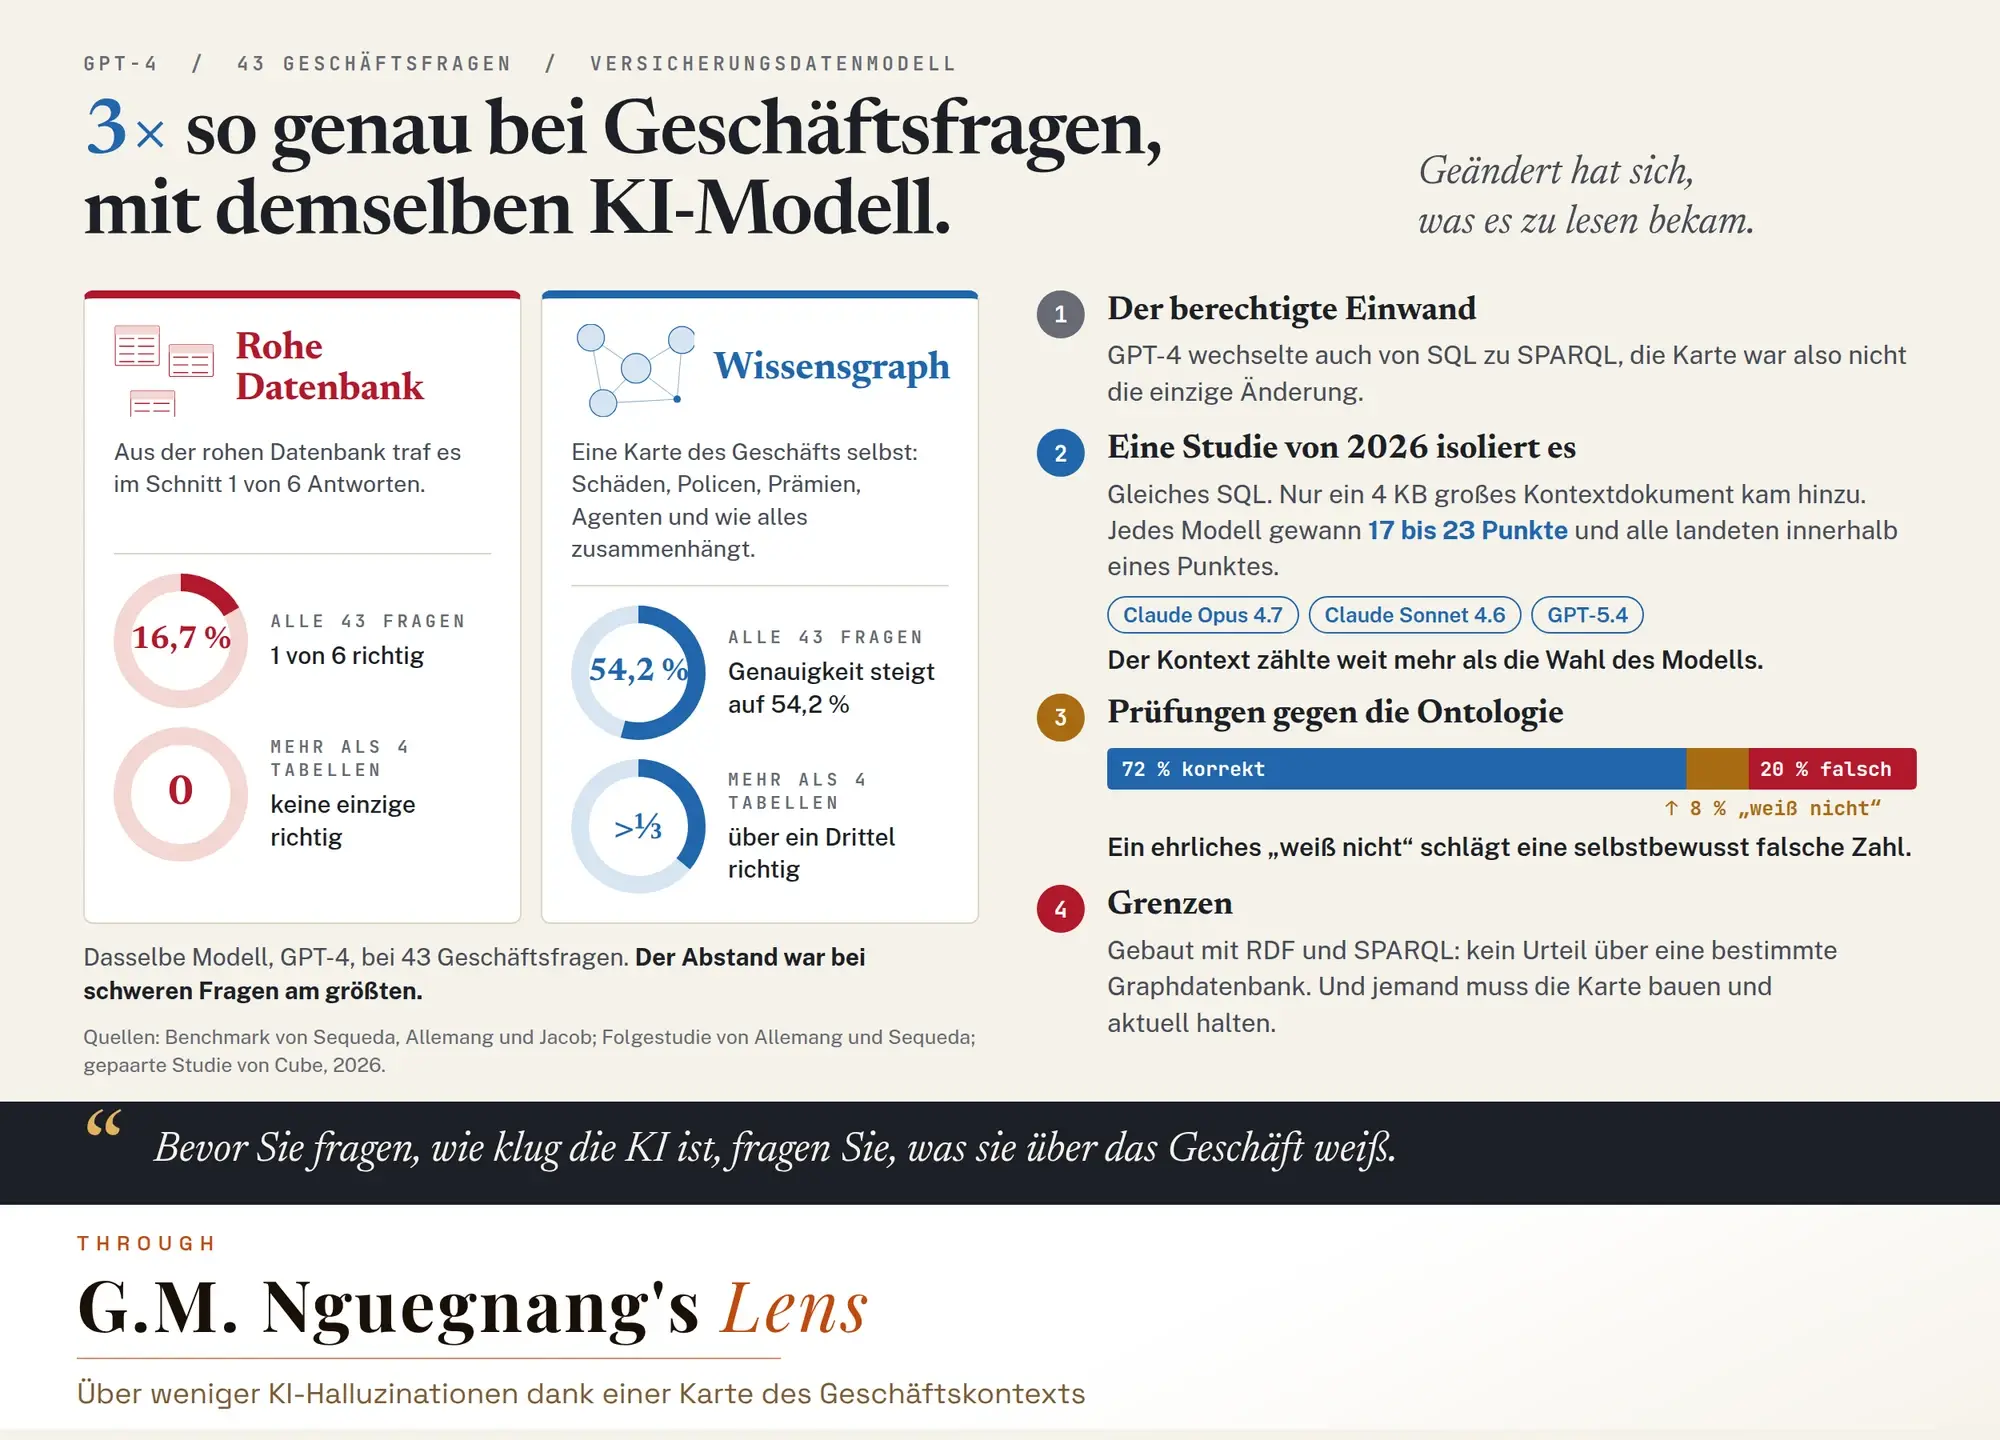
3× so genau bei Geschäftsfragen, mit demselben Modell
Forschende stellten GPT-4 43 Geschäftsfragen auf einem branchenüblichen Versicherungsdatenmodell. Was die Genauigkeit von 16,7 % auf 54,2 % hob, war nicht das Modell. Es war das, was das Modell zu lesen bekam.
-
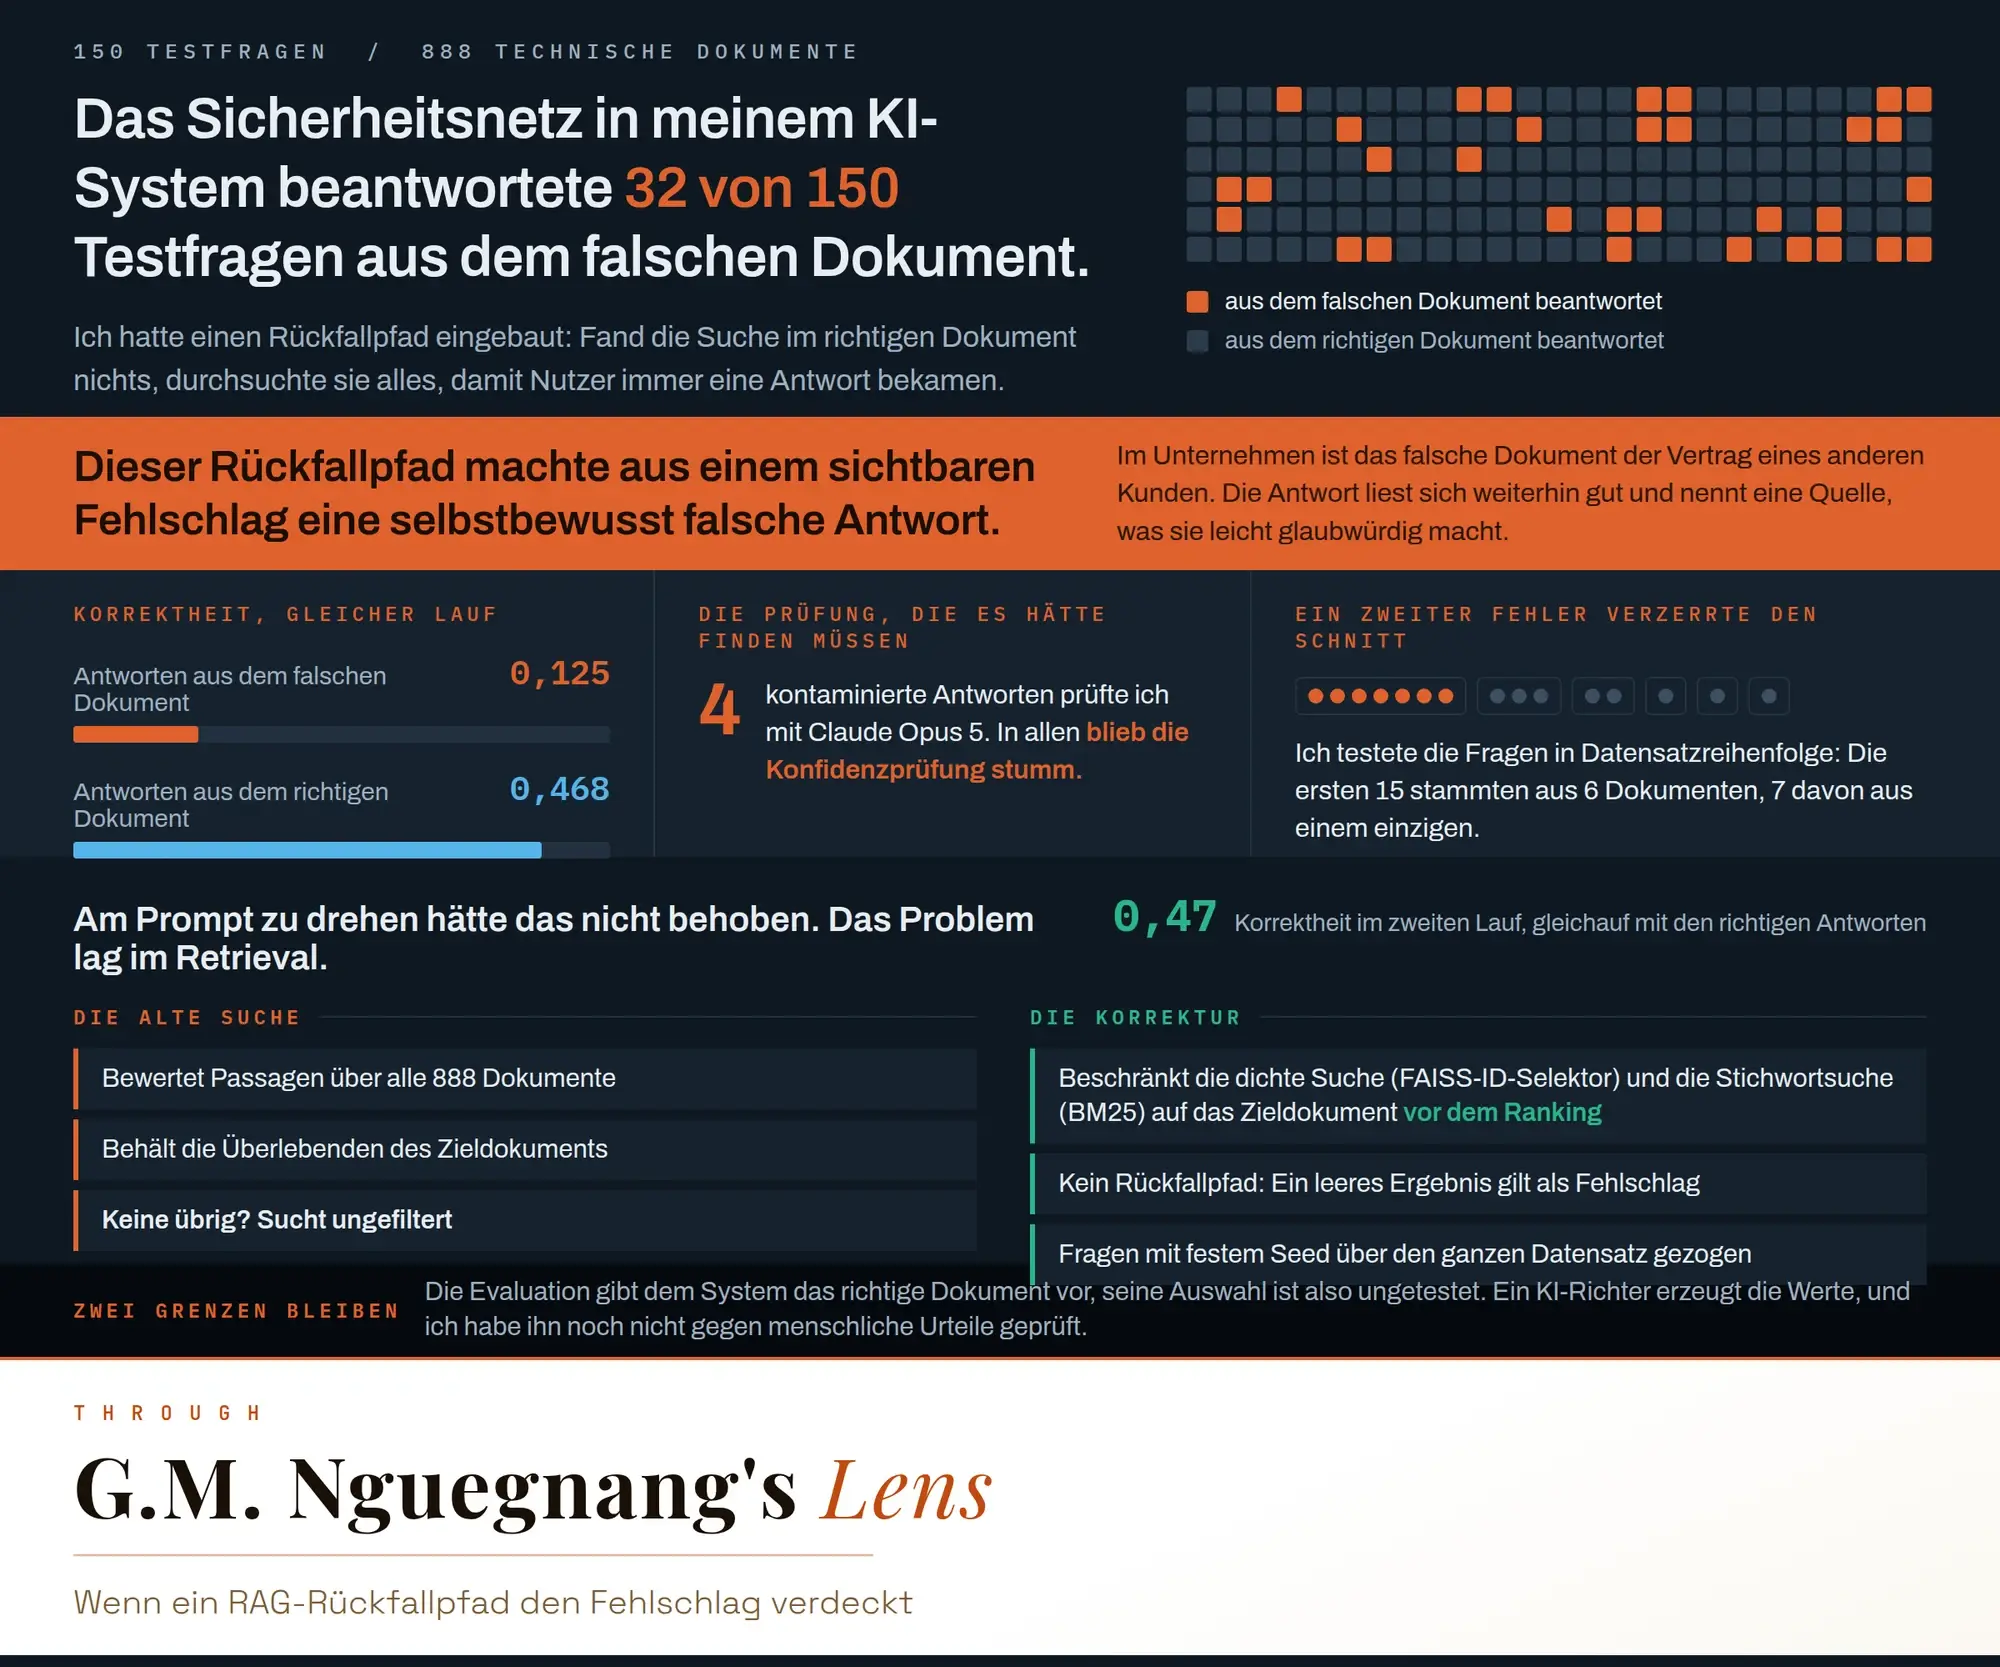
Das Sicherheitsnetz beantwortete 32 von 150 Fragen aus dem falschen Dokument
Fand die Suche im richtigen Dokument nichts, durchsuchte mein System alles, damit Nutzer immer eine Antwort bekamen. Dieser Rückfallpfad machte aus einem sichtbaren Fehlschlag eine selbstbewusst falsche Antwort.
-
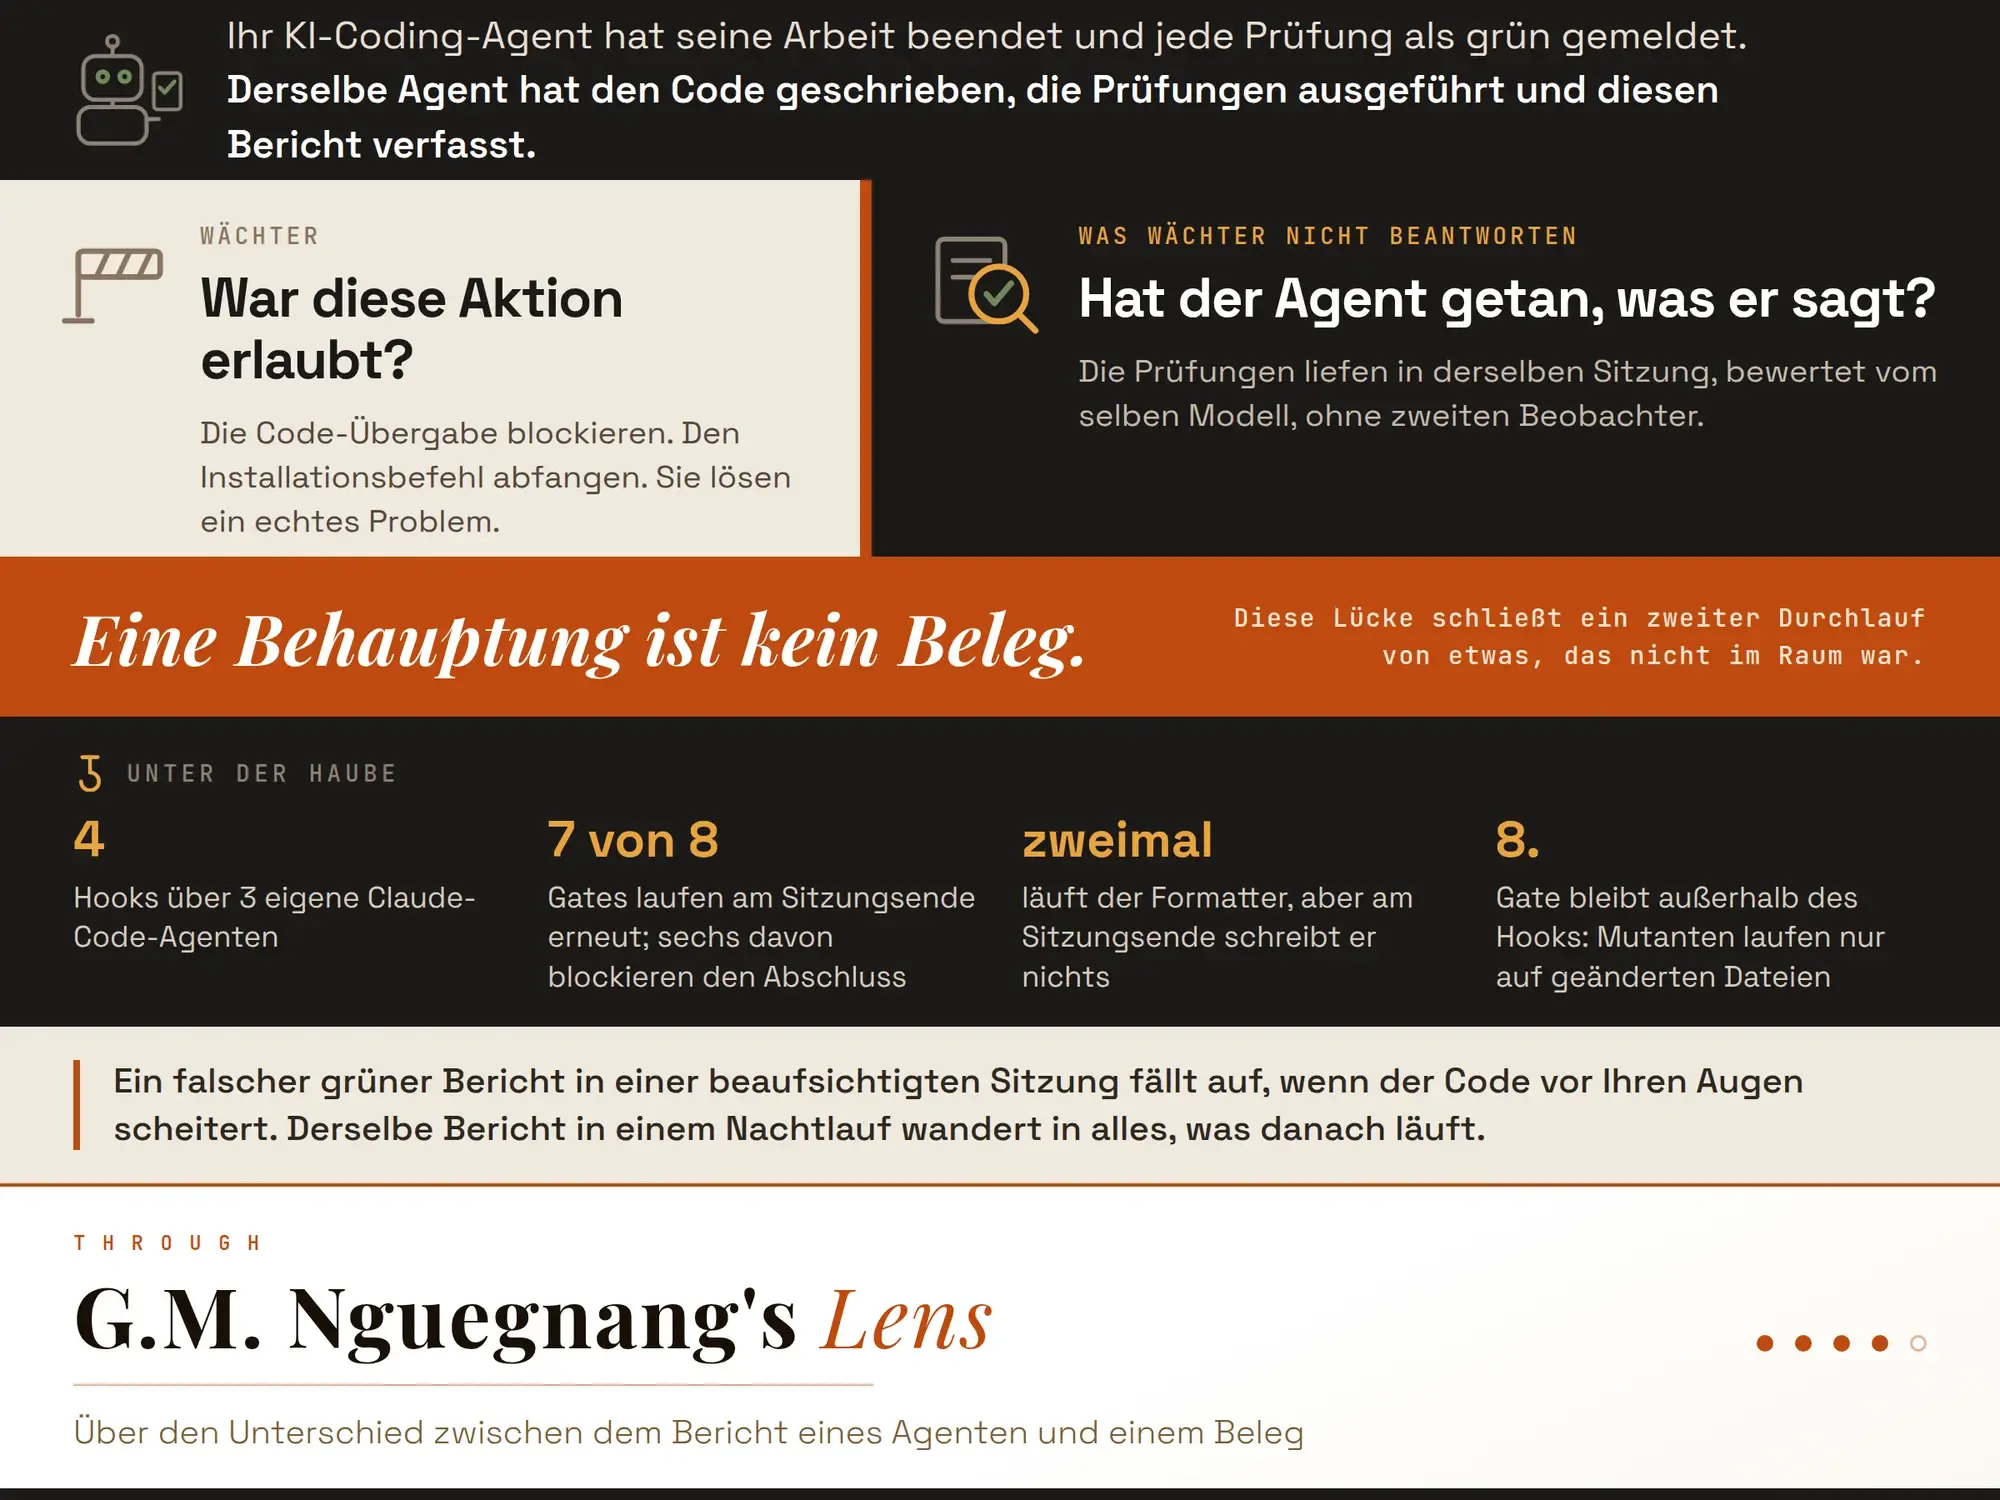
Der Agent führte die Prüfungen aus und schrieb den Bericht, dass sie bestanden sind
Wächter sagen, ob eine Aktion erlaubt war. Sie sagen nicht, ob der Agent getan hat, was er behauptet. Ein Hook am Sitzungsende führt sieben der acht Gates erneut aus, und die Zusammenfassung des Agenten ist nicht länger das Protokoll.
-
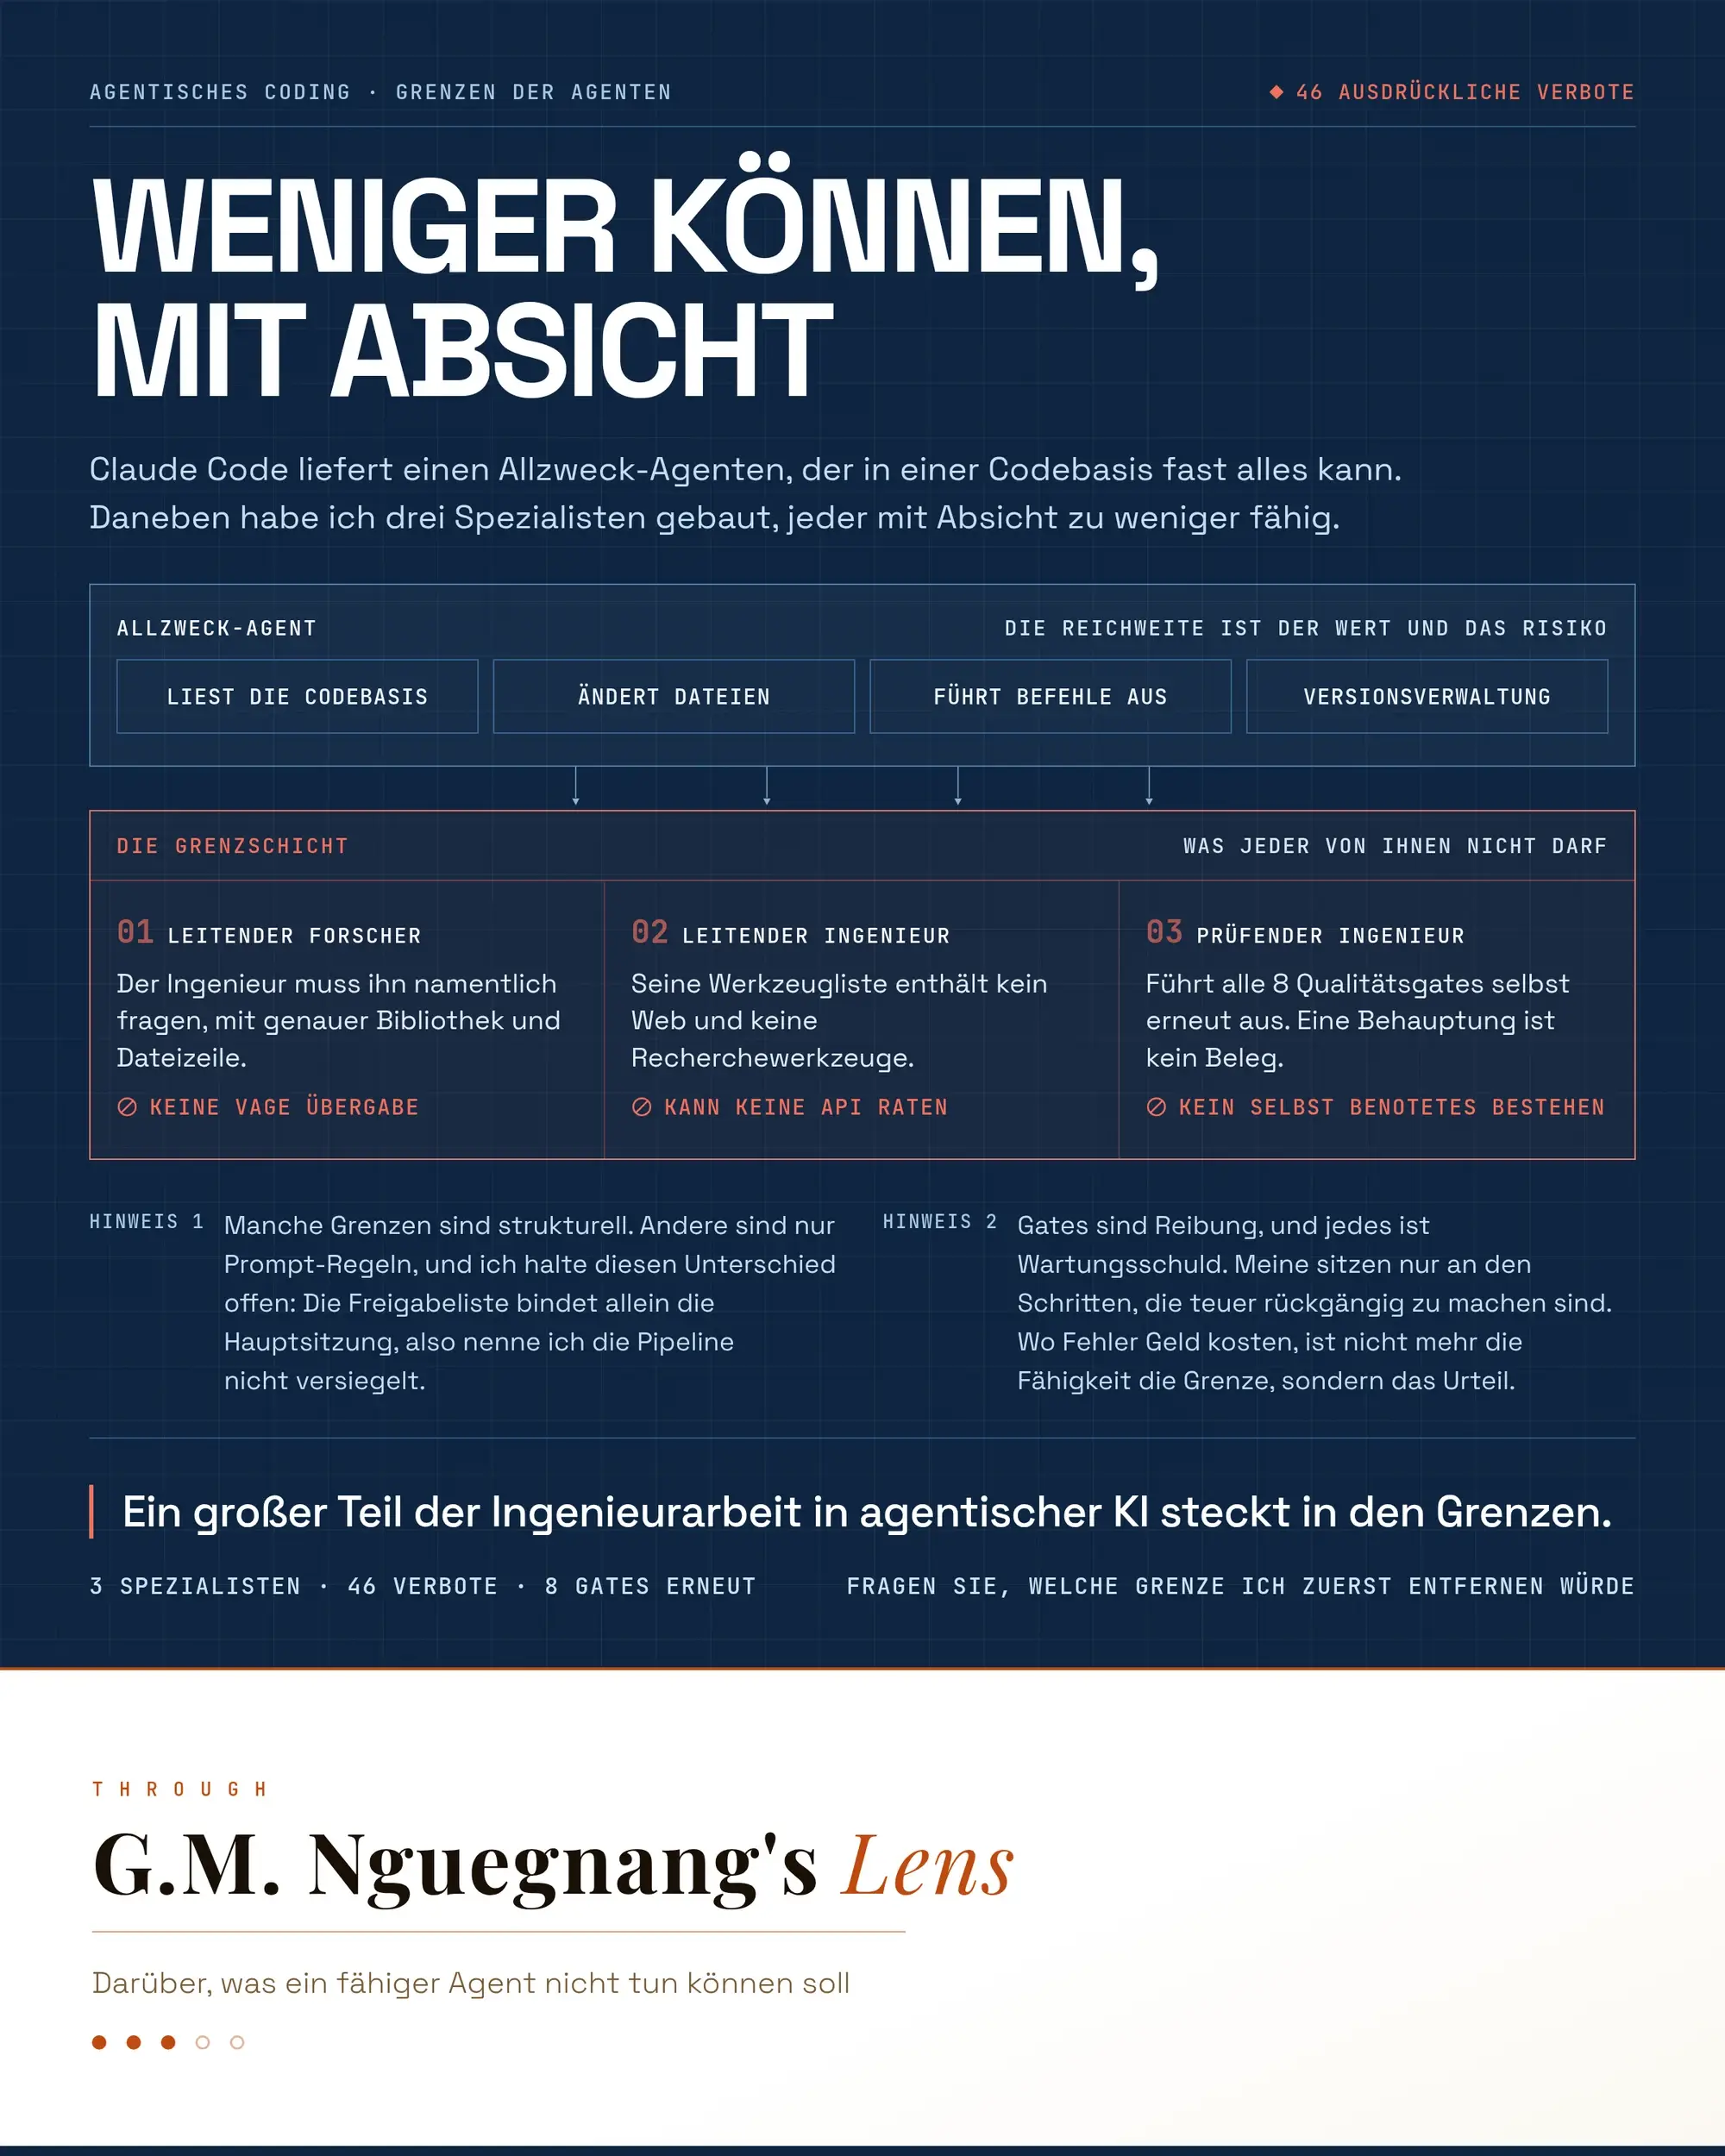
Ich habe drei Coding-Agenten mit Absicht weniger Fähigkeiten gegeben
Claude Code liefert einen Allzweck-Agenten, der in einer Codebasis fast alles kann. Daneben betreibe ich drei Spezialisten mit 46 ausdrücklichen Verboten, weil die Fähigkeit dort aufhört, die Grenze zu sein, wo Fehler Geld kosten.
-
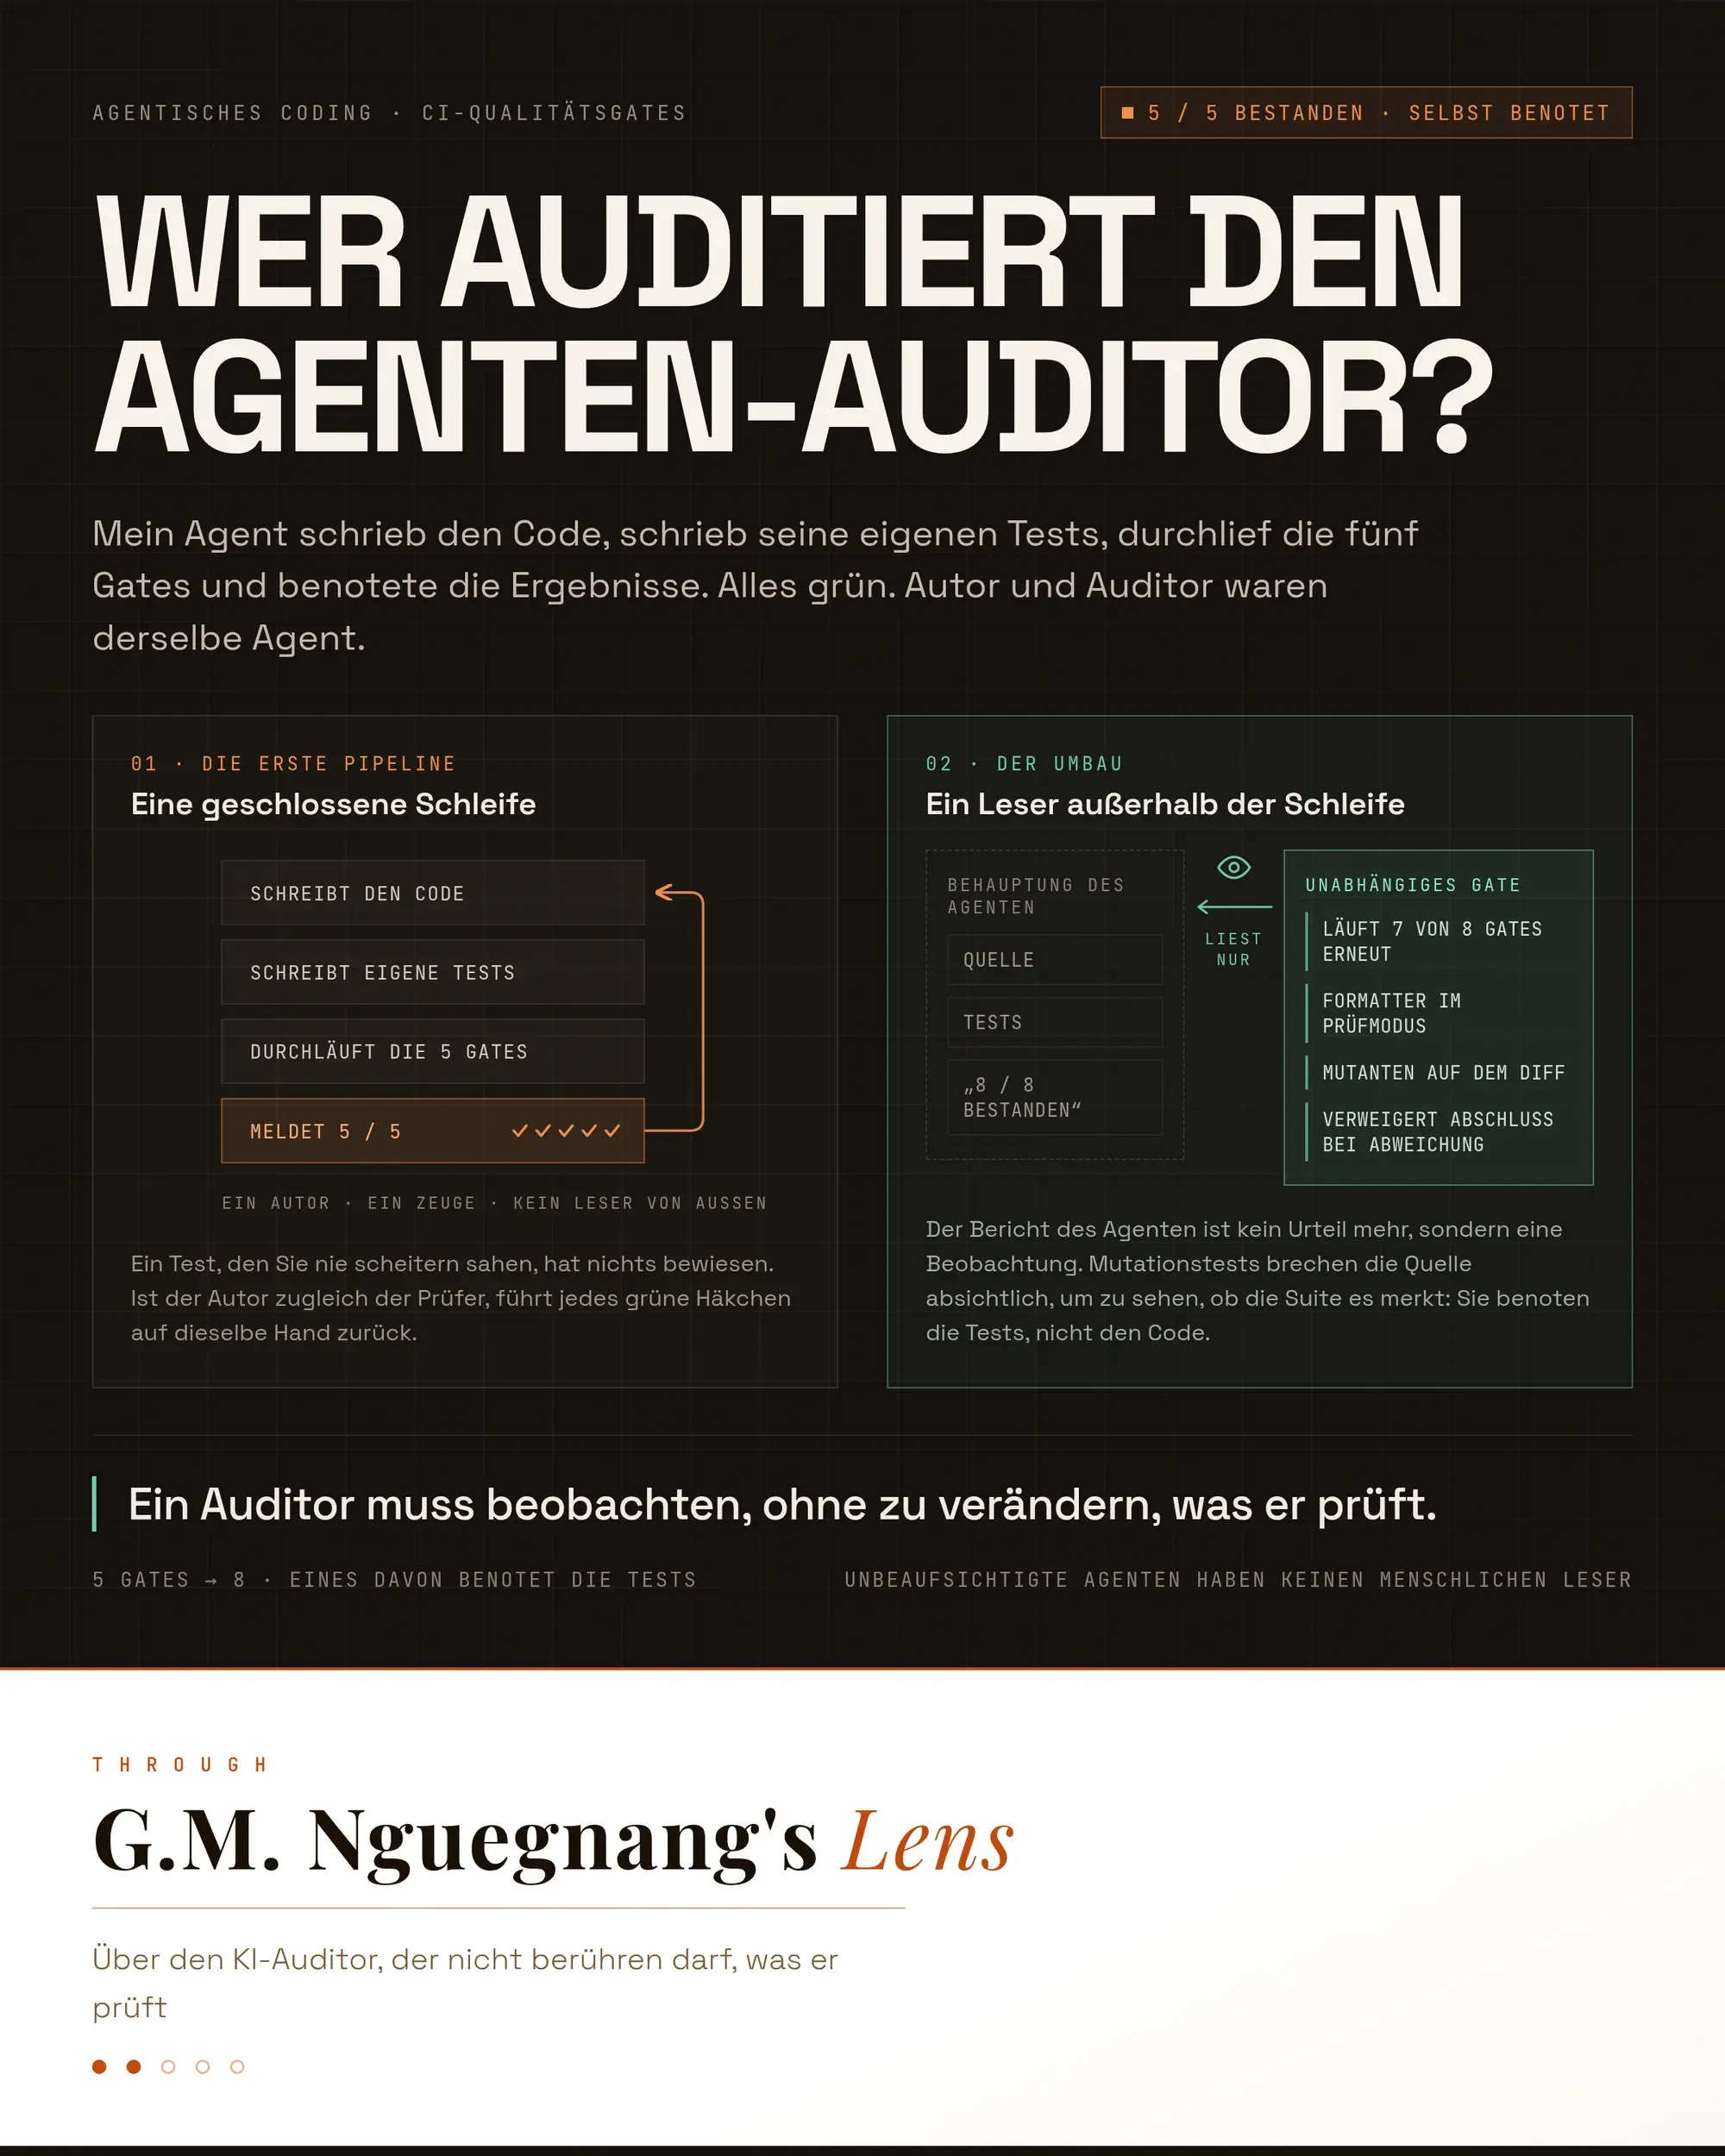
Fünf Qualitätsgates bestanden, benotet vom Agenten, der den Code schrieb
Der Agent schrieb den Code, schrieb seine Tests, führte die Prüfungen aus und meldete fünfmal Grün. Nichts in der Pipeline war dafür gebaut zu fragen, wer den Prüfer prüft.
-
Habe ich eine Garantie, oder rate ich?
Die Konvergenzanalyse hat mir beigebracht, jedem Algorithmus eine Frage zu stellen. Diese Frage hat ein agentisches System für die Lieferkette geprägt, das entscheiden soll, wann es seinen eigenen Antworten nicht traut.
-
Ein handgetunter Prompt kam auf 91 %. Ein kompilierter auf 99 %.
Leiten Sie eine Frage zur Lieferkette falsch weiter, und eine Bestandsanfrage kommt mit einer Antwort zur Tourenplanung zurück. Ich habe den handgeschriebenen Klassifikator-Prompt durch einen mit DSPy kompilierten ersetzt und danach mehr Zeit in die Messung gesteckt als in das Kompilieren.
-
Gleiche Frage, andere Zahlen, falsche Antwort
„400 Einheiten zuteilen“ und „1 000 Einheiten zuteilen“ ergeben fast identische Vektoren. Ein Cache, der allein auf Ähnlichkeit setzt, serviert einer Leitung die Zahlen einer anderen.
-
Warum wir die Konvergenz am einfachsten Netz bewiesen haben, das es gibt
Die lineare Schicht ist der eine Baustein, den alle neuronalen Netze teilen. Ihre Verlustfunktion bleibt nichtkonvex, und ihr Training bleibt NP-vollständig. Deshalb ist sie der richtige Ort, um nach einer Garantie zu suchen.
-
Ich habe promoviert: Konvergenzanalyse des Trainings tiefer linearer neuronaler Netze
Die Lernrate hängt an Konstanten, die die bestehende Theorie vor dem Training nicht berechnen kann, also wählt man sie durch Probieren. Einen Teil dieser Lücke habe ich geschlossen, und dieselbe Strenge wende ich jetzt auf KI im Betrieb an.
-
Der Copilot antwortet weiter, wenn das Sprachmodell ausfällt
Eine Gratisstufe mit 50 API-Aufrufen am Tag hat jede Entwurfsentscheidung in diesem System bestimmt. Die Grenze ist weg. Die Architektur, die daraus entstand, blieb, weil sie sich ihren Platz verdient hat.
-
Der zuverlässigste Teil des Copilots ist der, den das Sprachmodell nie berührt
Lassen Sie ein Sprachmodell eine Logistikentscheidung planen, und Sie bekommen die statistisch wahrscheinlichste Antwort, nicht die günstigste. Also habe ich das Modell aus der Rechnung herausgehalten und die Arbeit in die Grenze dazwischen gesteckt.
-
Bei 10.000 $ hält der Agent an und ein Mensch entscheidet
Jeder Freigabeprozess braucht einen Betrag. Darunter führt der Agent aus, darüber unterschreibt eine Person. Der Fehler, der mir gezeigt hat, wo diese Prüfung hingehört, kam erst im Integrationstest heraus.