Schlug die Qualitätsprüfung meiner KI Alarm, kam die Passage mit der Antwort nur halb so oft durch wie ohne Alarm
Auf dem Papier hat mein KI-Assistent 4 Schritte: Suche, Ranking, Prüfung, Antwort. Als ich maß, was jeder davon mit den gelesenen Passagen macht, zeigte sich: Einer wählte kaum etwas aus, ein anderer konnte nur Belege verlieren.
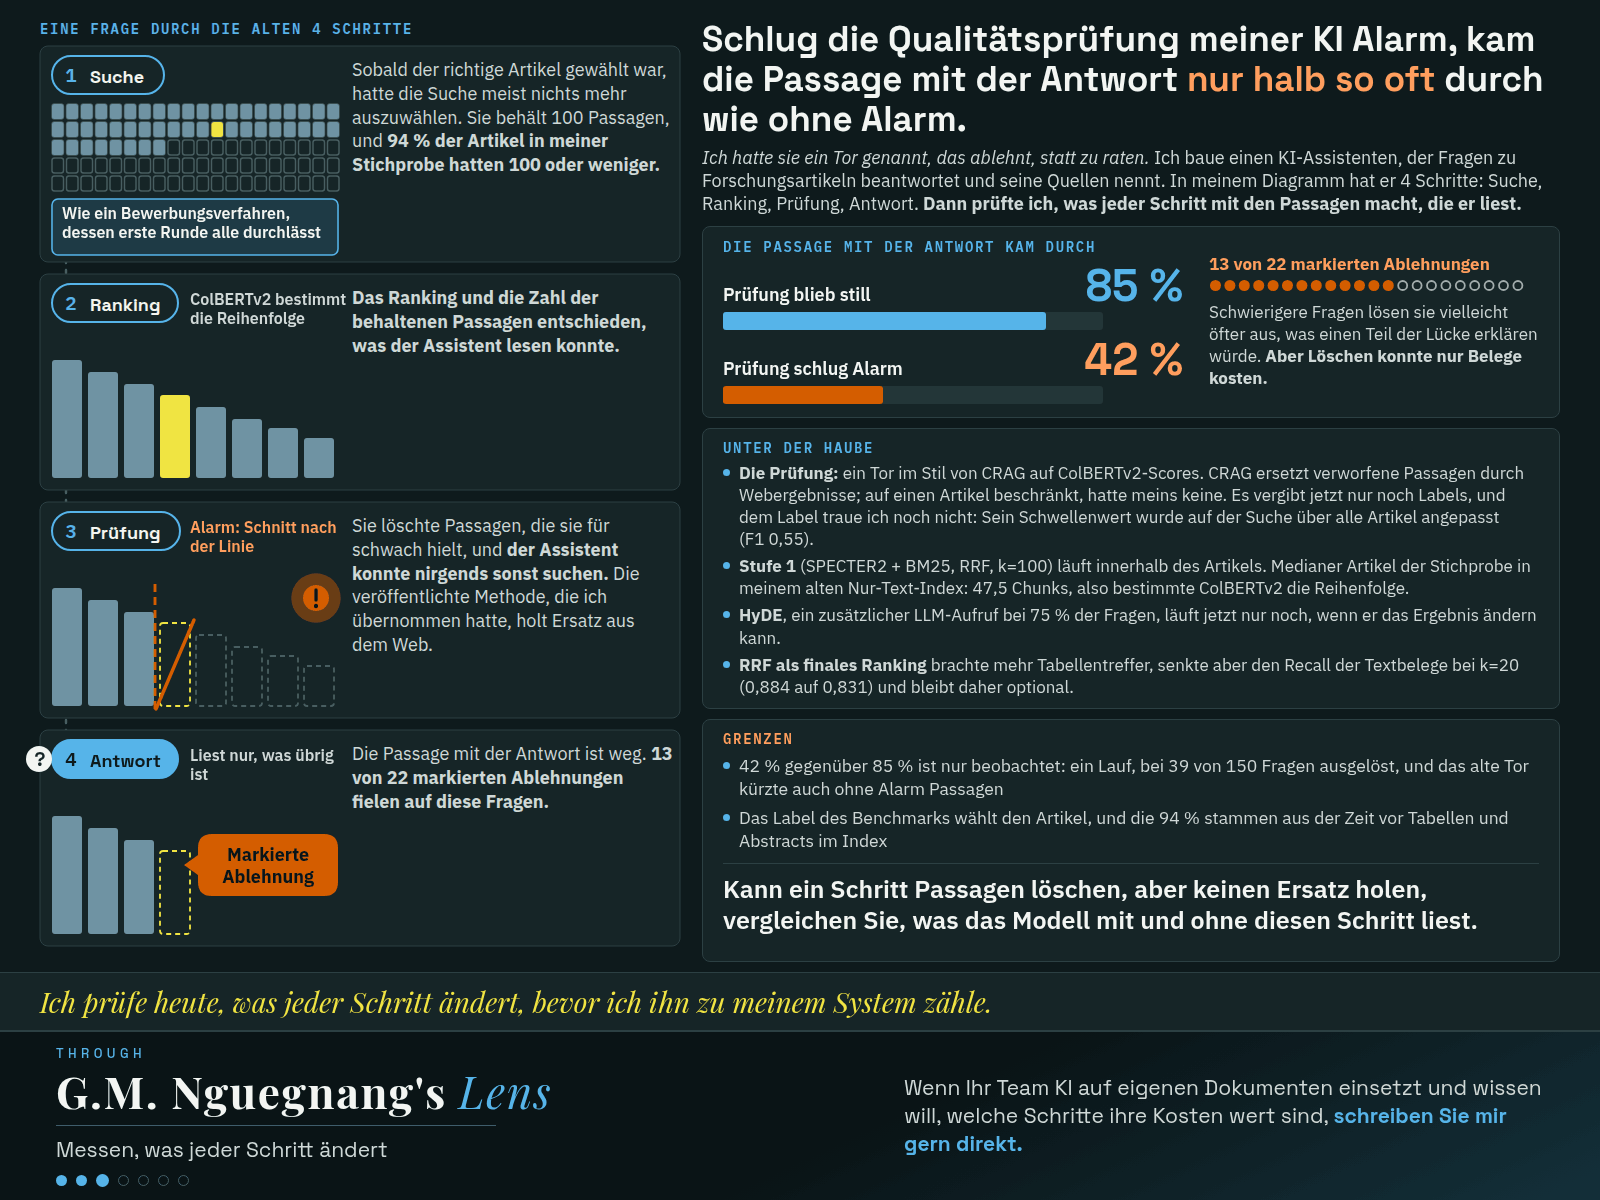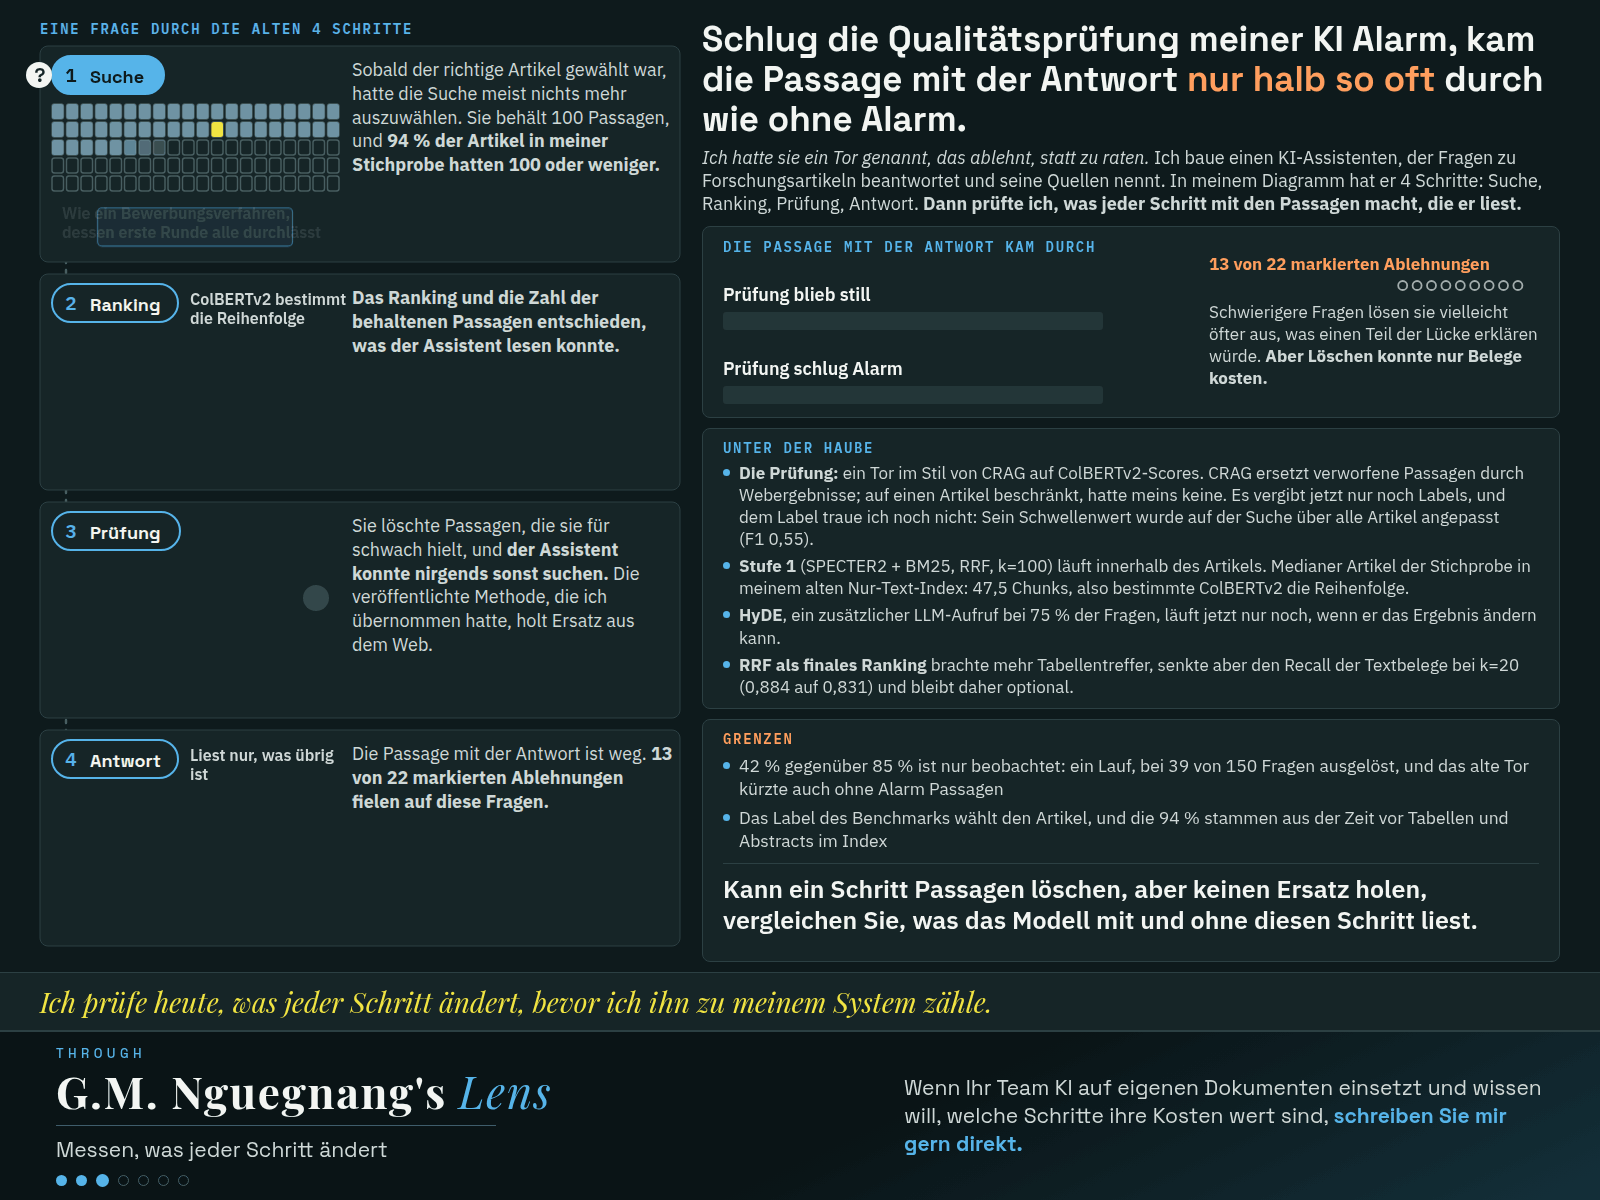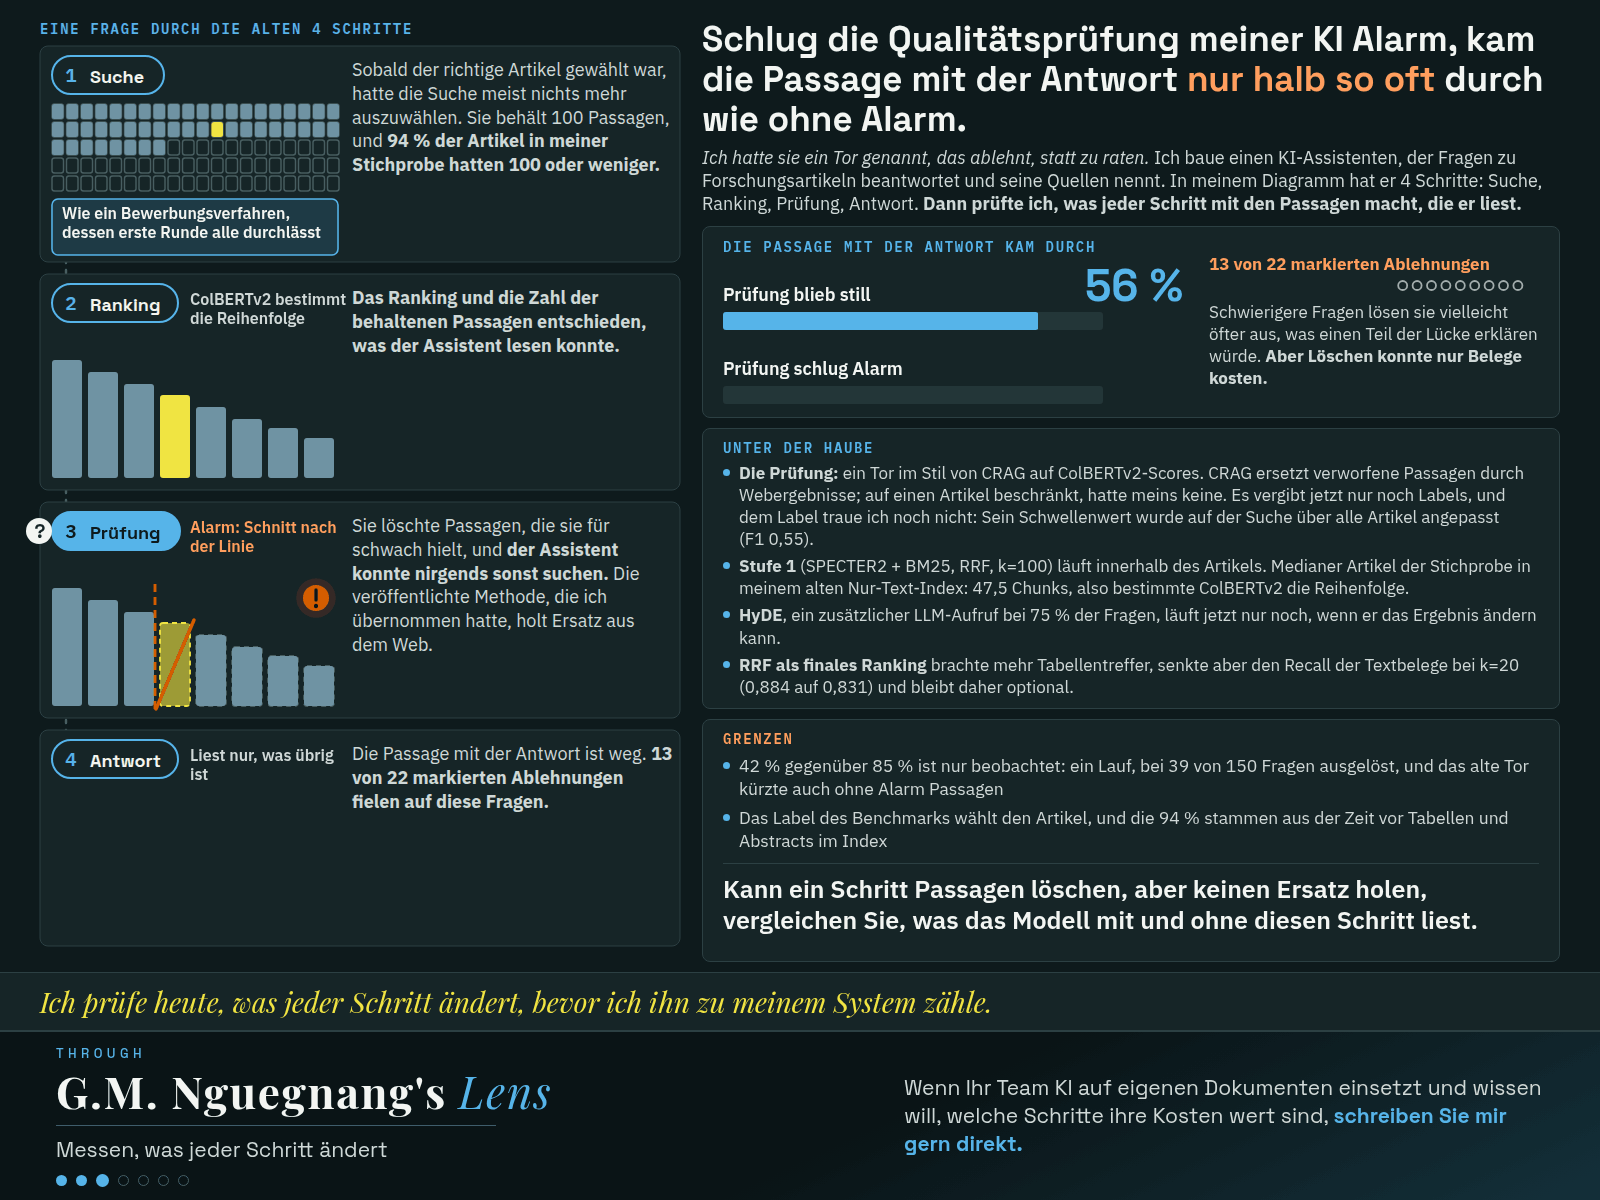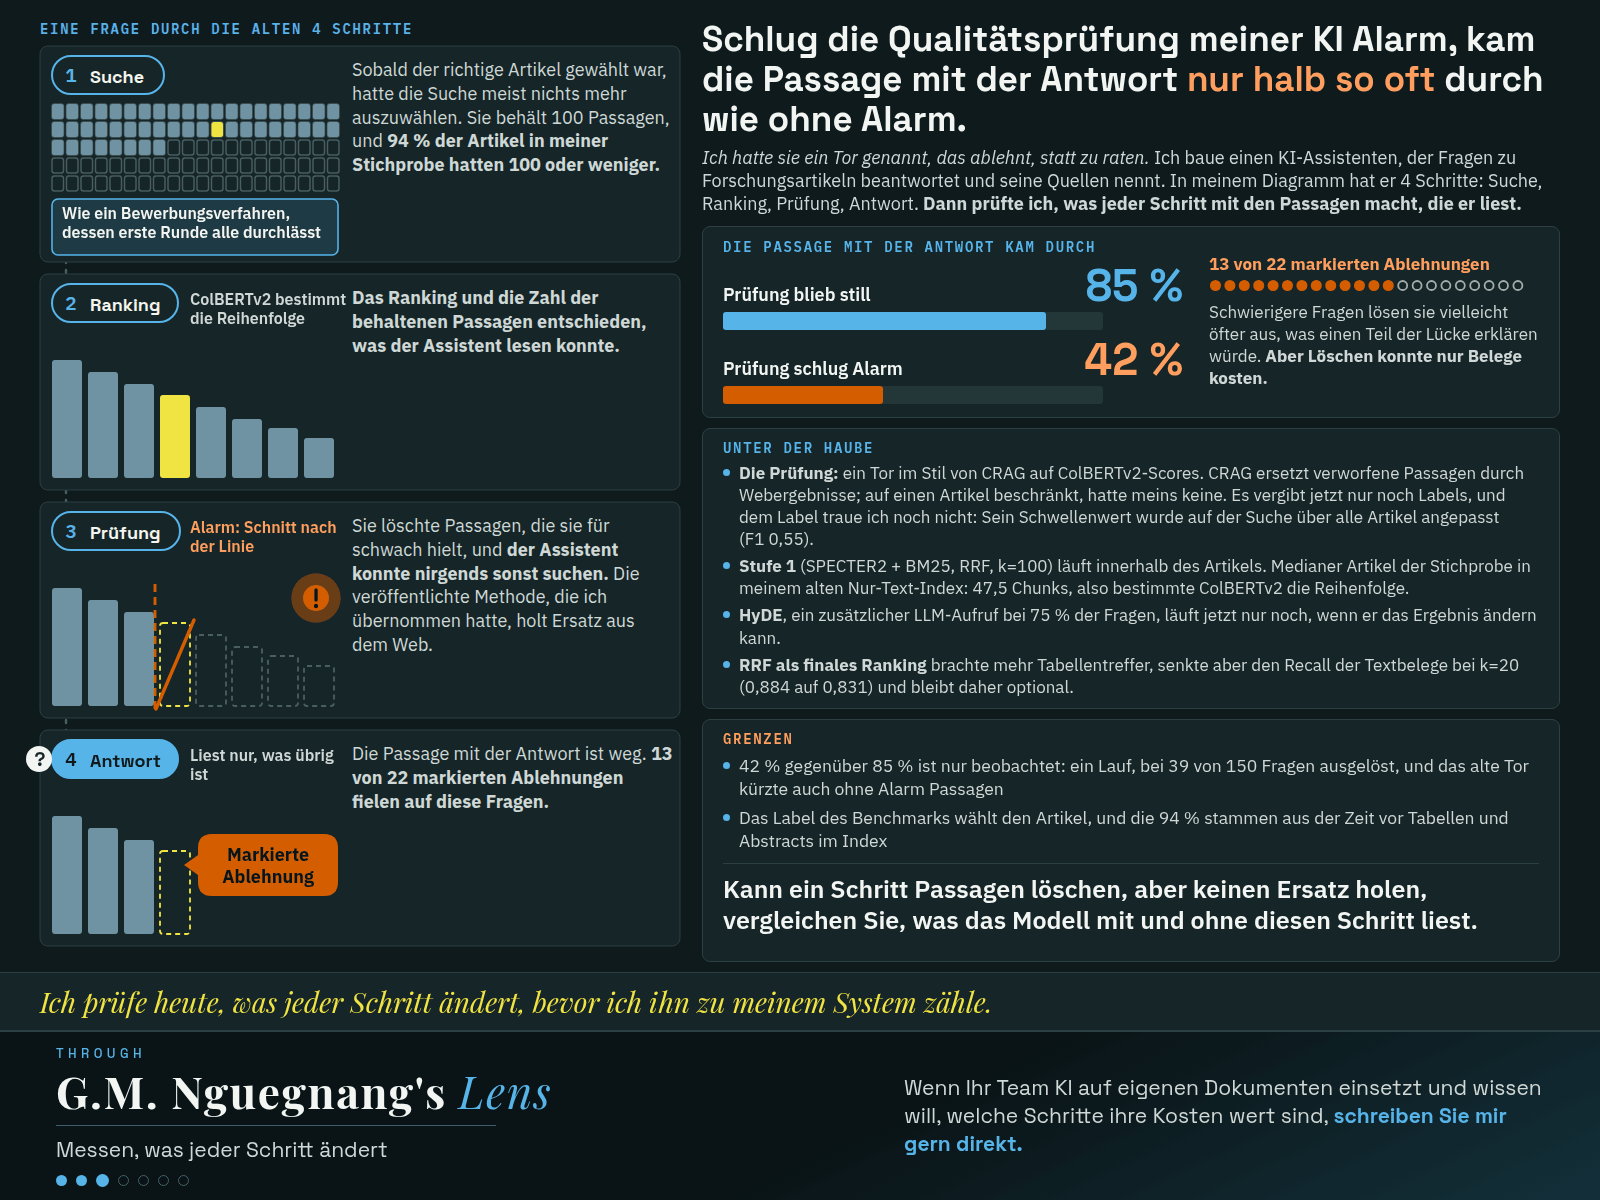
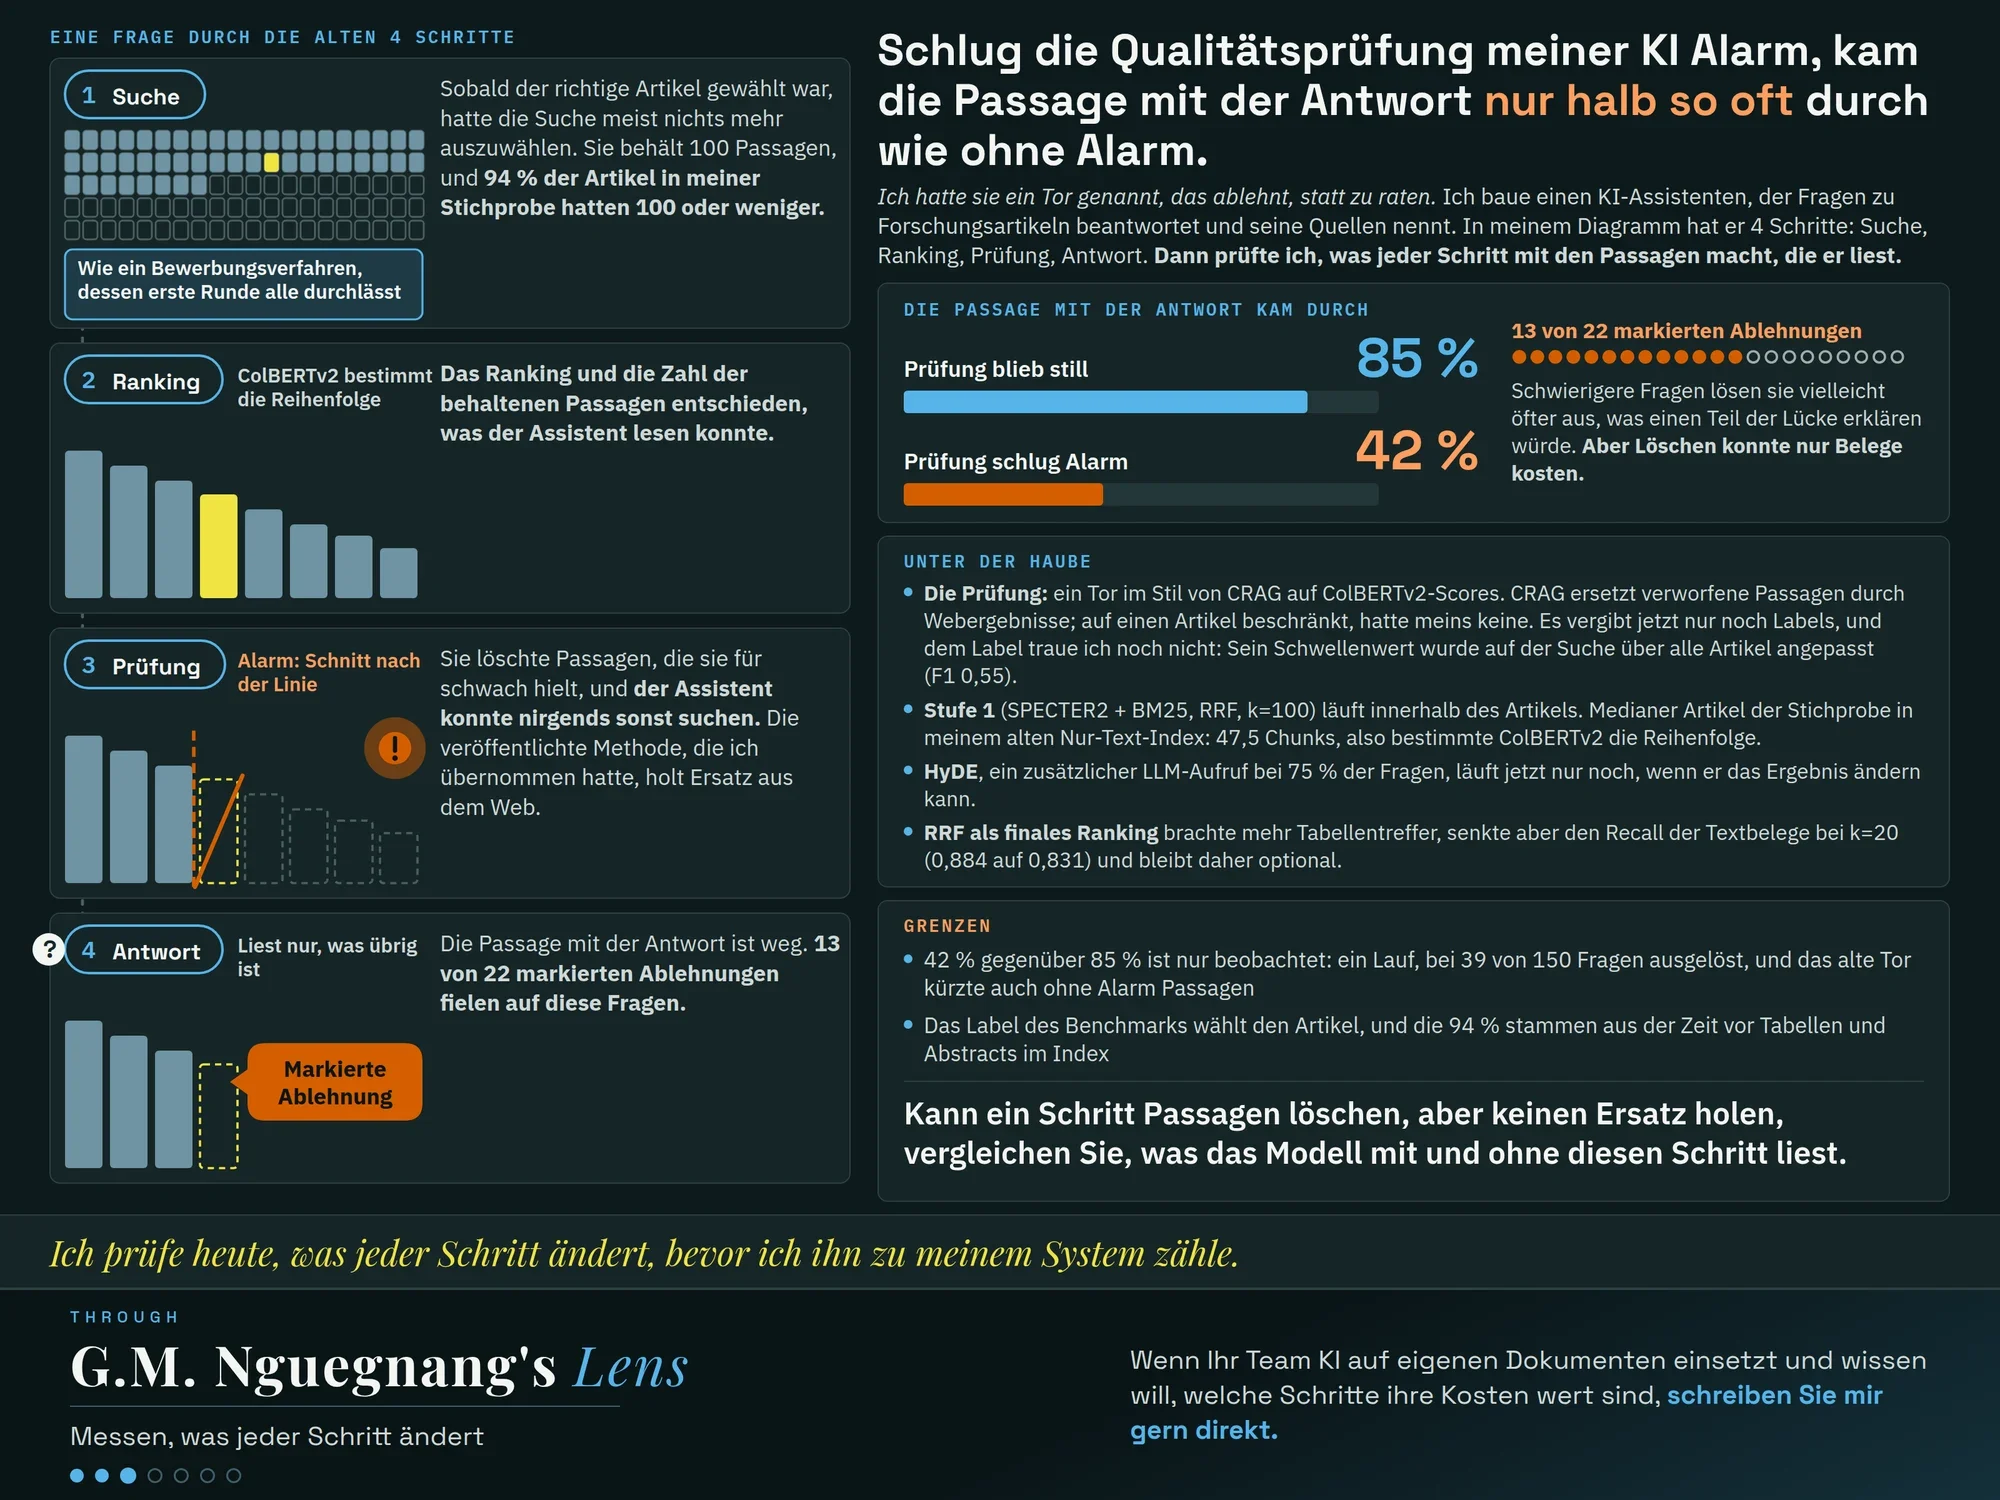
Schlug die Qualitätsprüfung meiner KI Alarm, kam die Passage mit der Antwort nur halb so oft durch wie ohne Alarm.
Ich hatte sie als Tor bezeichnet, das ablehnt, statt zu raten.
Warum das zählt
Ich entwickle einen KI-Assistenten, der Fragen zu Forschungsartikeln beantwortet und seine Quellen nennt. In meinem Diagramm hat er 4 Schritte: Suche, Ranking, Prüfung, Antwort.
Dann habe ich geprüft, was jeder Schritt mit den Passagen macht, die er liest.
War der richtige Artikel einmal gewählt, hatte die Suche meist nichts mehr auszuwählen. Sie behält 100 Passagen, und 94 % der Artikel in meiner Stichprobe hatten 100 oder weniger. Man stelle sich ein Bewerbungsverfahren vor, dessen erste Runde alle Bewerbenden durchlässt.
Die Qualitätsprüfung war schlimmer. Sie löschte Passagen, die sie für schwach hielt, und der Assistent konnte nirgends sonst suchen. Schlug sie Alarm, kam die Passage mit der Antwort in 42 % der Fälle durch, gegenüber 85 %, wenn sie still blieb. 13 von 22 markierten Ablehnungen fielen auf diese Fragen.
Schwierigere Fragen lösen sie vielleicht öfter aus, was einen Teil der Lücke erklären würde. Aber Löschen konnte nur Belege kosten. Die veröffentlichte Methode, die ich übernommen hatte, holt Ersatz aus dem Web.
Was der Assistent lesen konnte, entschieden also das Ranking und die Zahl der behaltenen Passagen.
Ich prüfe heute, was jeder Schritt ändert, bevor ich ihn zu meinem System zähle.
Wie es funktioniert
Die Prüfung ist ein Tor im Stil von CRAG auf ColBERTv2-Scores. CRAG ersetzt verworfene Passagen durch Webergebnisse; auf einen einzigen Artikel beschränkt, hatte meine Prüfung keine. Sie vergibt jetzt nur noch Labels, und diesem Label traue ich noch nicht: Sein Schwellenwert wurde auf der Suche über alle Artikel angepasst (F1 0,55).
Stufe 1 (SPECTER2 + BM25, RRF, k=100) läuft innerhalb des Artikels. In meinem alten Nur-Text-Index hatte der mittlere Artikel der Stichprobe 47,5 Chunks. Stufe 1 lieferte also meist den ganzen Artikel, und ColBERTv2 bestimmte die Reihenfolge. HyDE, ein zusätzlicher LLM-Aufruf bei 75 % der Fragen, läuft jetzt nur noch, wenn er das Ergebnis ändern kann. RRF als finales Ranking brachte mehr Tabellentreffer, senkte aber den Recall der Textbelege bei k=20 (von 0,884 auf 0,831) und bleibt daher optional.
Grenzen:
- 42 % gegenüber 85 % ist nur beobachtet: ein einziger Lauf, bei 39 von 150 Fragen ausgelöst, und das alte Tor kürzte auch ohne Alarm Passagen
- Das Label des Benchmarks wählt den Artikel, und die 94 % stammen aus der Zeit vor Tabellen und Abstracts im Index
Meine Lehre daraus: Kann ein Schritt Passagen löschen, aber keinen Ersatz holen, vergleichen Sie, was das Modell mit und ohne diesen Schritt liest.
Die Animation zeigt, wie eine Frage die alten 4 Schritte durchläuft.
Wenn Ihr Team KI auf eigenen Dokumenten einsetzt und wissen will, welche Schritte ihre Kosten wert sind, schreiben Sie mir gern direkt.