Der Agent führte die Prüfungen aus und schrieb den Bericht, dass sie bestanden sind
Wächter sagen, ob eine Aktion erlaubt war. Sie sagen nicht, ob der Agent getan hat, was er behauptet. Ein Hook am Sitzungsende führt sieben der acht Gates erneut aus, und die Zusammenfassung des Agenten ist nicht länger das Protokoll.
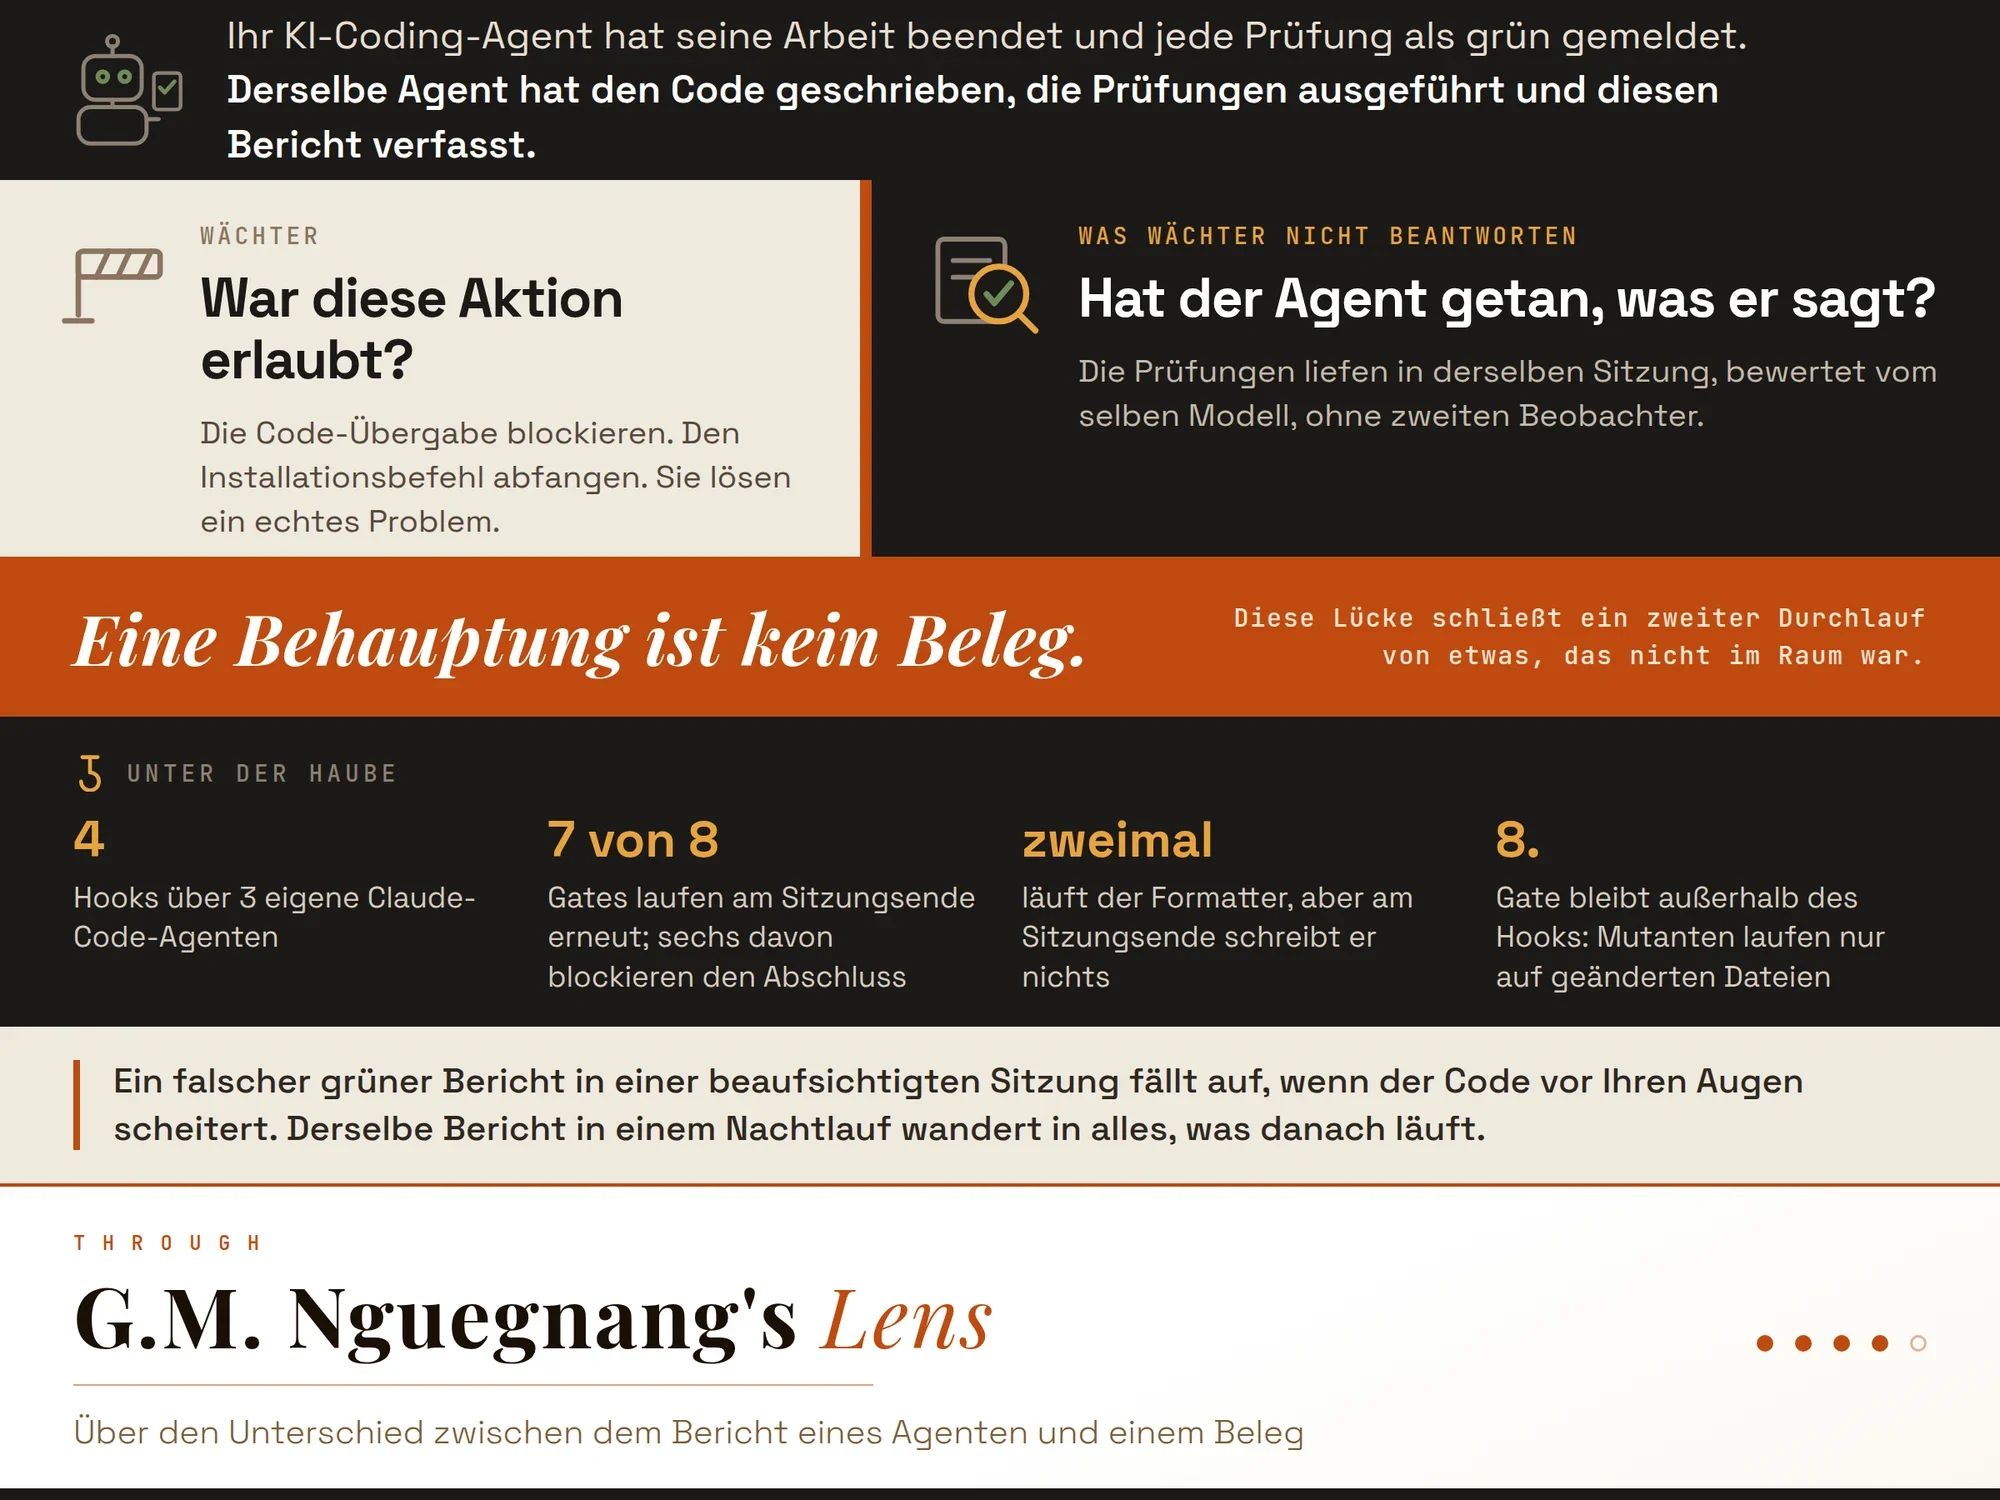
Ihr KI-Coding-Agent hat seine Arbeit beendet und jede Prüfung als grün gemeldet. Derselbe Agent hat den Code geschrieben, die Prüfungen ausgeführt und diesen Bericht verfasst.
Warum das zählt
Es gibt eine Klasse von Werkzeugen, die einen Agenten stoppen, bevor er etwas Gefährliches tut. Die Code-Übergabe blockieren. Den Installationsbefehl abfangen. Das sind Wächter, und sie lösen ein echtes Problem.
Ein Wächter beantwortet aber nur eine Frage: War diese Aktion erlaubt? Er beantwortet nicht die zweite: Hat der Agent getan, was er sagt?
Ein Agent, der seine eigenen Prüfungen ausführt und seinen eigenen Bericht schreibt, hat eine Behauptung erzeugt. Die Prüfungen liefen in derselben Sitzung, bewertet vom selben Modell, ohne zweiten Beobachter. Huang und Mitautoren zeigten auf der ICLR 2024 in „Large Language Models Cannot Self-Correct Reasoning Yet“, dass Modelle sich ohne Rückmeldung von außen nicht verlässlich selbst korrigieren. Diese Lücke schließt ein zweiter Durchlauf von etwas, das nicht im Raum war.
Eine Behauptung ist kein Beleg.
Wie es funktioniert
Ich betreibe 4 Hooks über 3 eigene Claude-Code-Agenten. Zwei bewachen Bash-Befehle: Einer blockiert Git-Operationen, der andere fängt Paketinstallationen ab. Ein dritter fängt Schreibzugriffe ab und liefert ein Schreibhandbuch aus, bevor das erste Dokument entsteht.
Der vierte löst am Sitzungsende aus. Er führt 7 der 8 Qualitätsgates selbst erneut aus und blockiert den Abschluss, sobald eines scheitert. Sechs der sieben blockieren; die Typprüfung meldet und lässt durch. Die Zusammenfassung des Agenten ist damit nicht länger das Protokoll.
Ein Auditor, der den Code umformatiert, den er prüft, hat den Beleg verändert. Der Formatter läuft deshalb zweimal, auf verschiedene Weise. In der Sitzung führt der Agent Black aus, das Dateien umschreibt. Am Sitzungsende führt der Hook es im Prüfmodus aus: Es schreibt nichts und endet mit Fehlercode, falls sich etwas ändern würde.
Das achte Gate, die Mutationstests, bleibt außerhalb des Hooks. Es kostet einen vollen Testlauf pro Mutant. Petrović und Ivanković, die über Mutationstests in Googles Größenordnung berichten, beschränken sie zur Review-Zeit auf den Diff. Also habe ich einen Runner geschrieben, der nur die geänderten Dateien mutiert, und er läuft, während der Code entsteht, statt erst am Ende.
Der Auditor deckt die beiden Agenten ab, die Code schreiben. Der Recherche-Agent hat keine Prüfung am Sitzungsende, weil er Baupläne liefert und keine Testsuite.
Ein falscher grüner Bericht in einer beaufsichtigten Sitzung fällt auf, sobald der Code vor Ihren Augen scheitert. Derselbe Bericht in einem Nachtlauf wandert in alles, was danach läuft, und für diesen Fall ist die Konstruktion gebaut.
Wo das endet: Der Hook hält, solange sein Skript vorhanden und ausführbar ist, und eine dokumentierte Umgebungsvariable schaltet ihn ab. Das ist mehr wert als eine Anweisung in Prosa, die jedes Mal nachgibt, wenn das Modell sie neu abwägt. Eine harte Fähigkeitsgrenze ist es nicht, und das sage ich lieber, als die Pipeline versiegelt wirken zu lassen.