60 der 150 Fragen, mit denen ich meine KI teste, verweisen auf eine Tabelle oder Abbildung. Meine KI konnte keine davon sehen
Mein KI-Assistent durchsucht Forschungsartikel, bevor er antwortet, und seine Suche übersprang jede Tabelle und Abbildung. Die Korrektur deckte einen zweiten blinden Fleck auf, in der Auswertung, mit der ich ihn bewerte.
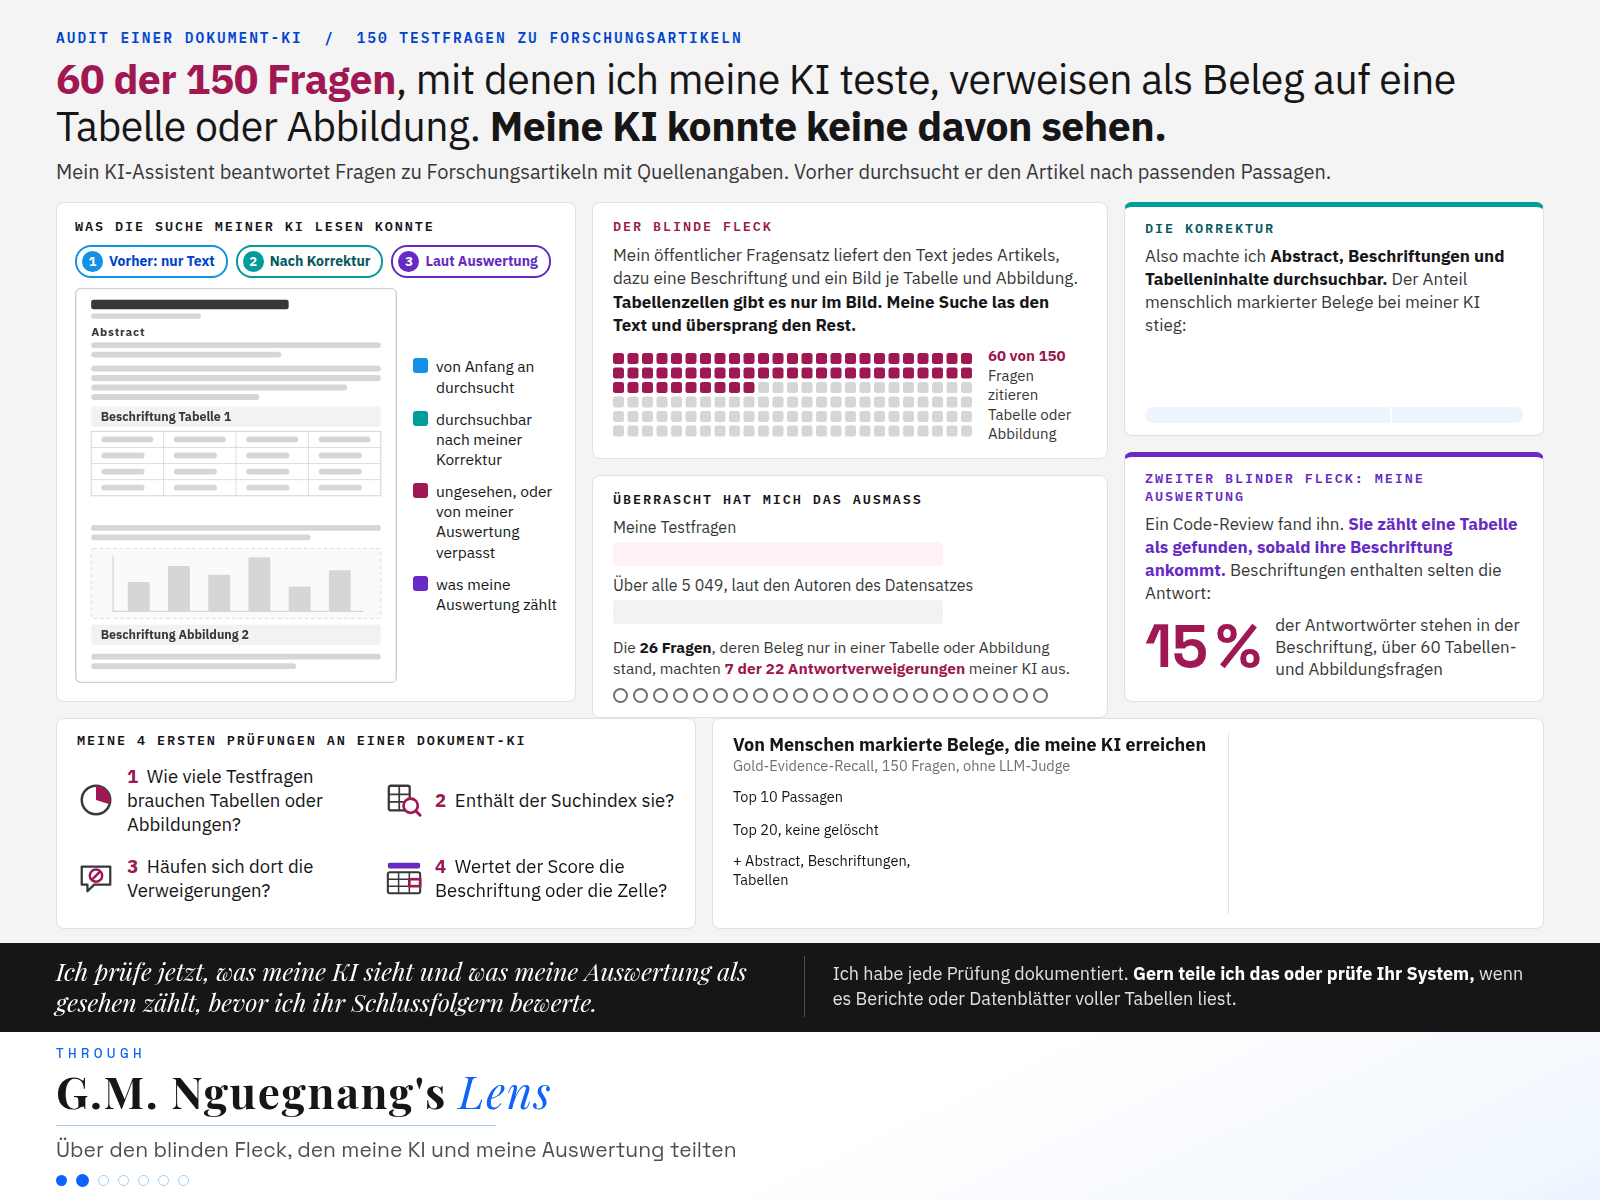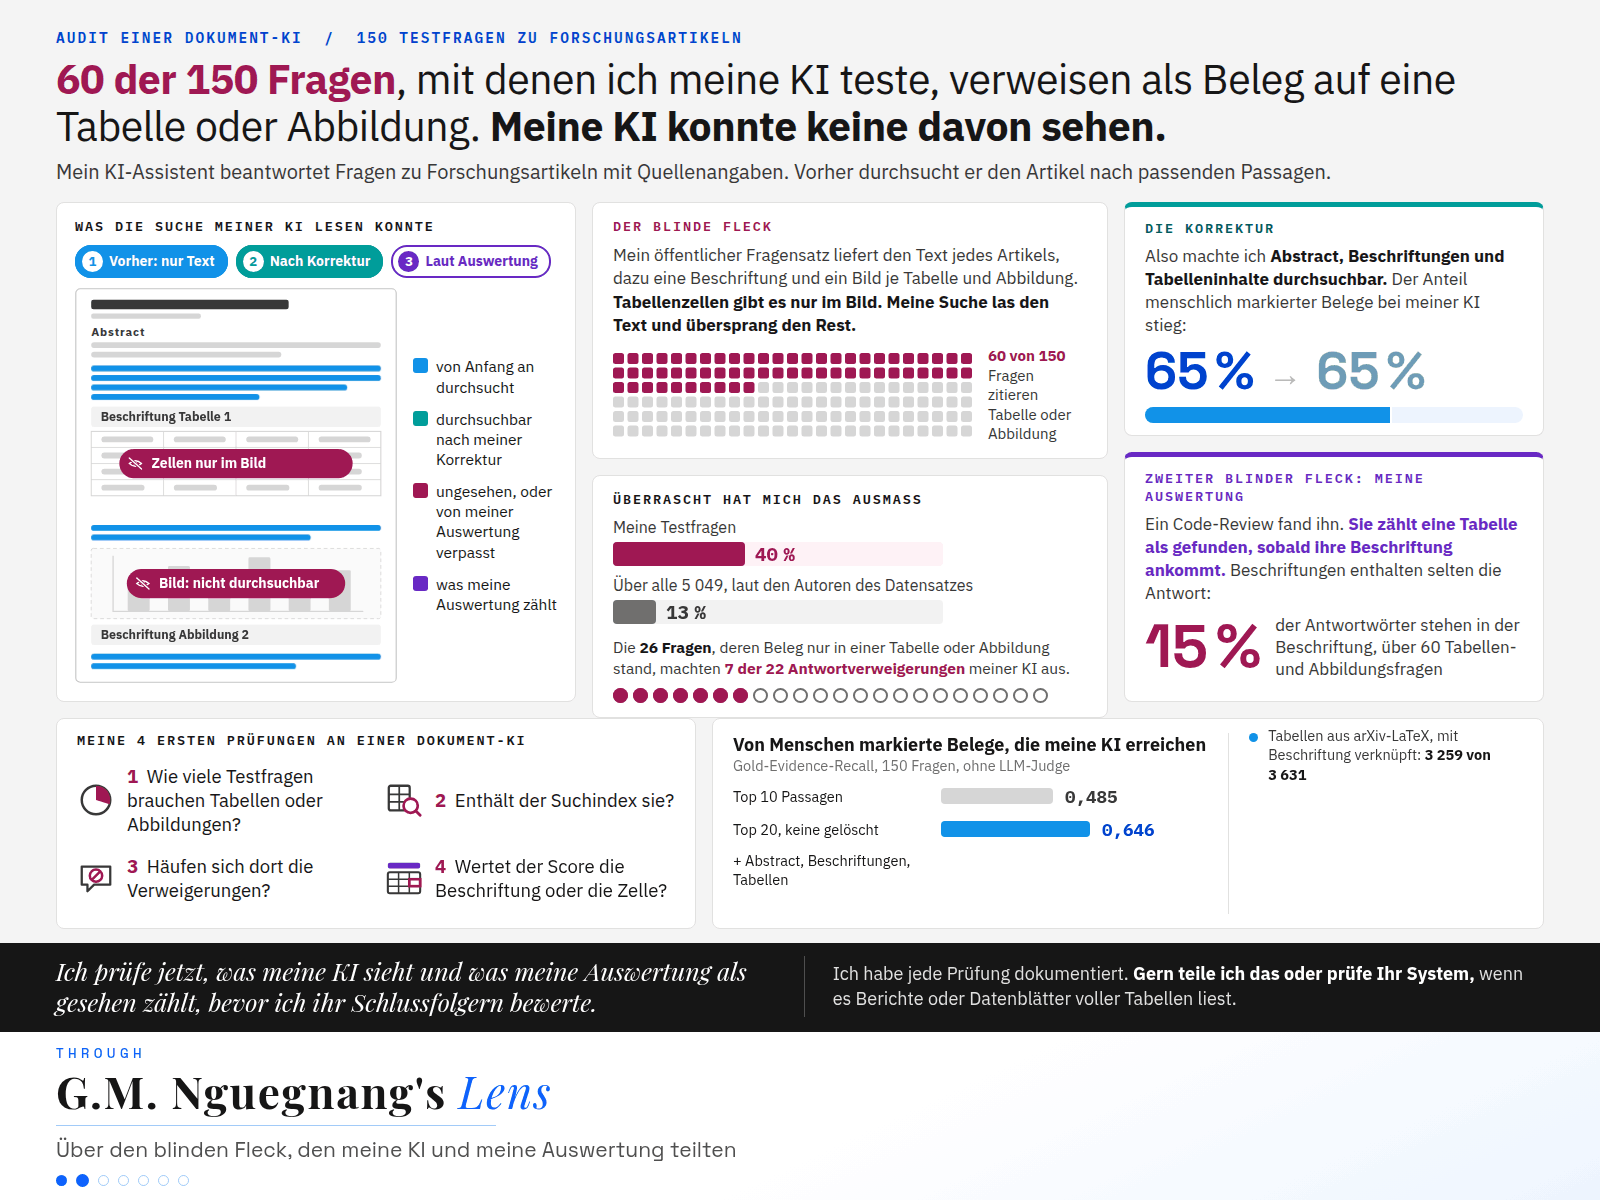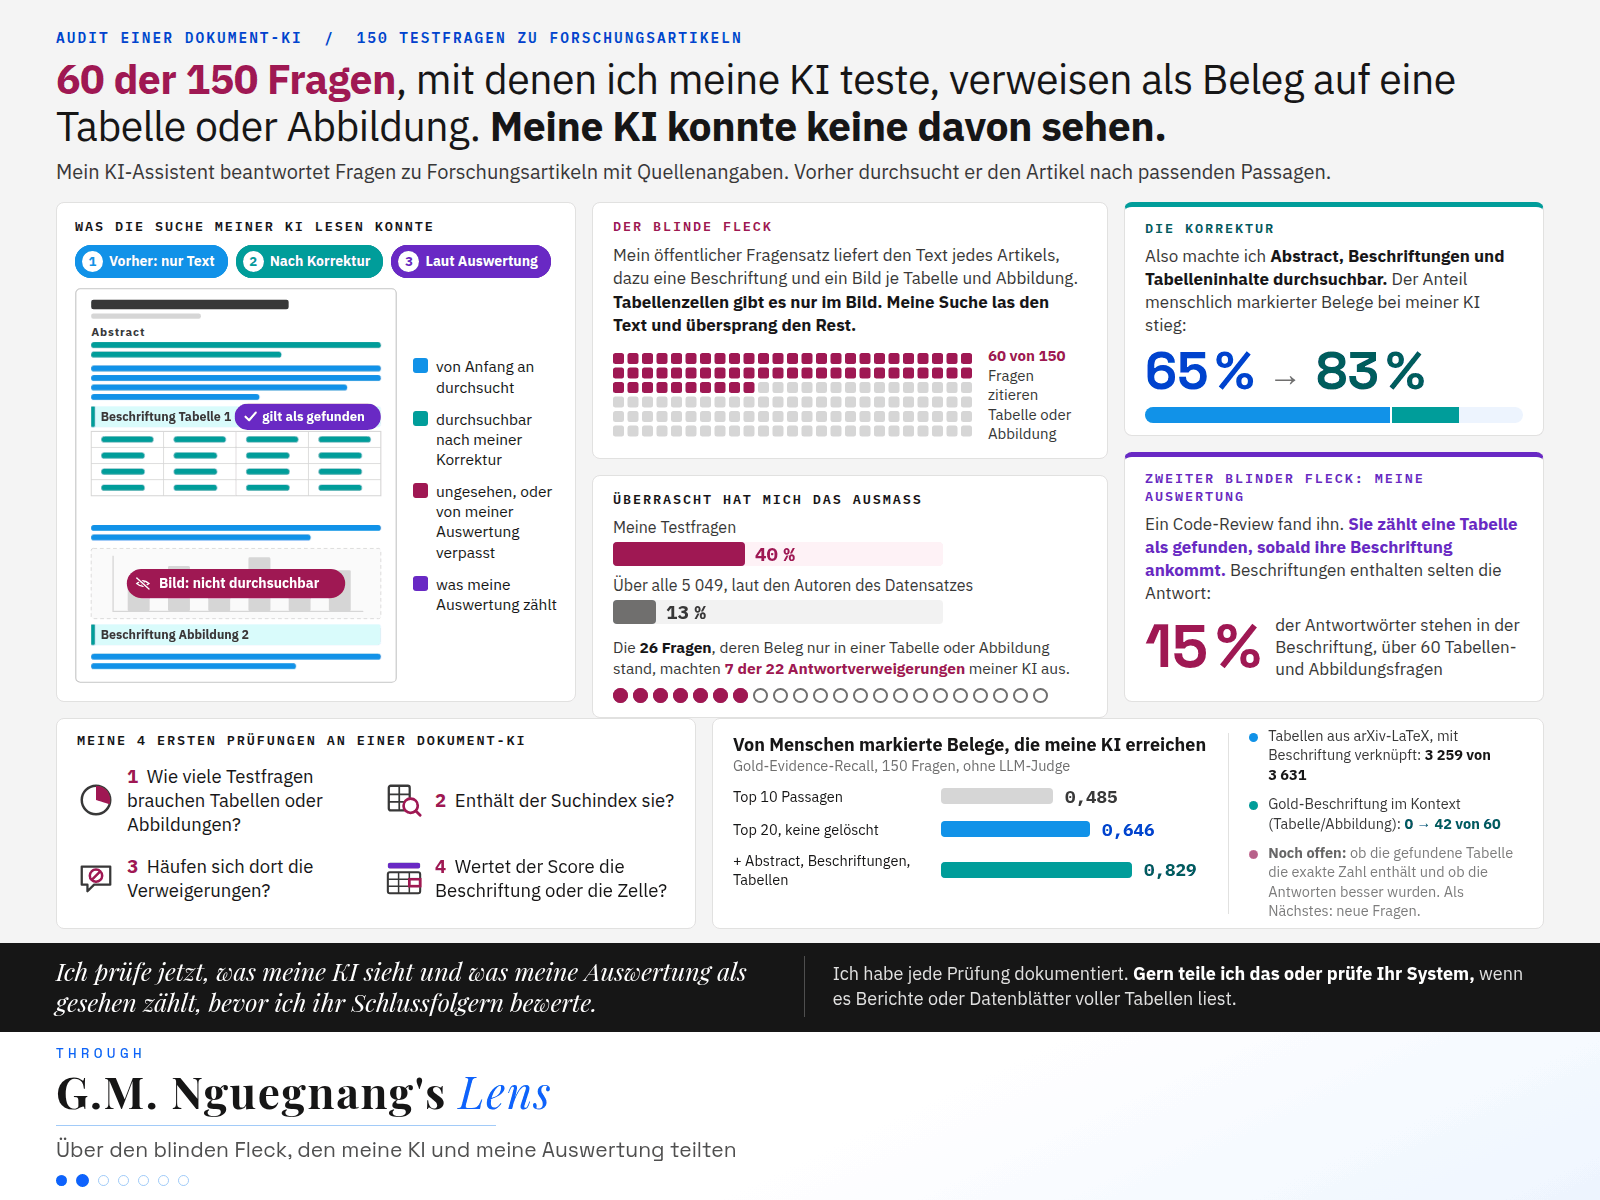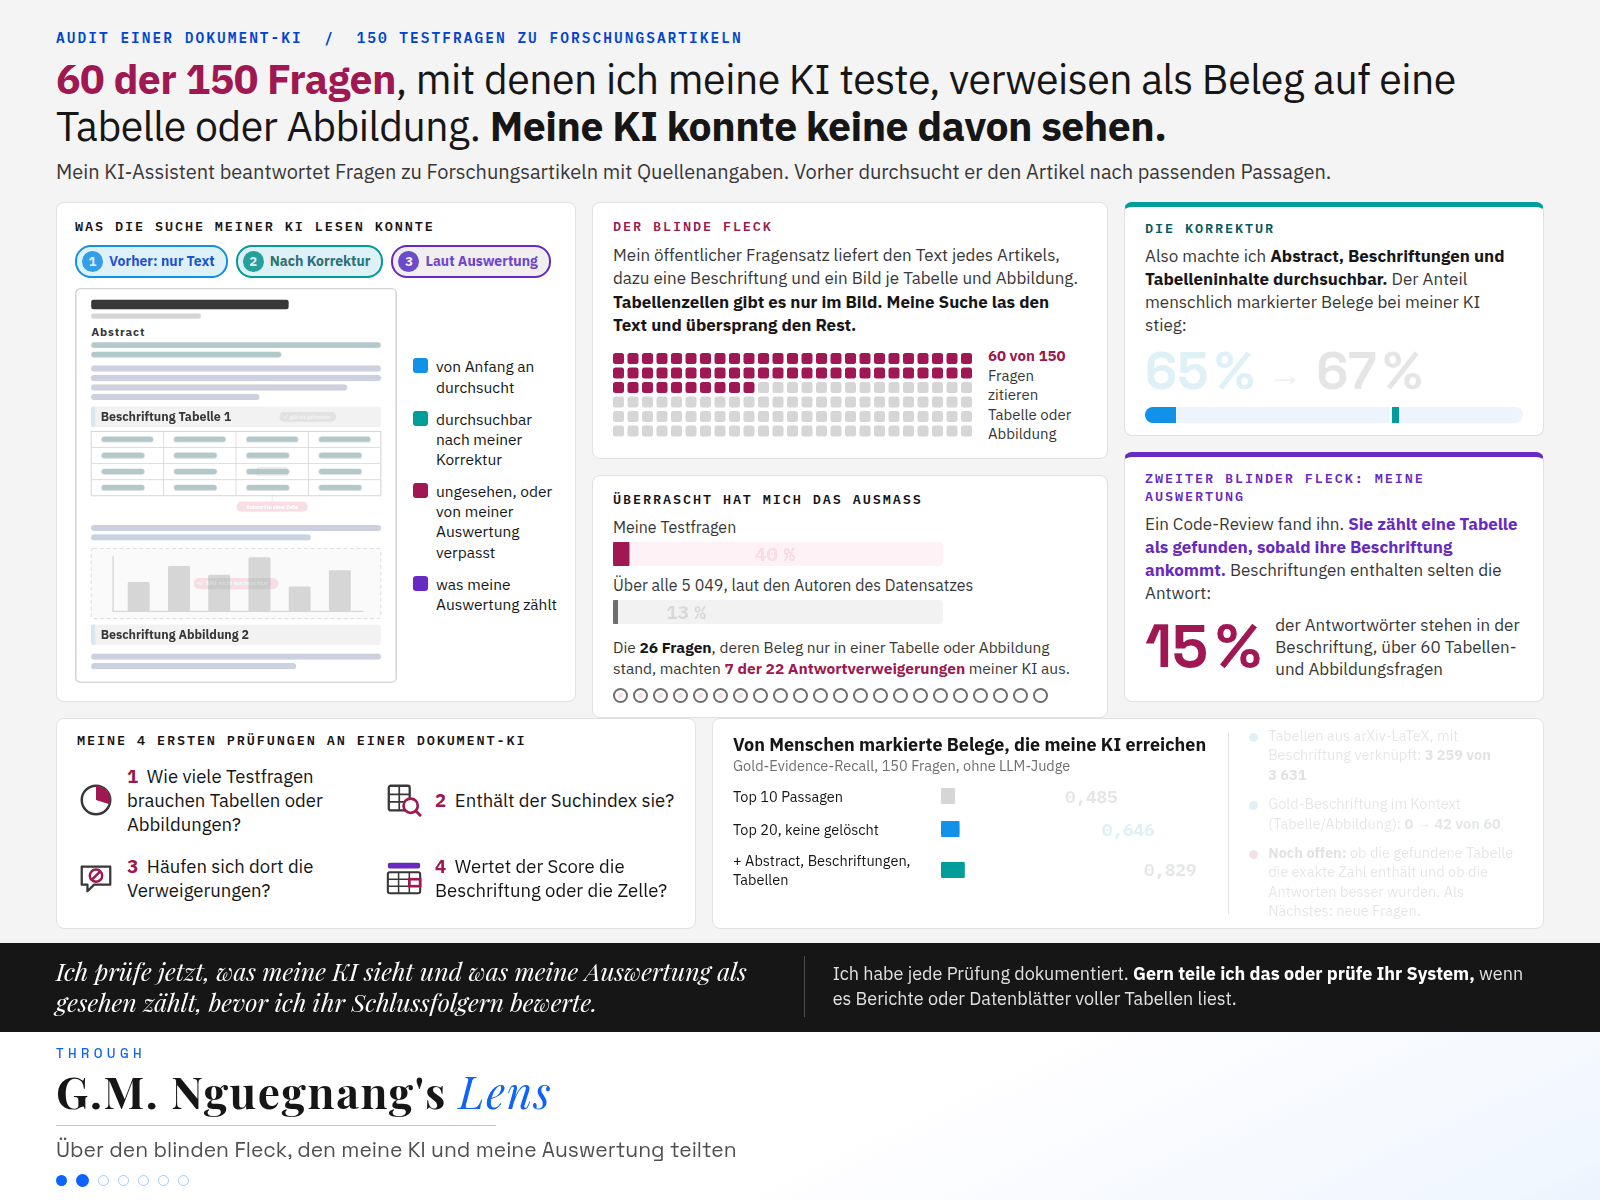
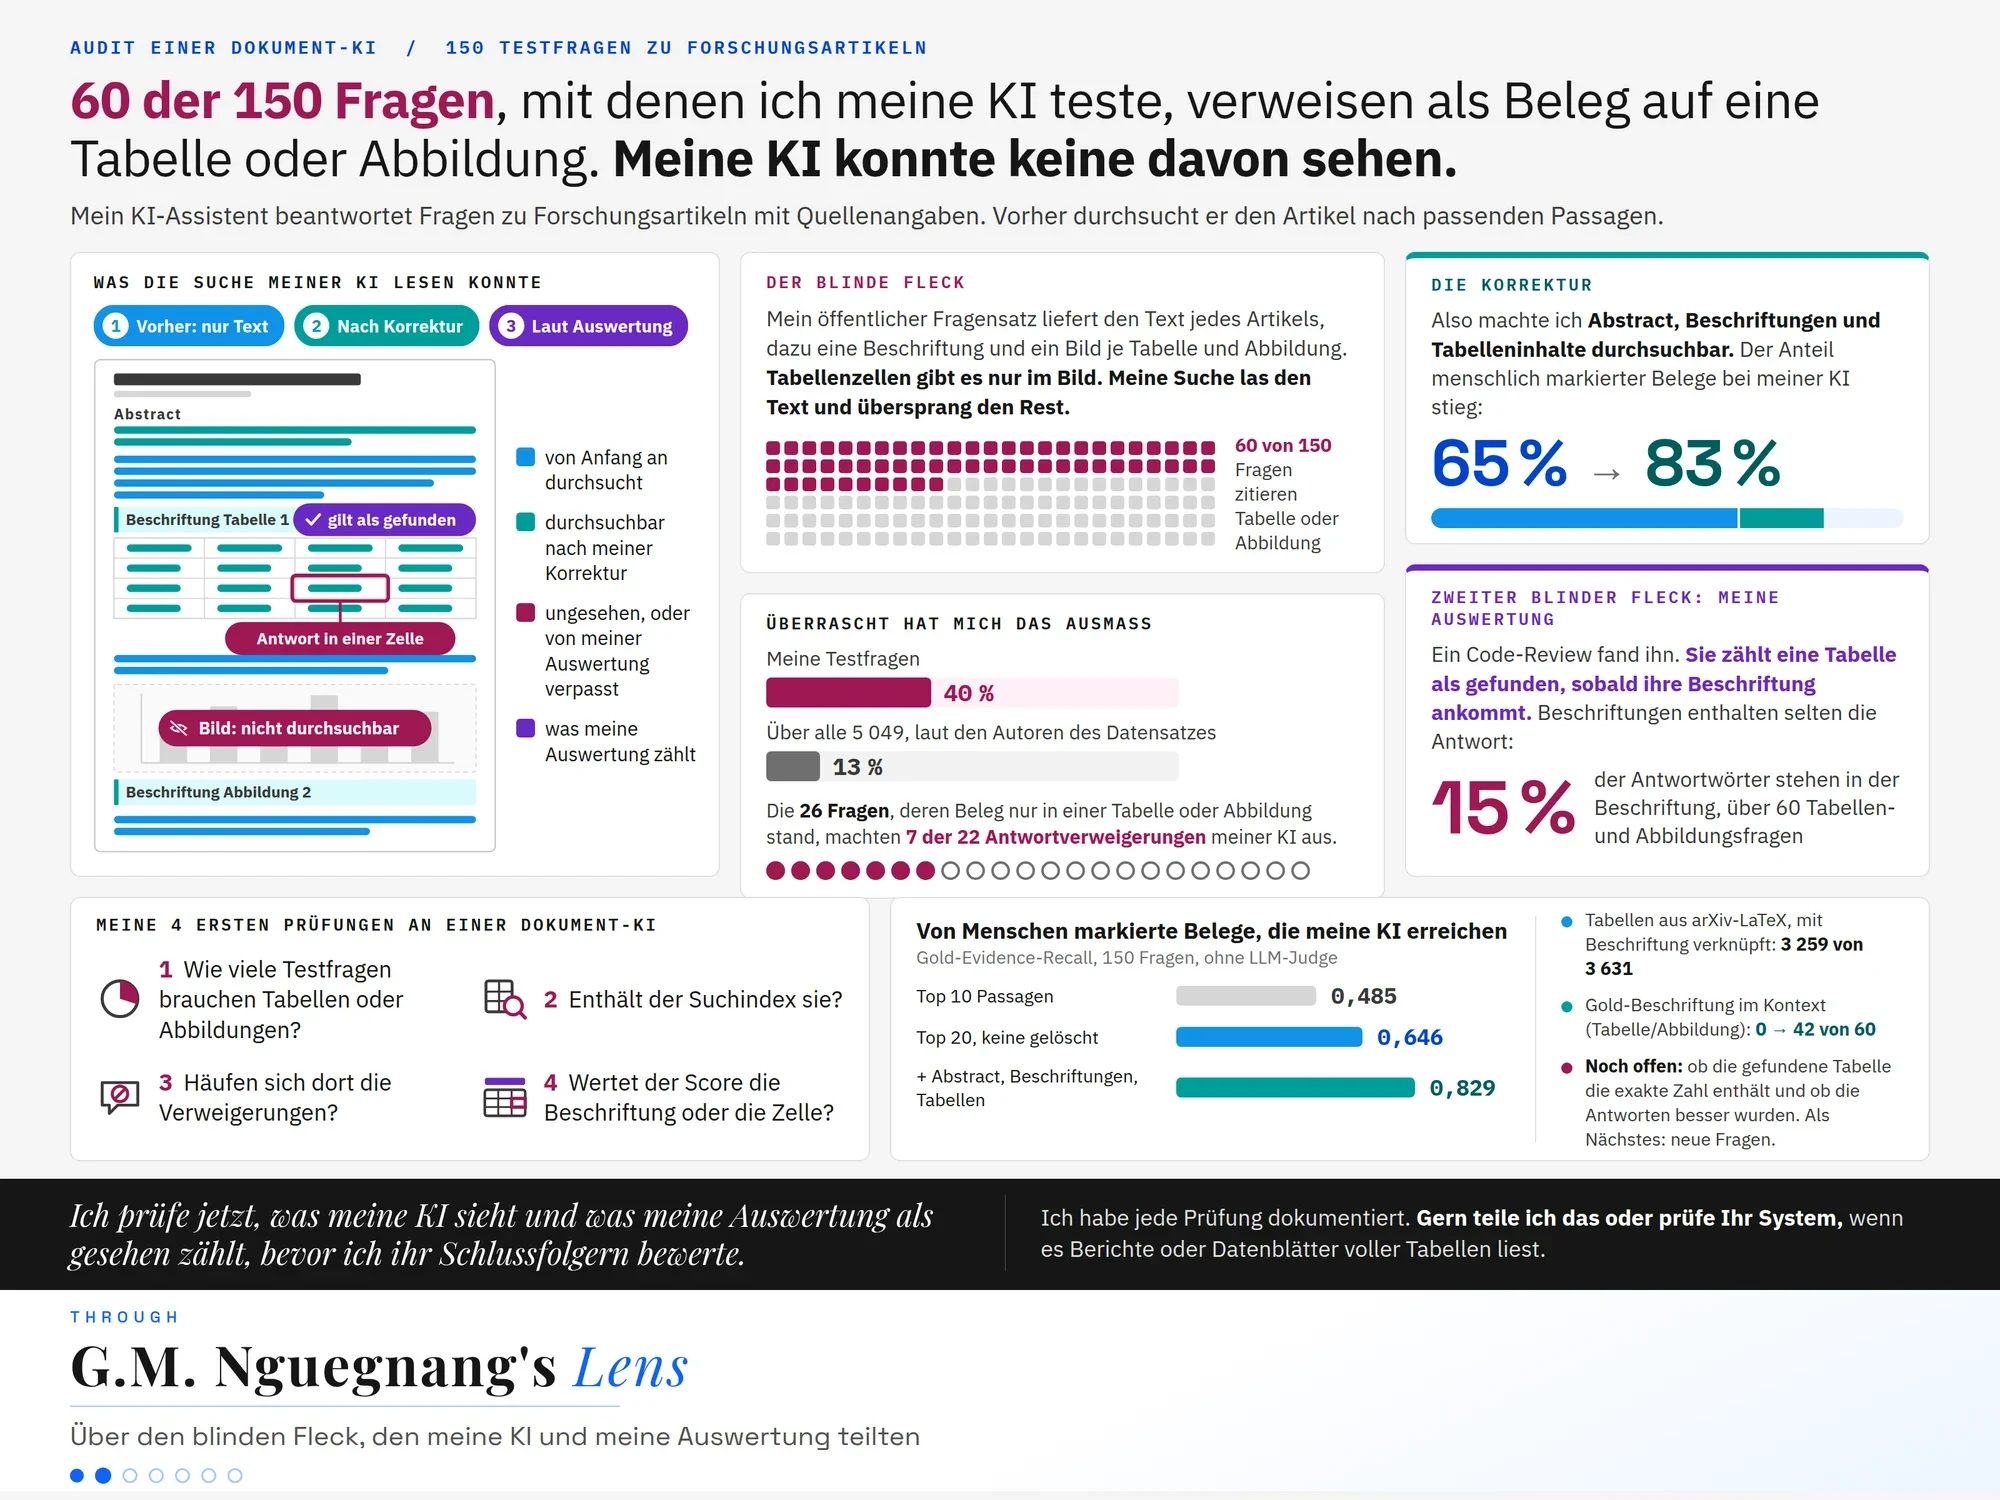
60 der 150 Fragen, mit denen ich meine KI teste, verweisen als Beleg auf eine Tabelle oder Abbildung.
Meine KI konnte keine davon sehen.
Warum das zählt
Ich baue einen KI-Assistenten, der Fragen zu Forschungsartikeln beantwortet und seine Quellen angibt. Bevor er antwortet, durchsucht er den Artikel nach Passagen, die er liest.
Der öffentliche Fragensatz, mit dem ich teste, liefert den Text jedes Artikels, dazu eine Beschriftung und ein Bild für jede Tabelle und Abbildung. In diesen Daten gibt es die Zellen einer Tabelle nur im Bild. Meine Suche las den Text und übersprang den Rest.
Überrascht hat mich das Ausmaß: 40 % meiner Testfragen, gegenüber 13 % über alle 5 049, wie die Autoren des Datensatzes angeben. Die 26 Fragen, deren Beleg nur in einer Tabelle oder Abbildung stand, machten 7 der 22 Antwortverweigerungen meiner KI aus.
Also machte ich Abstract, Beschriftungen und Tabelleninhalte durchsuchbar. Der Anteil der von Menschen markierten Belege, der meine KI erreicht, stieg von 65 % auf 83 %.
Dann fand ein Code-Review einen zweiten blinden Fleck, in meiner eigenen Auswertung. Sie zählt eine Tabelle als gefunden, sobald nur ihre Beschriftung ankommt. Beschriftungen enthalten aber selten die Antwort: Über die 60 Fragen zu Tabellen oder Abbildungen stehen nur 15 % der Antwortwörter in der Beschriftung.
Ich prüfe jetzt, was meine KI sehen kann und was meine Auswertung als gesehen zählt, bevor ich beurteile, wie gut sie schlussfolgert.
Wie es funktioniert
Das Feld figures_and_tables in QASPER enthält eine Beschriftung und einen Bilddateinamen. Die Autoren klammerten diese Fragen in ihren Baselines aus und überließen multimodales Question Answering künftiger Arbeit.
Die Artikel stammen von arXiv, mit LaTeX-Quelltext. Ich parse daher tabular-Umgebungen in Markdown, ordne jede ihrer Beschriftung zu (Dice ≥ 0,6 auf den Wörtern der Beschriftung) und indexiere Beschriftung und Zeilen gemeinsam. 3 259 von 3 631 Tabellenbeschriftungen fanden ihren Tabelleninhalt.
Gold-Evidence-Recall auf den 150 Fragen, ohne LLM als Judge:
- 0,485 → 0,646: 20 Passagen statt 10, keine gelöscht
- 0,829 mit Chunks aus Abstract, Beschriftungen und Tabellen
- Tabellen- und Abbildungsfragen mit der Gold-Beschriftung im Kontext: 0 → 42 von 60
Was ich noch nicht behaupten kann: dass die gefundene Tabelle die exakte gefragte Zahl enthält oder dass die Antworten besser wurden. Ich habe auf diesen 150 Fragen abgestimmt, deshalb teste ich beides als Nächstes auf neuen Fragen.
Die 4 Prüfungen, die ich jetzt zuerst an einer Dokument-KI mache:
- Welcher Anteil der Testfragen stützt sich auf Tabellen oder Abbildungen?
- Enthält der Suchindex sie?
- Häufen sich die Verweigerungen bei diesen Fragen?
- Wertet der Score die Beschriftung oder die Zelle?
Ich habe aufgeschrieben, wie ich jede Prüfung durchgeführt habe. Gern teile ich die Anleitung oder wende die Prüfungen auf Ihr System an, wenn es Berichte oder Datenblätter voller Tabellen liest.