KI-Engineering und Agentic AI
Agentische Systeme und Retrieval
6 Projekte zu Betrieb in der Produktion, Model-Alignment, Retrieval-Forschung und Beratung zu Frontier-Modellen. Jedes endet mit einer Zahl, einem Commit oder einer laufenden Adresse. Öffnen Sie ein Projekt für die ganze Fallstudie.
-
Multi-Agenten-System · ausgerollt
Eine Planerin stellt eine Frage zur Beschaffung in normaler Sprache. Das System rechnet exakt, statt zu schätzen, und hält bei allem über 10.000 $ für eine Freigabe an.
99 % Intent-Genauigkeit auf ungesehenen Anfragen · 168 Tests · 10 Geschäftsintents
Ein LangGraph-Agent leitet die Frage an 1 von 7 exakten Solvern weiter (OR-Tools, CVXPY, SciPy) oder an eine CRAG-Pipeline auf pgvector. Typisierte Pydantic-Eingaben trennen das Modell von den Solvern, und ein Human-Gate hält jede Entscheidung über 10.000 $ an, bis eine Führungskraft sie freigibt.
-
Deployment-Infrastruktur · Produktion
Agentisches ERP: die Deployment-Infrastruktur
AKS · Bicep-IaCDie Pipeline, die den Copilot auf echte Infrastruktur bringt, mit den 6 Prüfungen, die vor jedem Release bestehen müssen.
Bicep-IaC · Kustomize-Overlays · Smoke-Test mit 6 Prüfungen · OTel
Jeder Push durchläuft 6 CI-Jobs, darunter ein Red Team, und übergibt die neuen Images an ein Deployment, das auf die Freigabe einer prüfenden Person wartet. 7 Bicep-Module beschreiben den Azure-Stack, und nach jedem Rollout läuft ein Smoke-Test mit 6 Prüfungen.
-
Model-Alignment · SFT und DPO
Alignment für Finanzfragen mit SFT, RLAIF und DPO
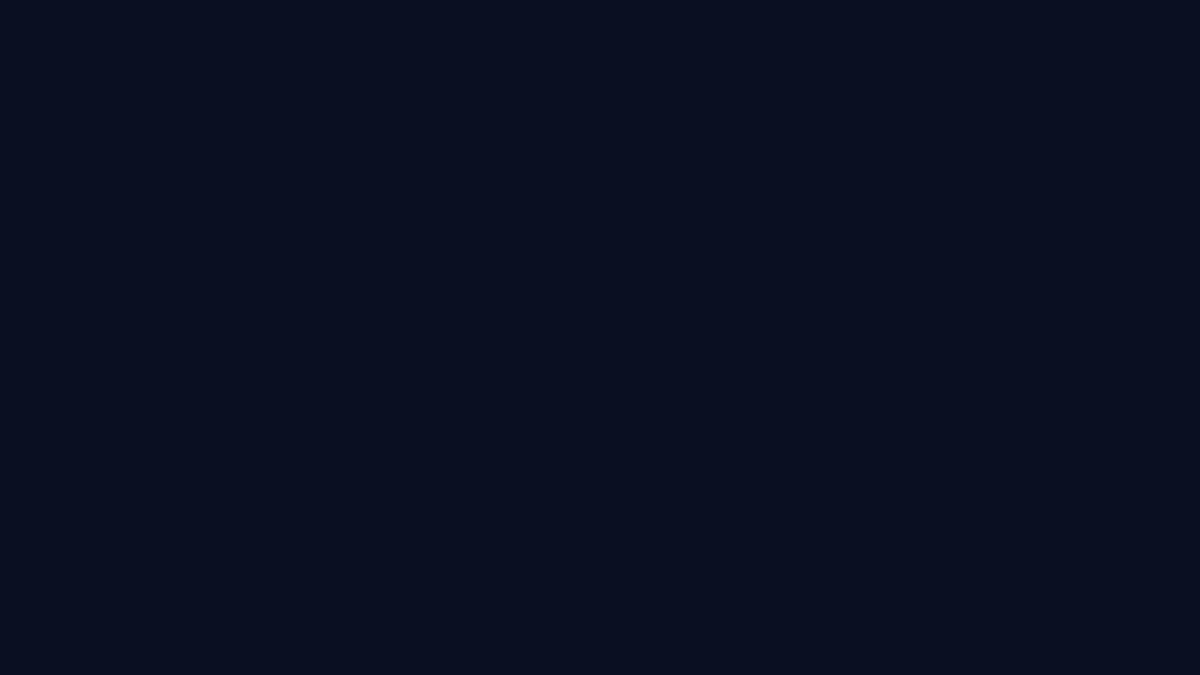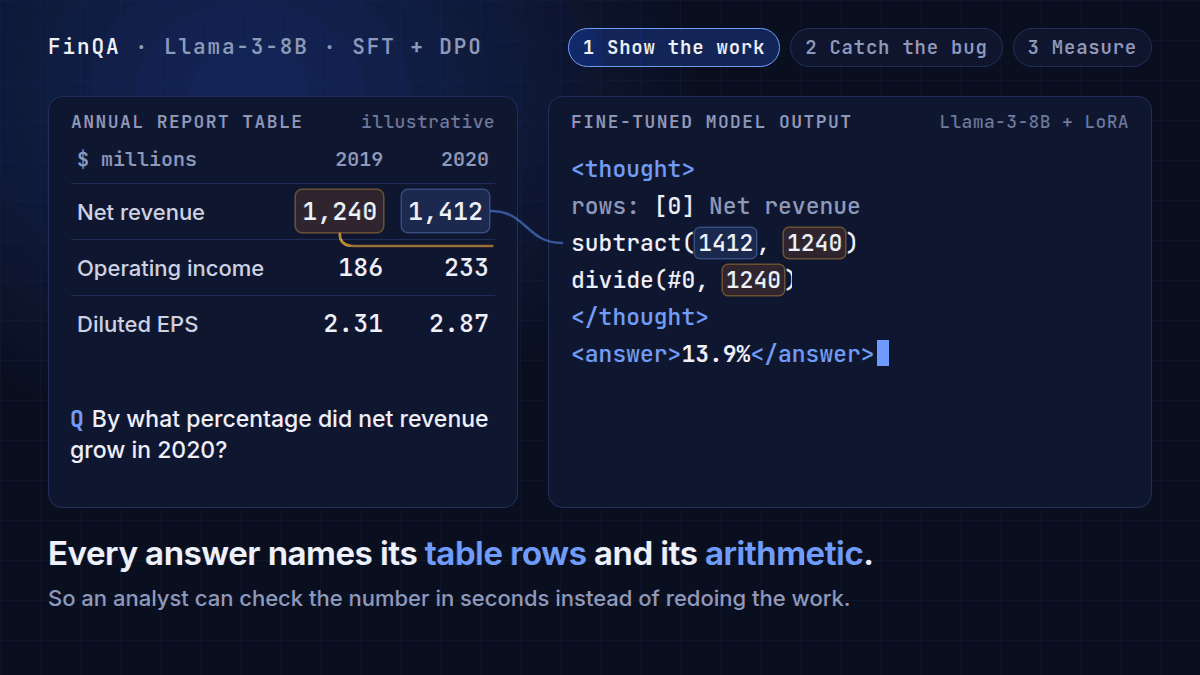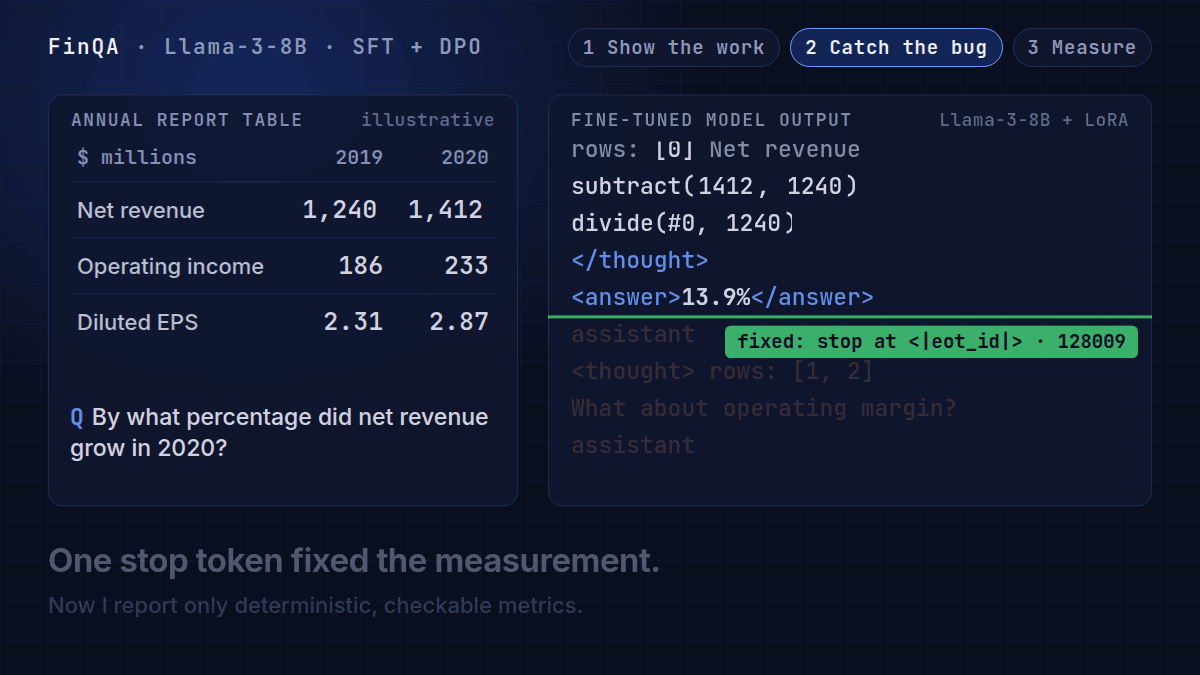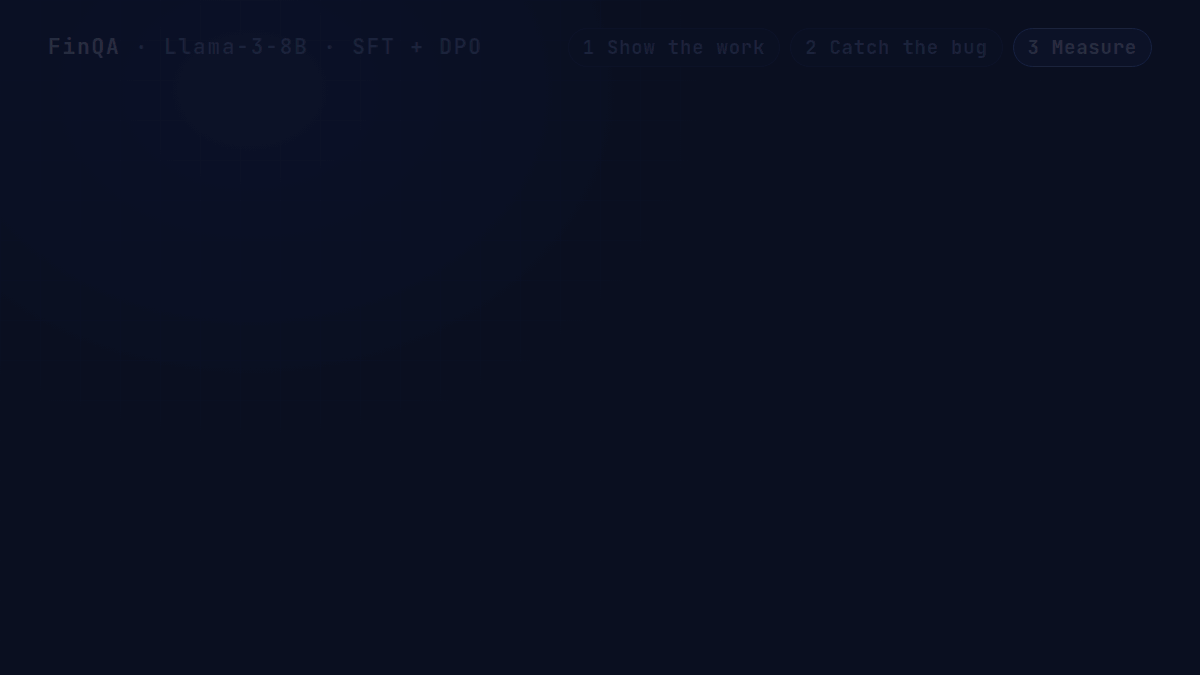
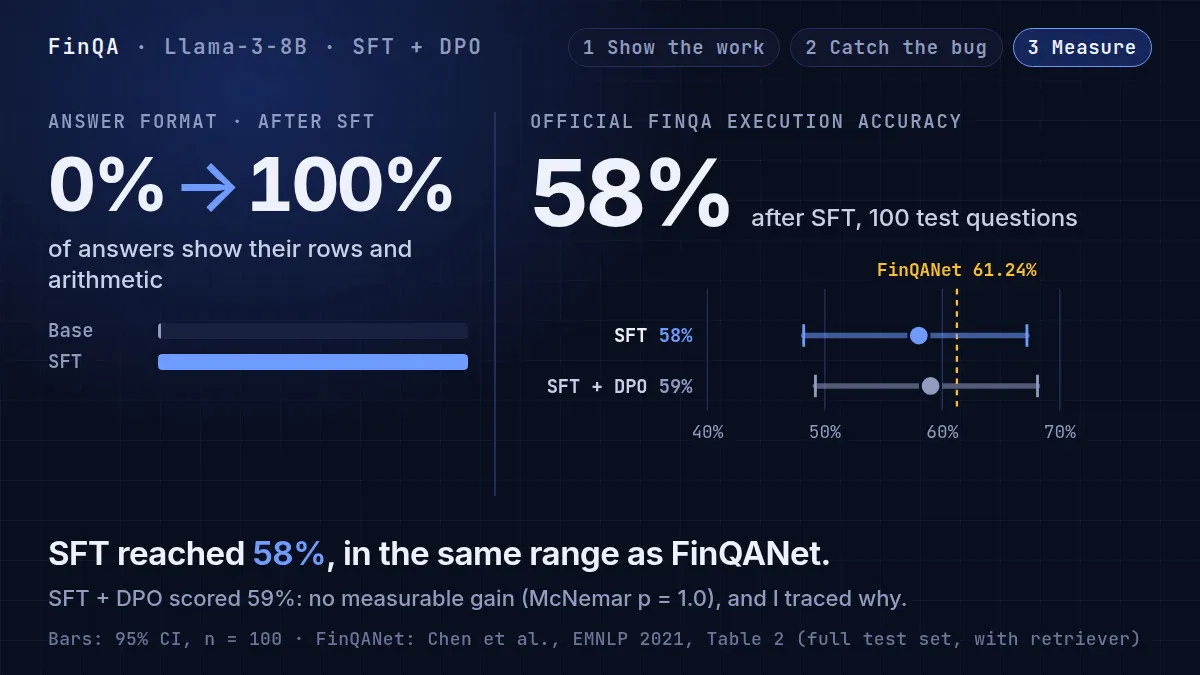
Llama-3-8B · FinQAIch habe einem Modell mit 8 Milliarden Parametern beigebracht, bei Finanzfragen seinen Rechenweg zu zeigen, und dabei einen Messfehler gefunden, der meine eigenen Ergebnisse viel schlechter aussehen ließ, als sie waren.
FinQA-Ausführungsgenauigkeit 58 % (100 Testfragen) · Antwortformat von 0 % auf 100 %
SFT mit LoRA auf einer einzelnen RTX 4090, danach 1 647 von Zephyr-7B-β gelabelte Präferenzpaare und DPO. SFT+DPO kam auf 59 % gegenüber 58 % für SFT (McNemar p = 1,0), und ich habe dieses Nullergebnis auf 3 Ursachen zurückgeführt.
-
RAG in Produktion · ausgerollt
Stellen Sie eine Frage zu einem Bestand an Forschungsarbeiten und erhalten Sie eine Antwort mit ihren Quellen. Sie läuft als zwei Docker-Dienste auf einem Rechner mit GPU.
ALCE-Zitationsgenauigkeit 0,654 · ~47 800 indexierte Chunks · 50 → 7 Textstellen
FastAPI und Chainlit in einem Docker-Compose-Stack aus zwei Diensten, bei jedem Push nach GHCR veröffentlicht. Keine Python-Umgebung einzurichten und kein Index von Hand zu laden.
-
Retrieval-Forschung · laufend
Hybrides RAG für belegte Antworten über Forschungsarbeiten
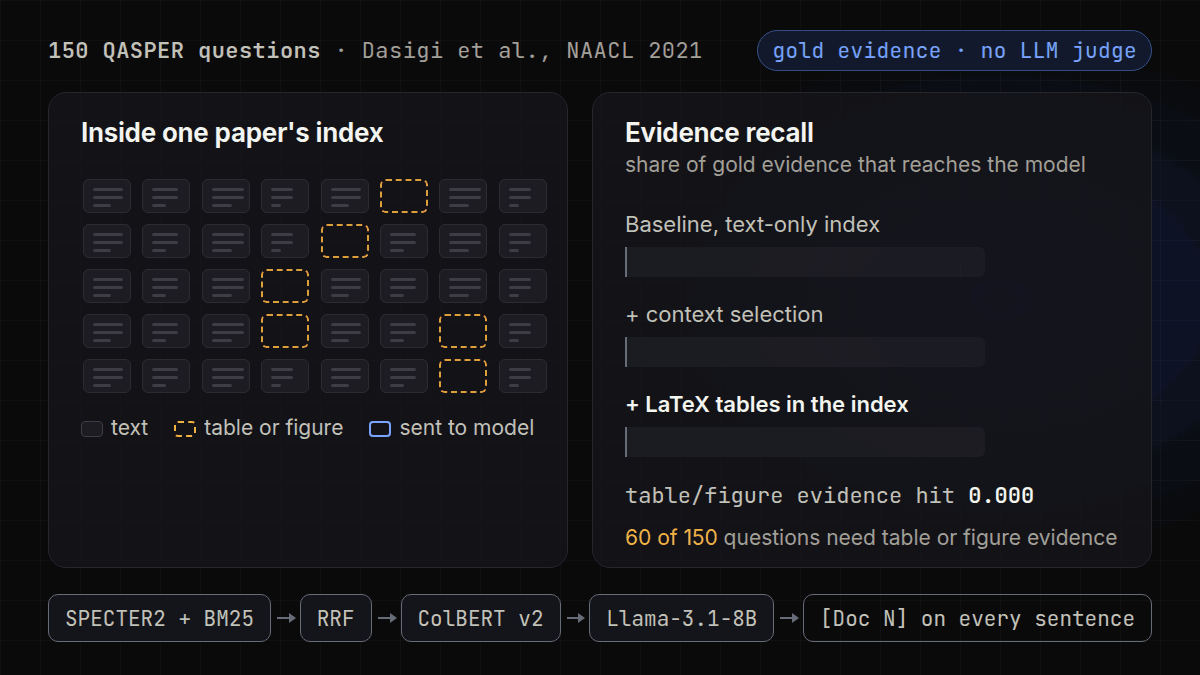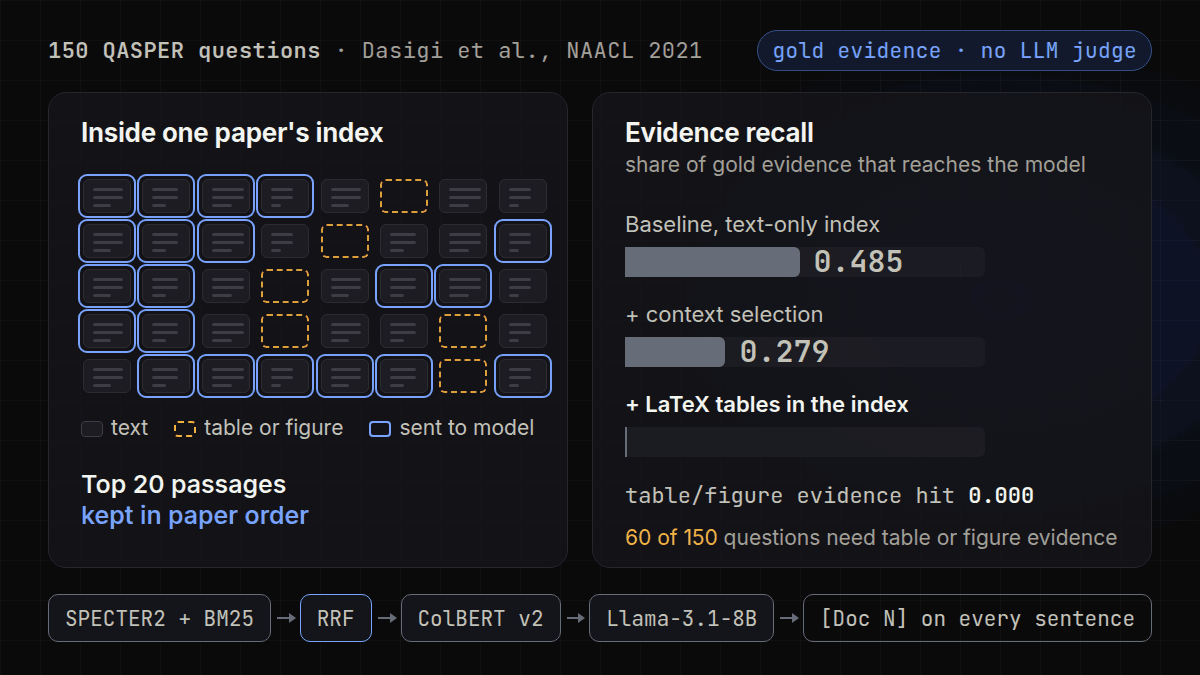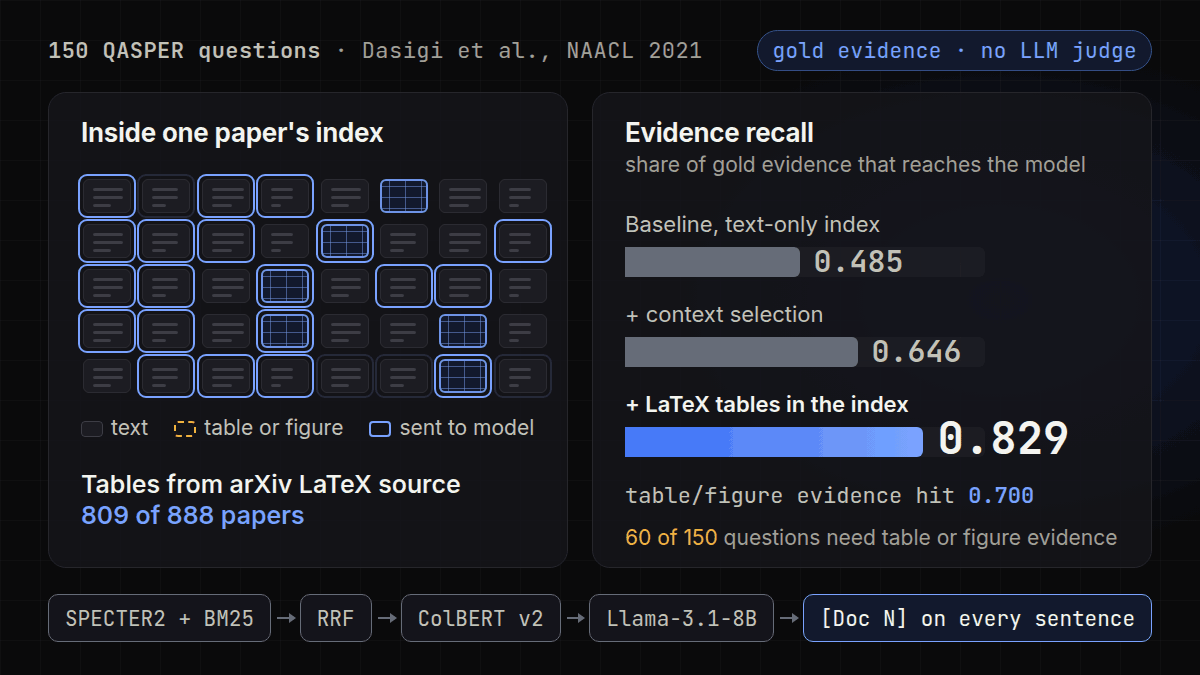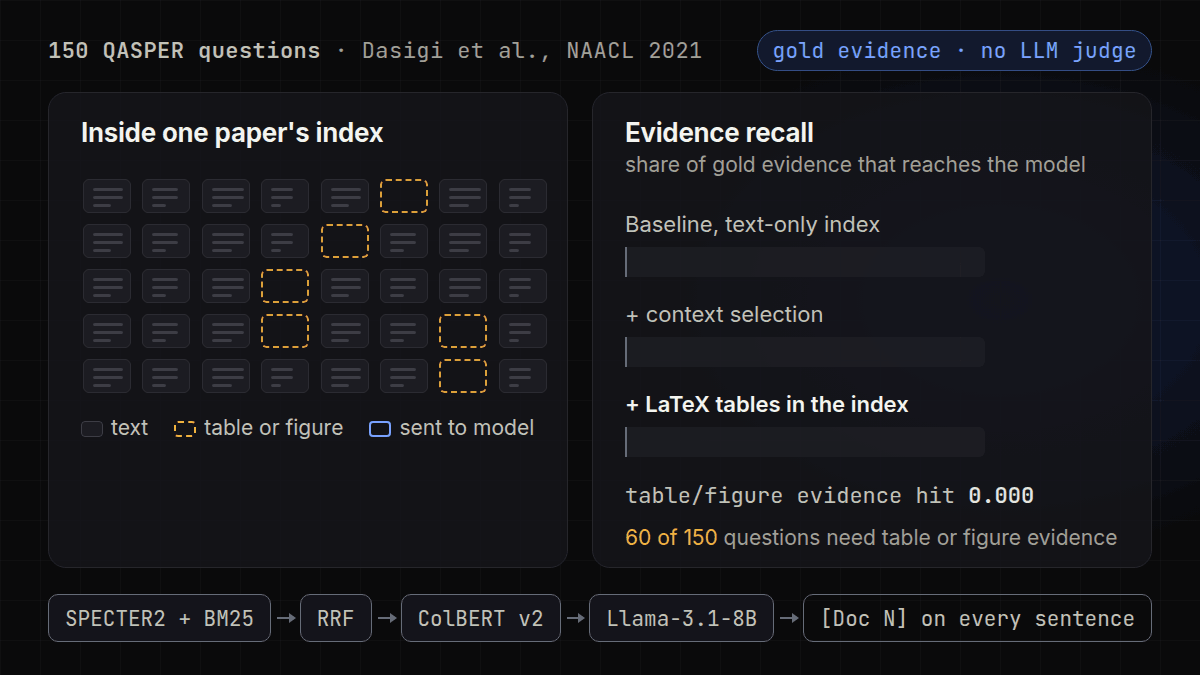
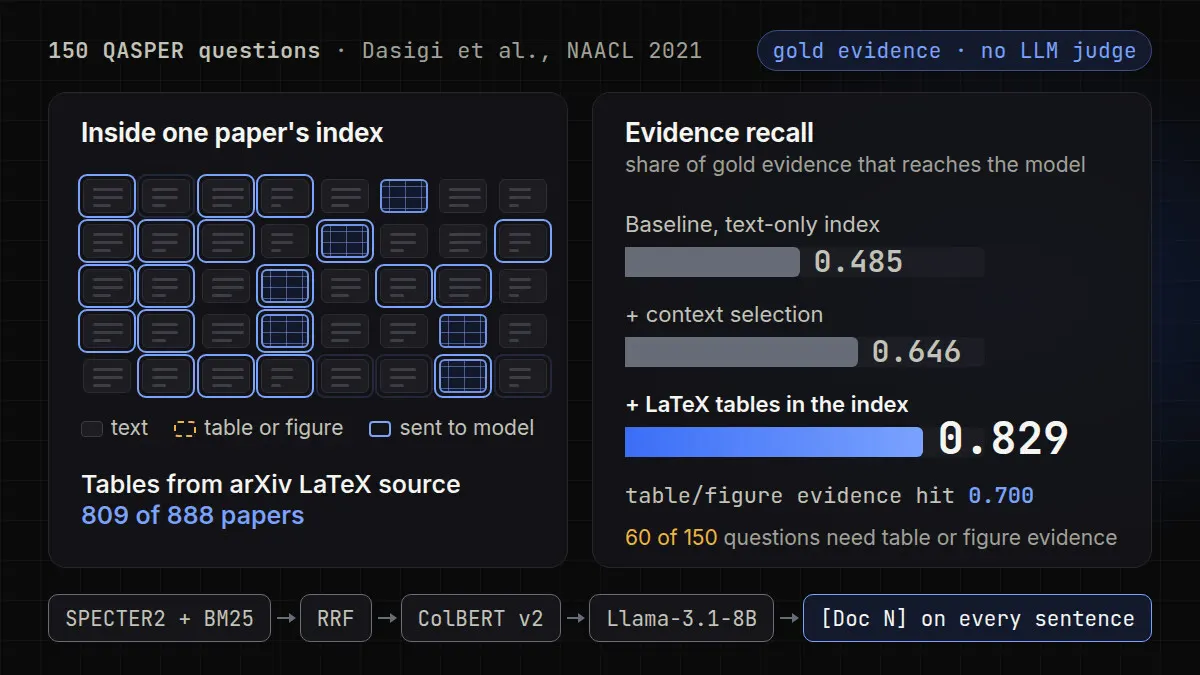
QASPER-BenchmarkEine Pipeline, die Fragen zu Forschungsarbeiten mit einem Zitat in jedem Satz beantwortet, dazu ein Audit meines eigenen Evaluationscodes.
Evidence-Recall von 0,485 auf 0,829 · 150 Fragen · ohne LLM-Richter
Retrieval mit SPECTER2 und BM25, Ranking mit ColBERT v2 und Generierung mit Llama-3.1-8B. Für 809 von 888 Papern habe ich die Tabelleninhalte aus dem LaTeX-Quelltext auf arXiv wiederhergestellt.
-
Alignment von Frontier-Modellen · laufende Beratung
Frontier-Modelle bei schweren naturwissenschaftlichen Aufgaben besser machen, und die Bewertung so bauen, dass sich der Fortschritt messen lässt statt behaupten.
RLHF · RLVR · Bewertungsraster · Chain-of-Thought
RLVR, wo die Antwort objektiv ist, RLHF, wo sie es nicht ist, und Bewertungsraster dazwischen für eine abgestufte Note. Dazu die Analyse von Agenten-Trajektorien und die Präferenzdatensätze, die SFT und DPO speisen.