Ohne Spaltennamen erreichte GPT-4 auf GitHub-Tabellen 0,55 von 1. Auf SAP-Kundentabellen: 0,03
Unternehmenstabellen speichern Codes, nicht ihre Bedeutung. Eine Studie zu GPT-4 auf echten SAP-Kundentabellen zeigt, was eine KI daraus macht: Sie sieht, was geschah, und rät dann, was es bedeutet.
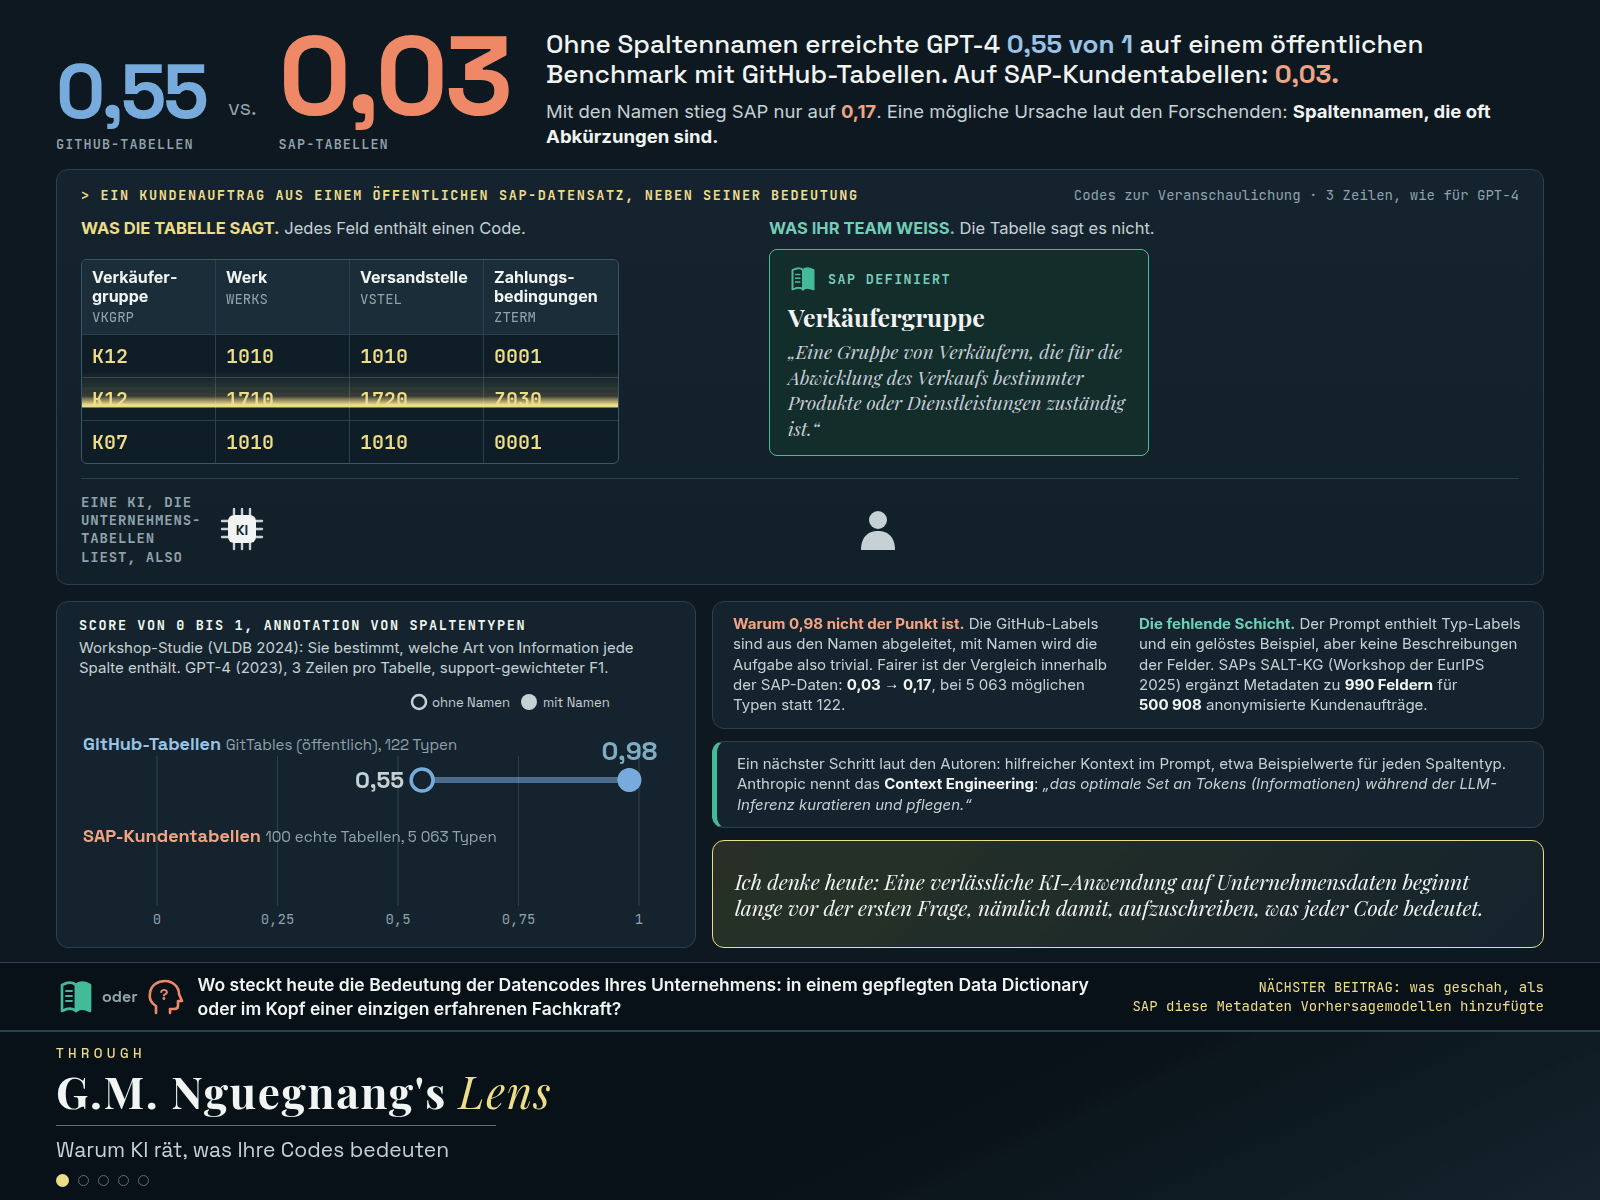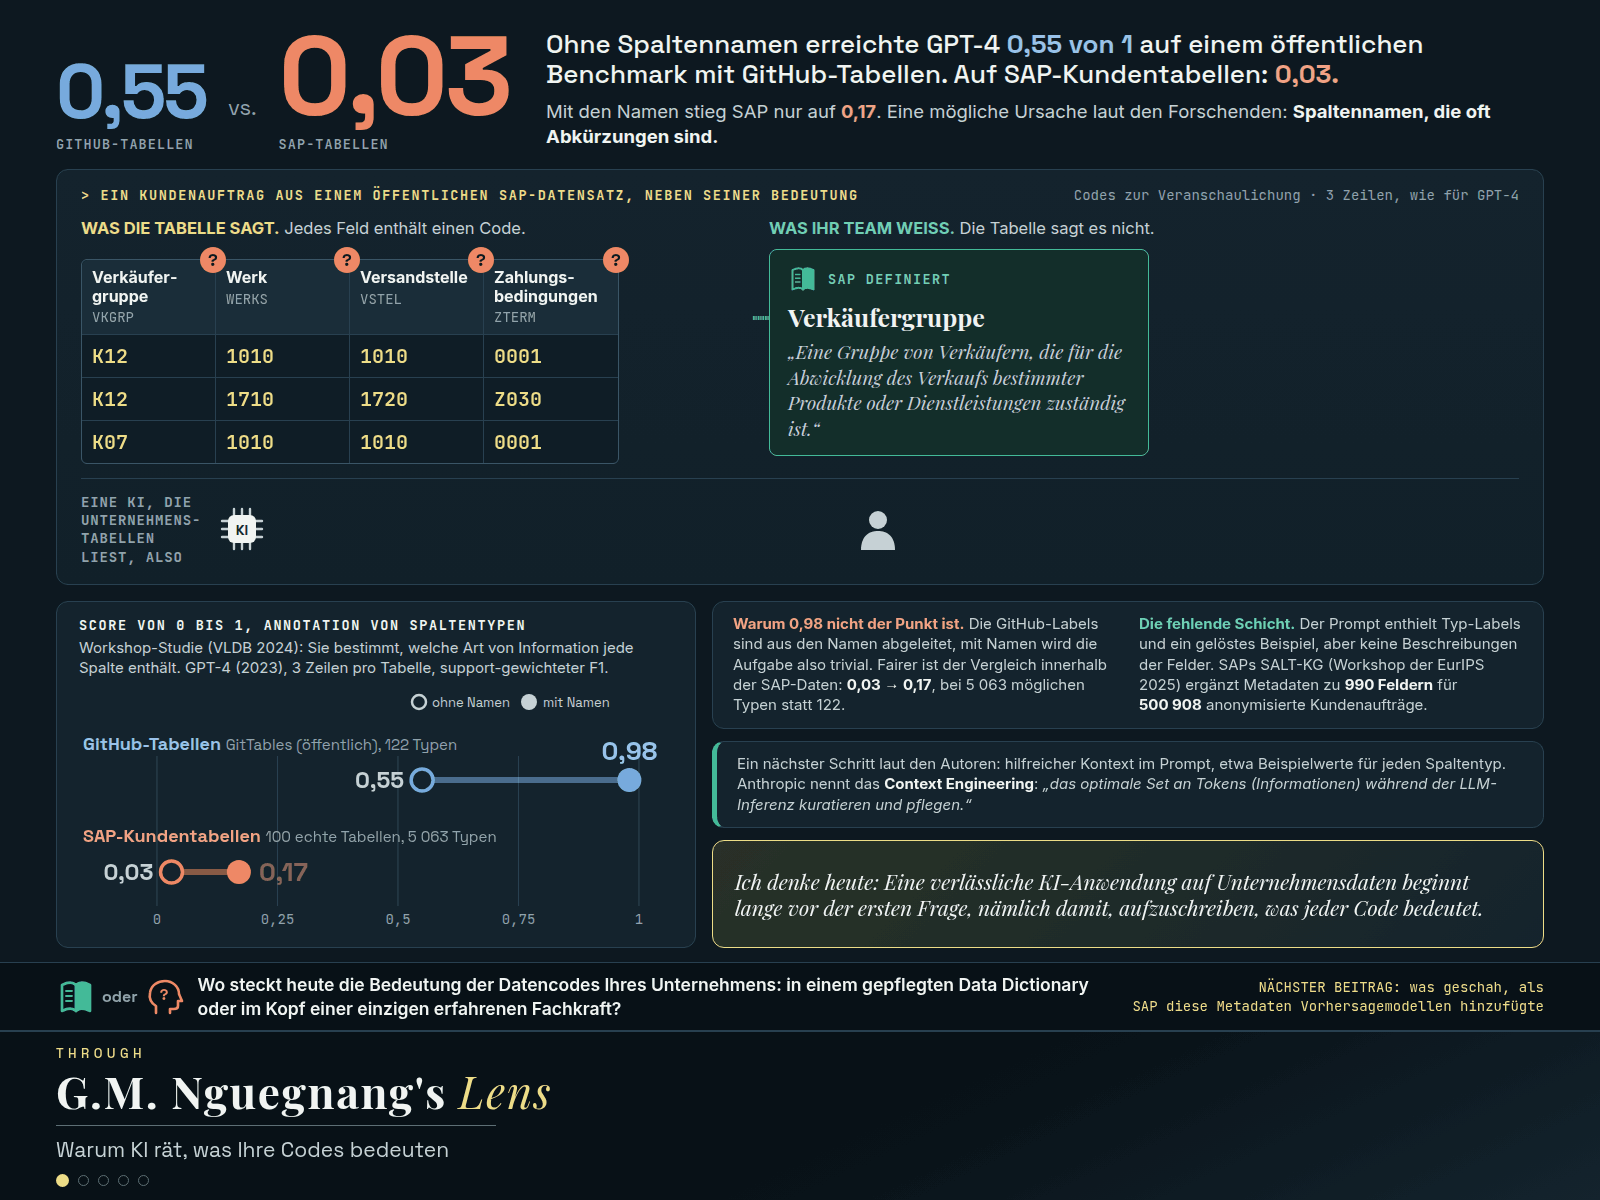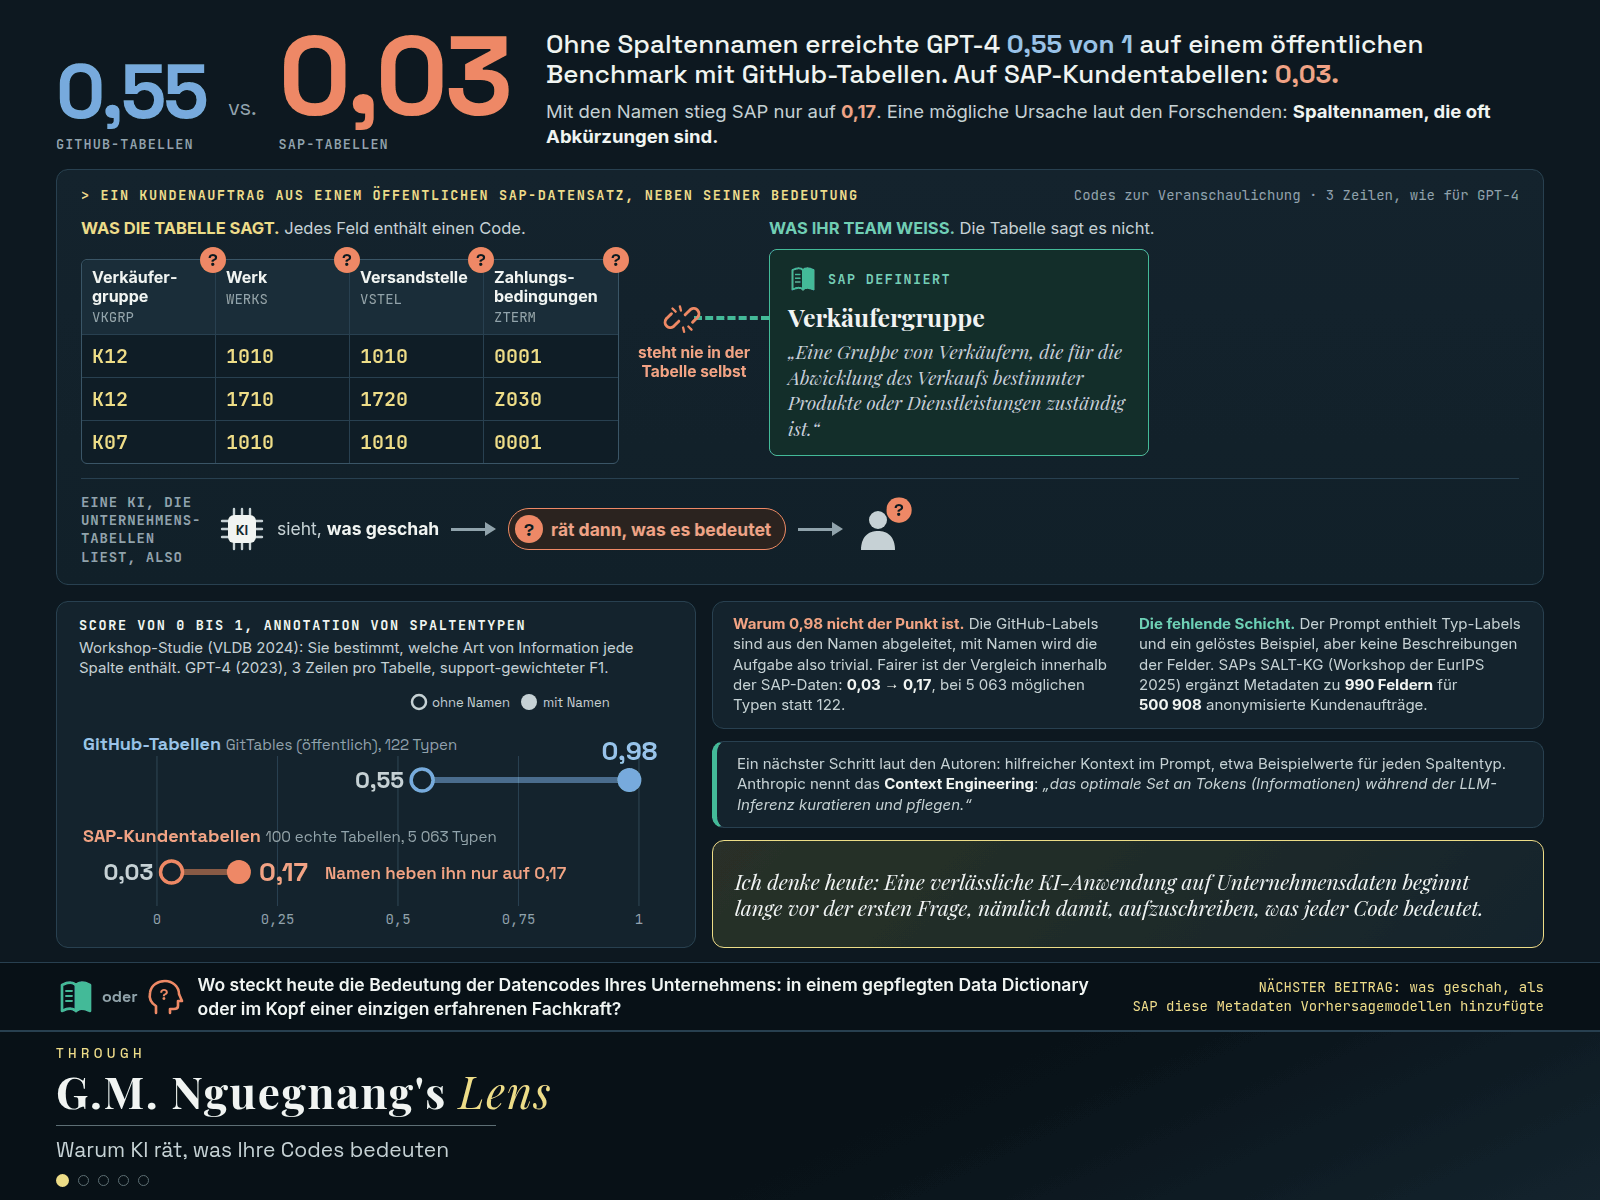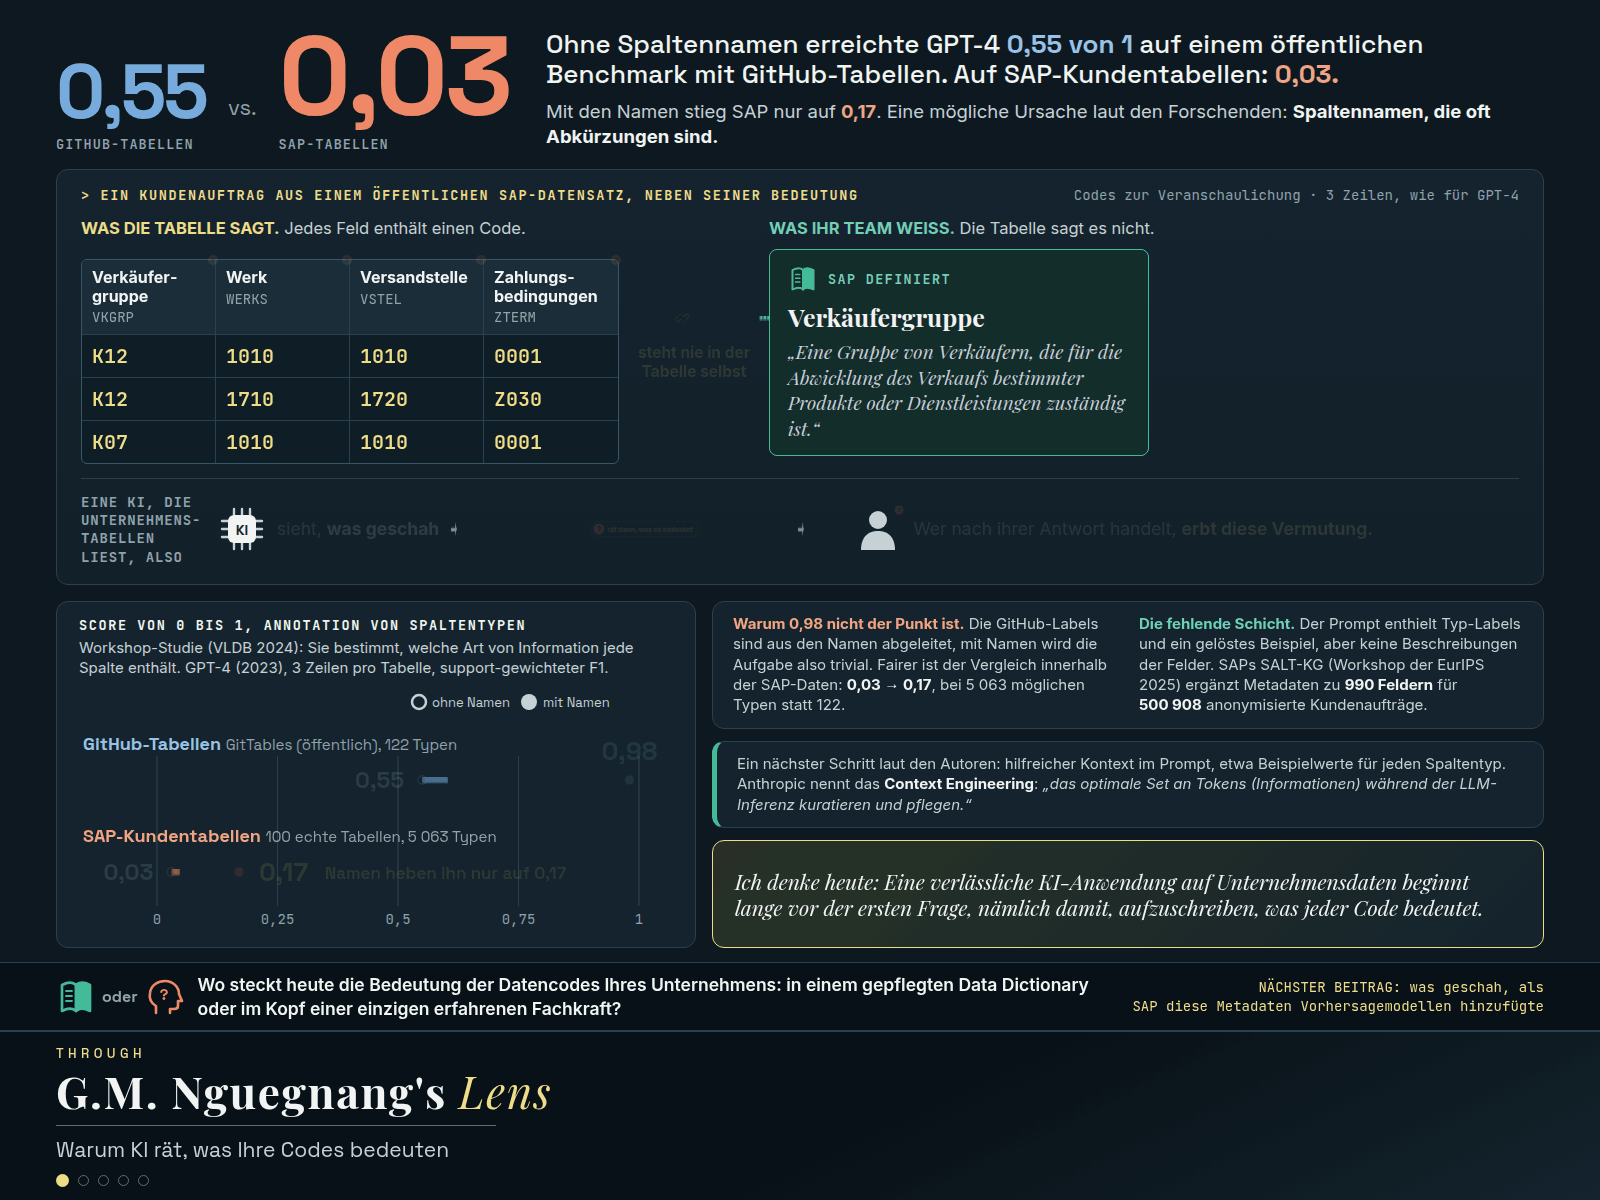
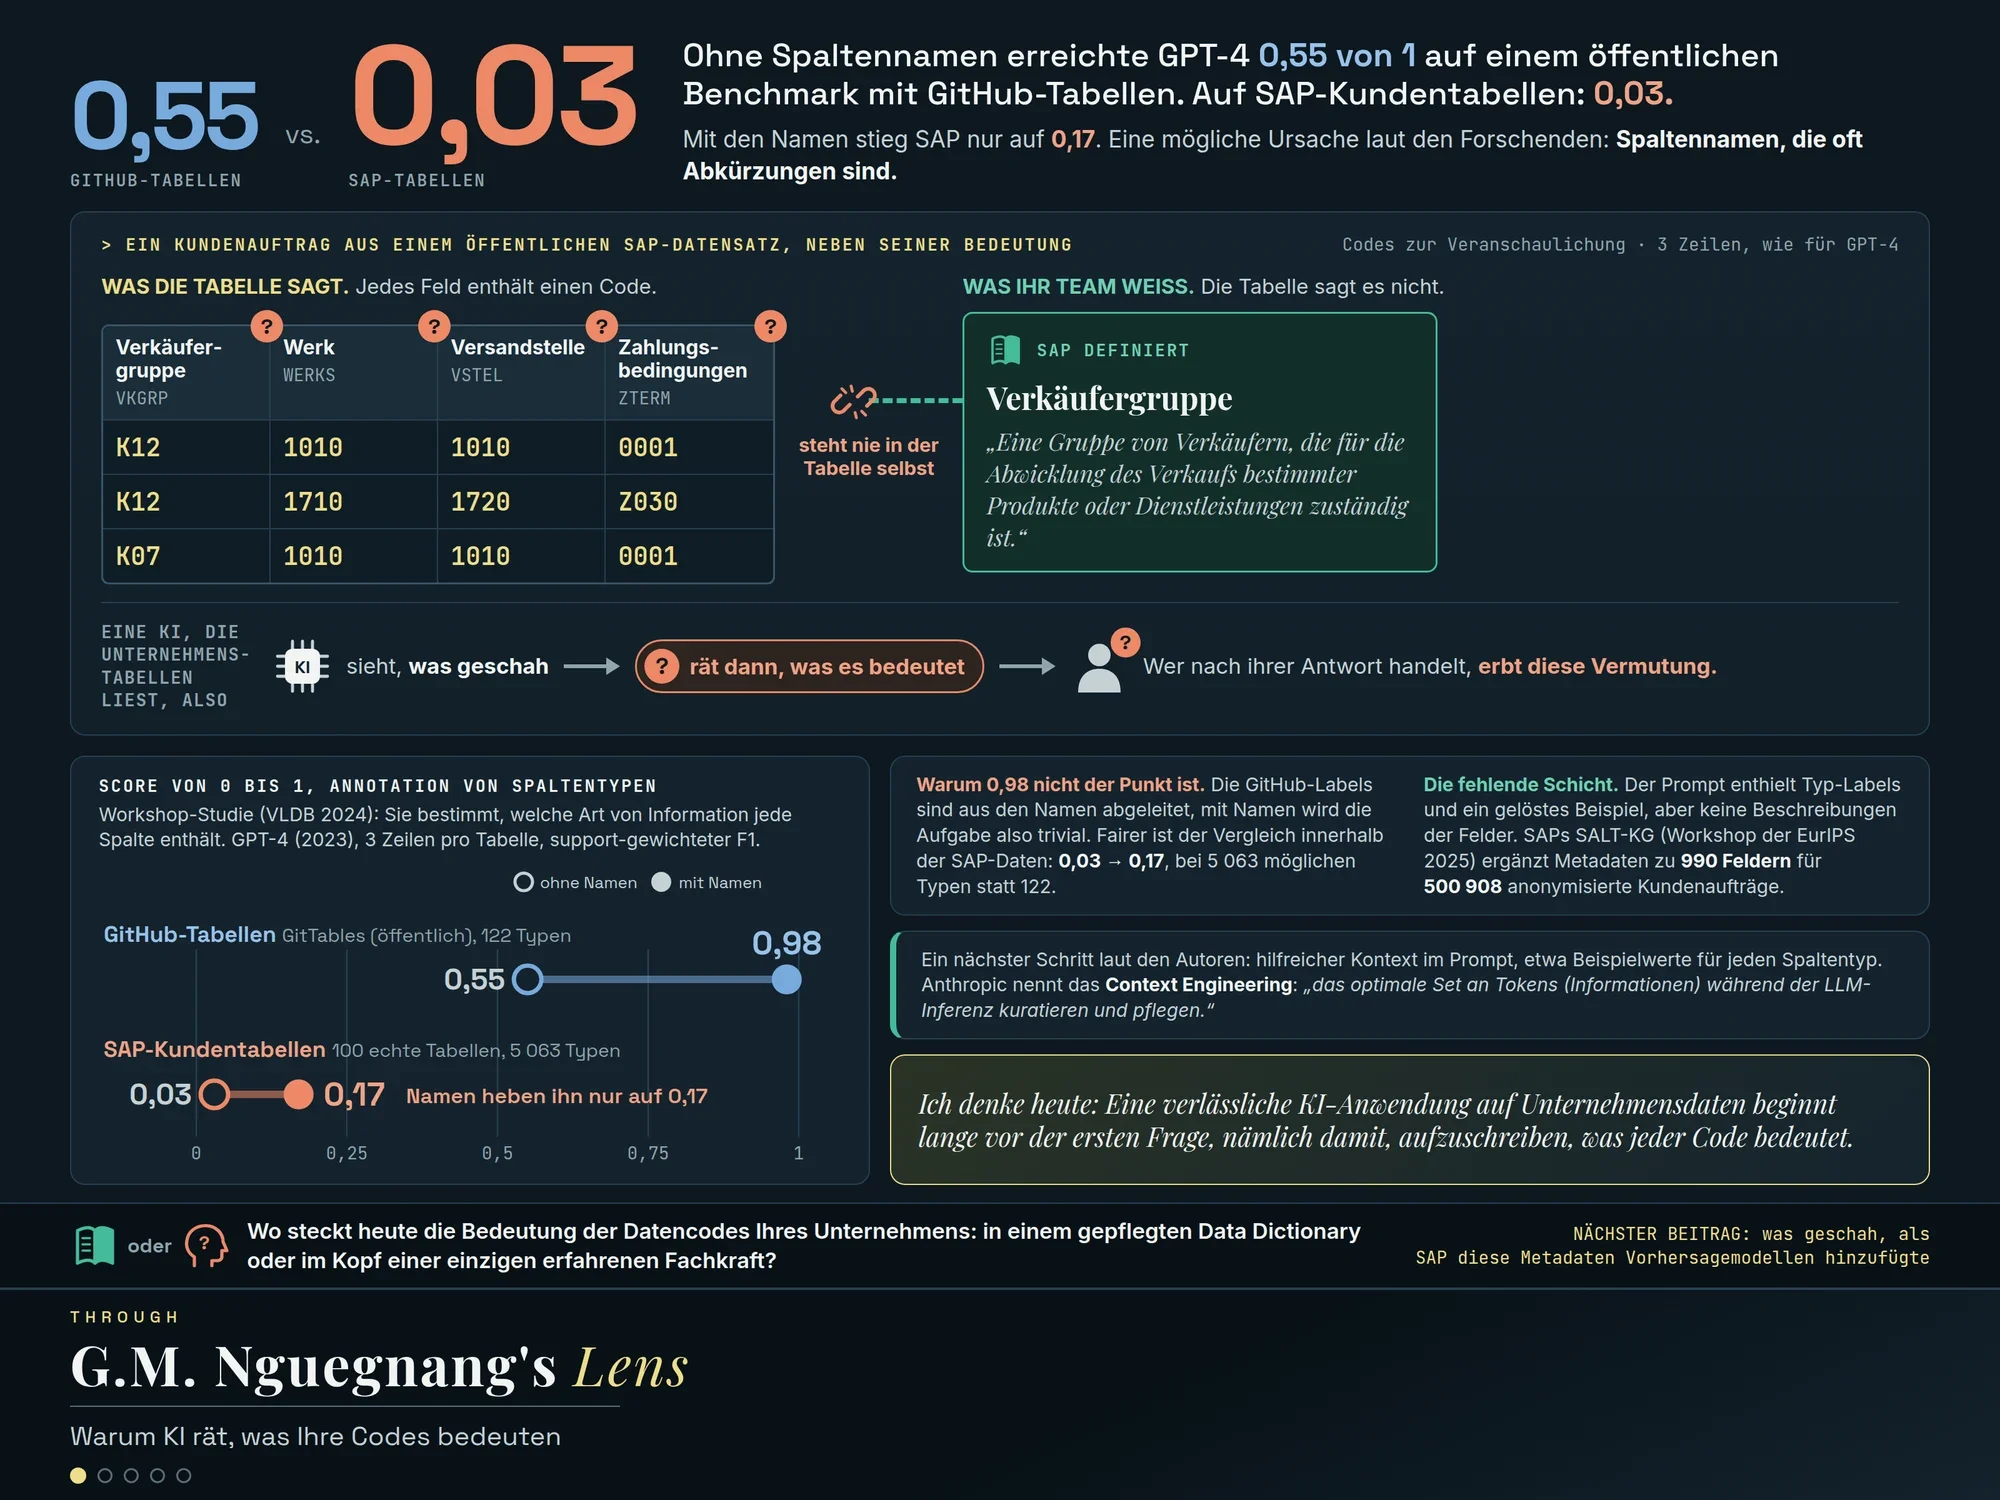
Ohne Spaltennamen erreichte GPT-4 auf einem öffentlichen Benchmark mit GitHub-Tabellen 0,55 von 1. Auf SAP-Kundentabellen: 0,03.
Mit den Namen stieg SAP nur auf 0,17. Eine mögliche Ursache laut den Forschenden: Spaltennamen, die oft Abkürzungen sind.
Warum das zählt
Nehmen wir einen Kundenauftrag aus einem öffentlichen SAP-Datensatz. Er enthält Felder wie Verkäufergruppe, Werk, Versandstelle und Zahlungsbedingungen. Jedes enthält einen Code.
Ihr Team weiß, wofür diese Codes stehen. Die Tabelle sagt es nicht.
SAP definiert die Verkäufergruppe so: „A group of sales people who are responsible for processing sales of certain products or services“ (eine Gruppe von Verkäufern, die für die Abwicklung des Verkaufs bestimmter Produkte oder Dienstleistungen zuständig ist). In den veröffentlichten Vertriebsdaten enthält diese Spalte nur kurze Codes.
Der Satz existiert. In der Tabelle selbst steht er nie, wie die Infografik nebeneinander zeigt.
Eine KI, die Unternehmenstabellen liest, sieht also oft, was geschah, und rät dann, was es bedeutet. Wer nach ihrer Antwort handelt, erbt diese Vermutung.
Ich denke heute: Eine verlässliche KI-Anwendung auf Unternehmensdaten beginnt lange vor der ersten Frage, nämlich damit, aufzuschreiben, was jeder Code bedeutet.
Wie es funktioniert
Die Zahlen stammen aus einer Workshop-Studie der VLDB 2024 zur Annotation von Spaltentypen: Sie bestimmt, welche Art von Information jede Spalte enthält. Der Score ist ein support-gewichteter F1-Wert von 0 bis 1.
Mit Namen liegen die Scores bei 0,98 auf einem öffentlichen GitTables-Ausschnitt gegenüber 0,17 auf 100 echten SAP-Kundentabellen. Diese Lücke wirkt größer, doch die Autoren erklären, warum bestehende Evaluationen die Namen meist weglassen: Die Labels sind aus ihnen abgeleitet, die Aufgabe würde also trivial.
Der SAP-Datensatz hat außerdem 5 063 mögliche Typen statt 122. Fairer ist daher der Vergleich innerhalb der SAP-Daten: Die Namen hoben ein GPT-4 von 2023, dem 3 Zeilen pro Tabelle gezeigt wurden, nur von 0,03 auf 0,17. Der Prompt enthielt eine Liste von Typ-Labels und ein gelöstes Beispiel, aber keine Beschreibungen der Felder.
Ein nächster Schritt, den die Autoren vorschlagen: hilfreicher Kontext im Prompt, etwa Beispielwerte für jeden Spaltentyp. Das gehört zu dem, was Anthropic Context Engineering nennt: „curating and maintaining the optimal set of tokens (information) during LLM inference“, also das optimale Set an Tokens (Informationen) während der LLM-Inferenz kuratieren und pflegen.
SAPs Benchmark SALT-KG (Workshop der EurIPS 2025) baut einen Teil der fehlenden Schicht auf: Metadaten zu 990 Feldern, darunter ein Eintrag für jede Spalte seiner 500 908 anonymisierten Kundenaufträge aus einem echten ERP-System.
Nächster Beitrag: was geschah, als SAP diese Metadaten Vorhersagemodellen hinzufügte.
Wo steckt heute die Bedeutung der Datencodes Ihres Unternehmens: in einem gepflegten Data Dictionary oder im Kopf einer einzigen erfahrenen Fachkraft?