131 meiner 150 Antworten enthielten Quellenangaben. Mein Prüfprogramm bewertete sie mit 0,012 von 1
Ich habe ein System gebaut, das Fragen zu Forschungsartikeln beantwortet und seine Quellen angibt, dann ein zweites Programm, das es bewertet. Defekt war das Prüfprogramm: Ich fand 4 Probleme, behob 3, und eines ist noch offen.
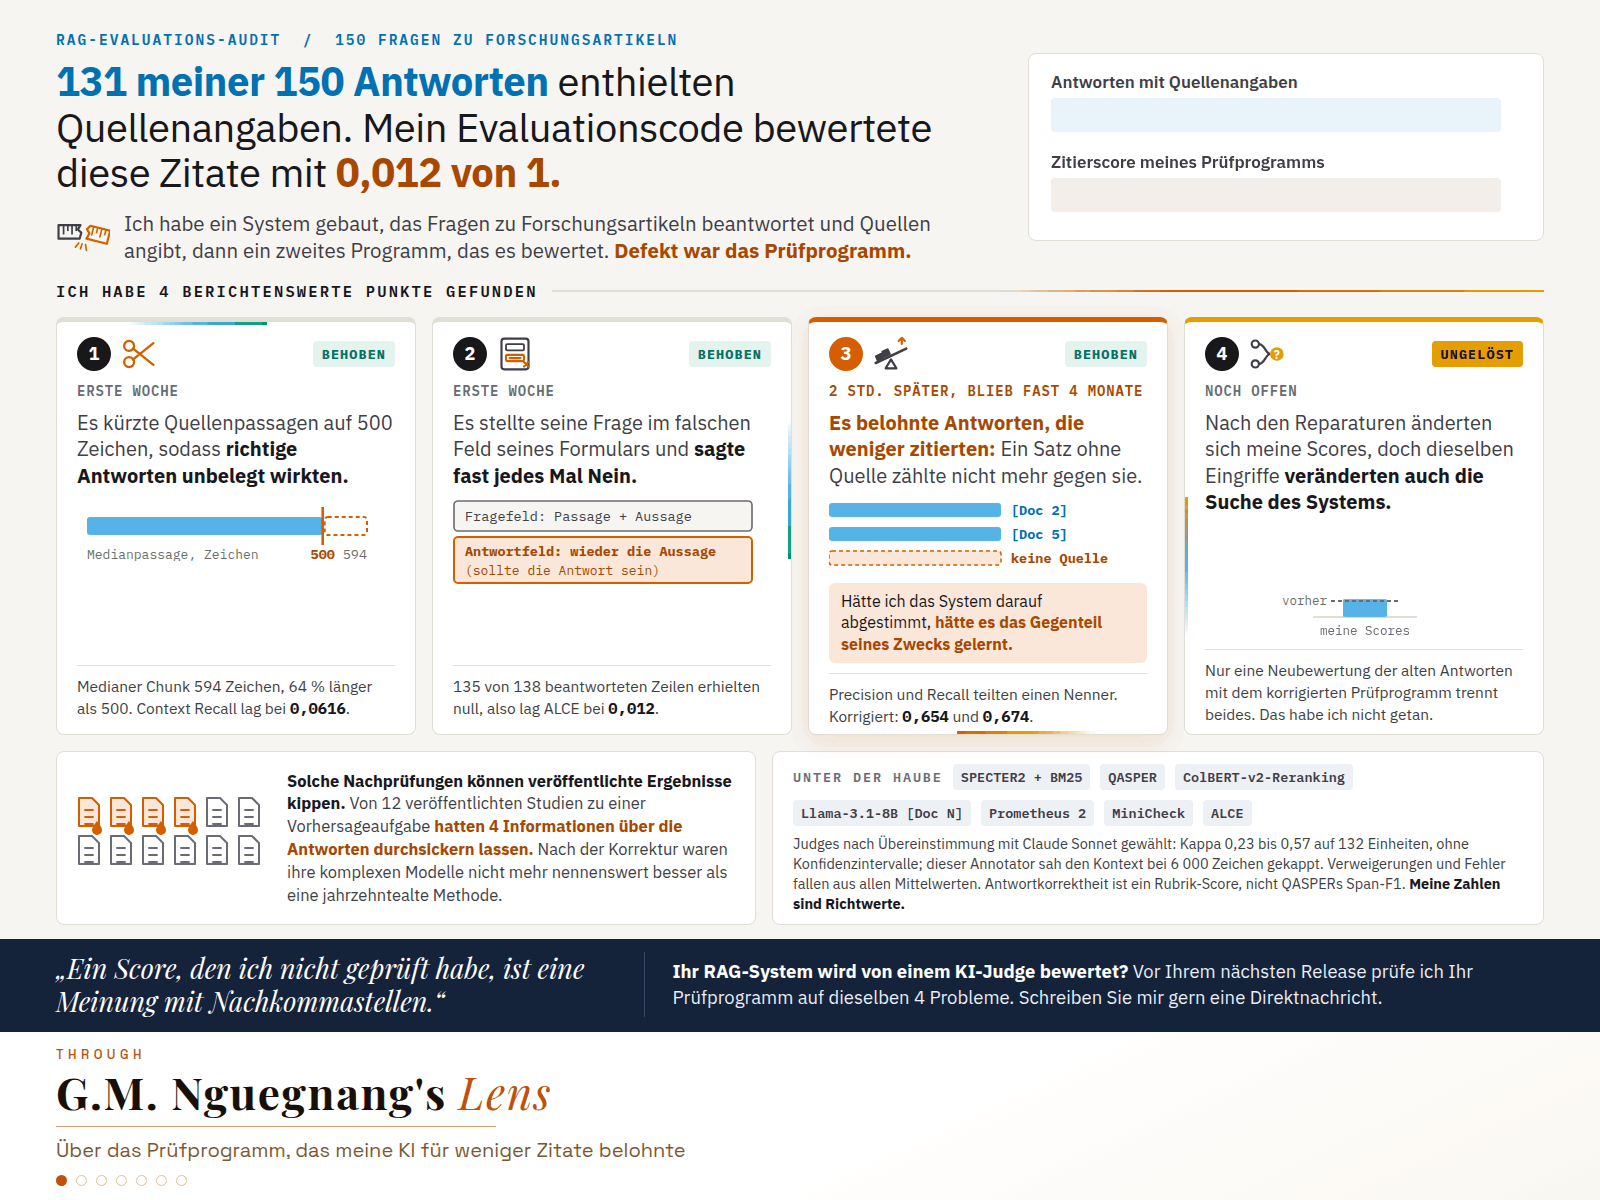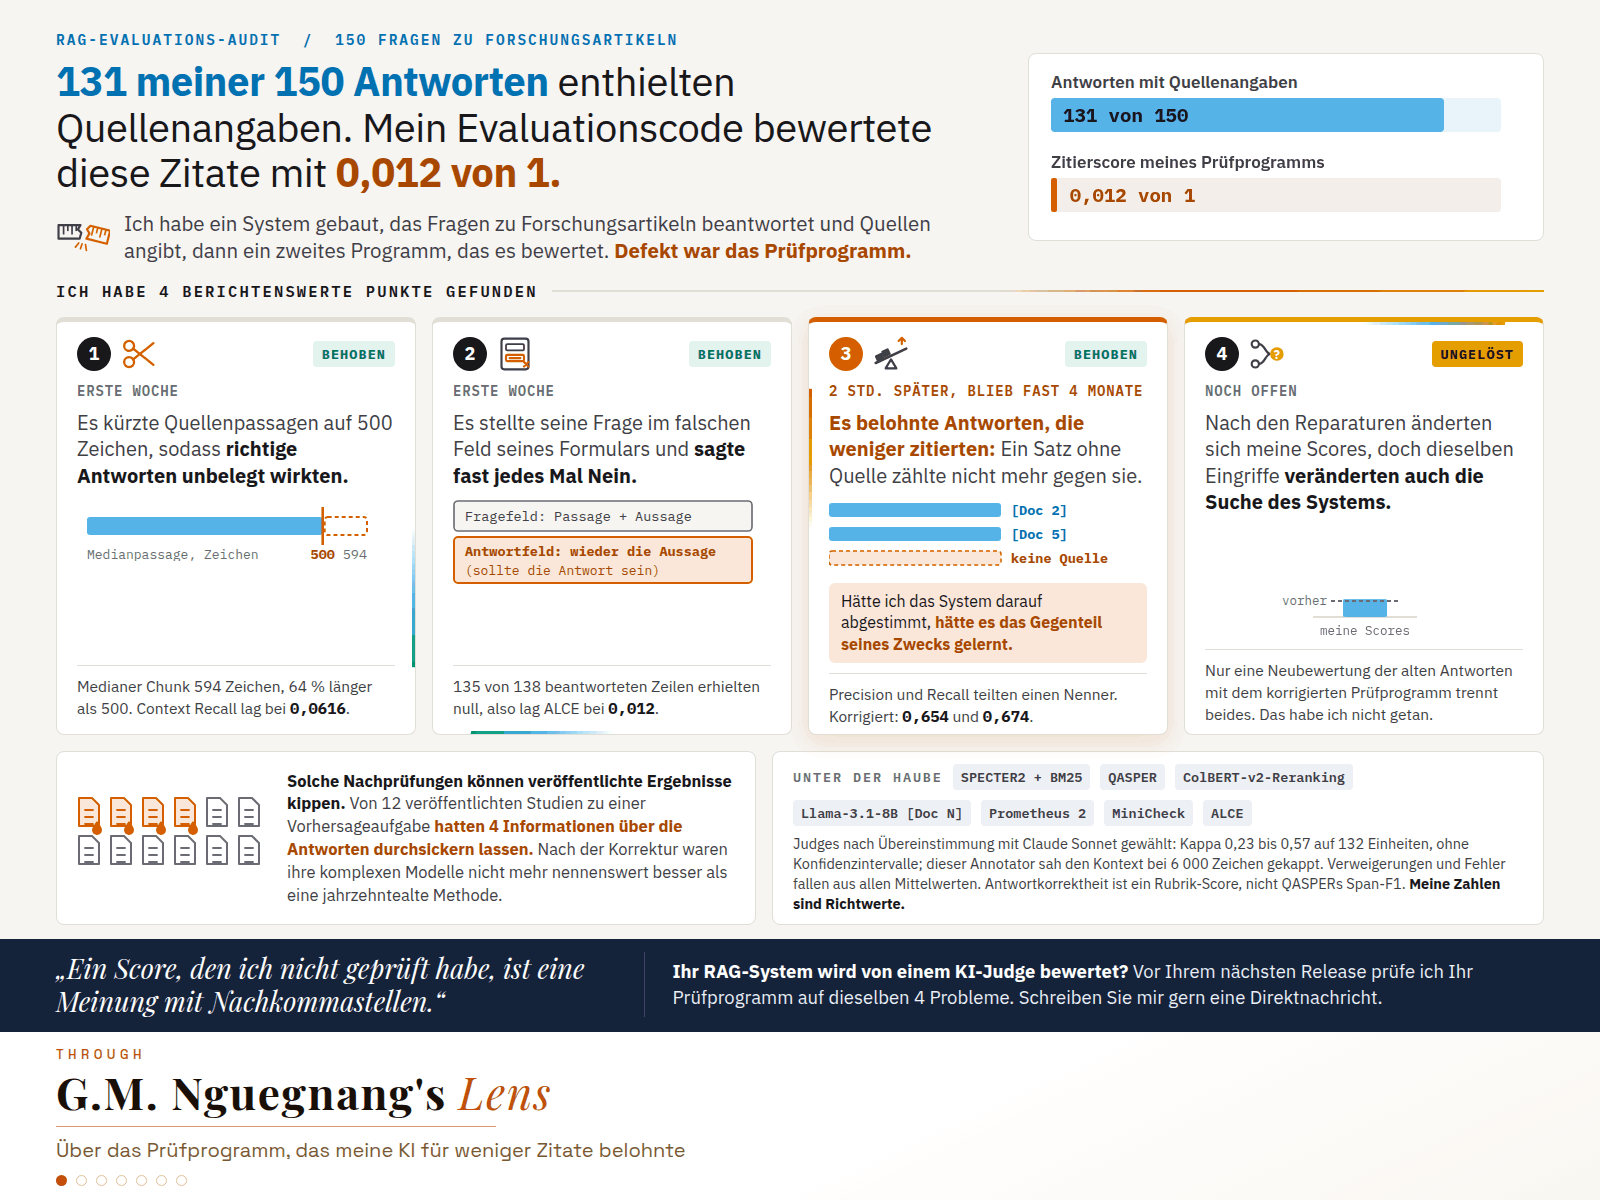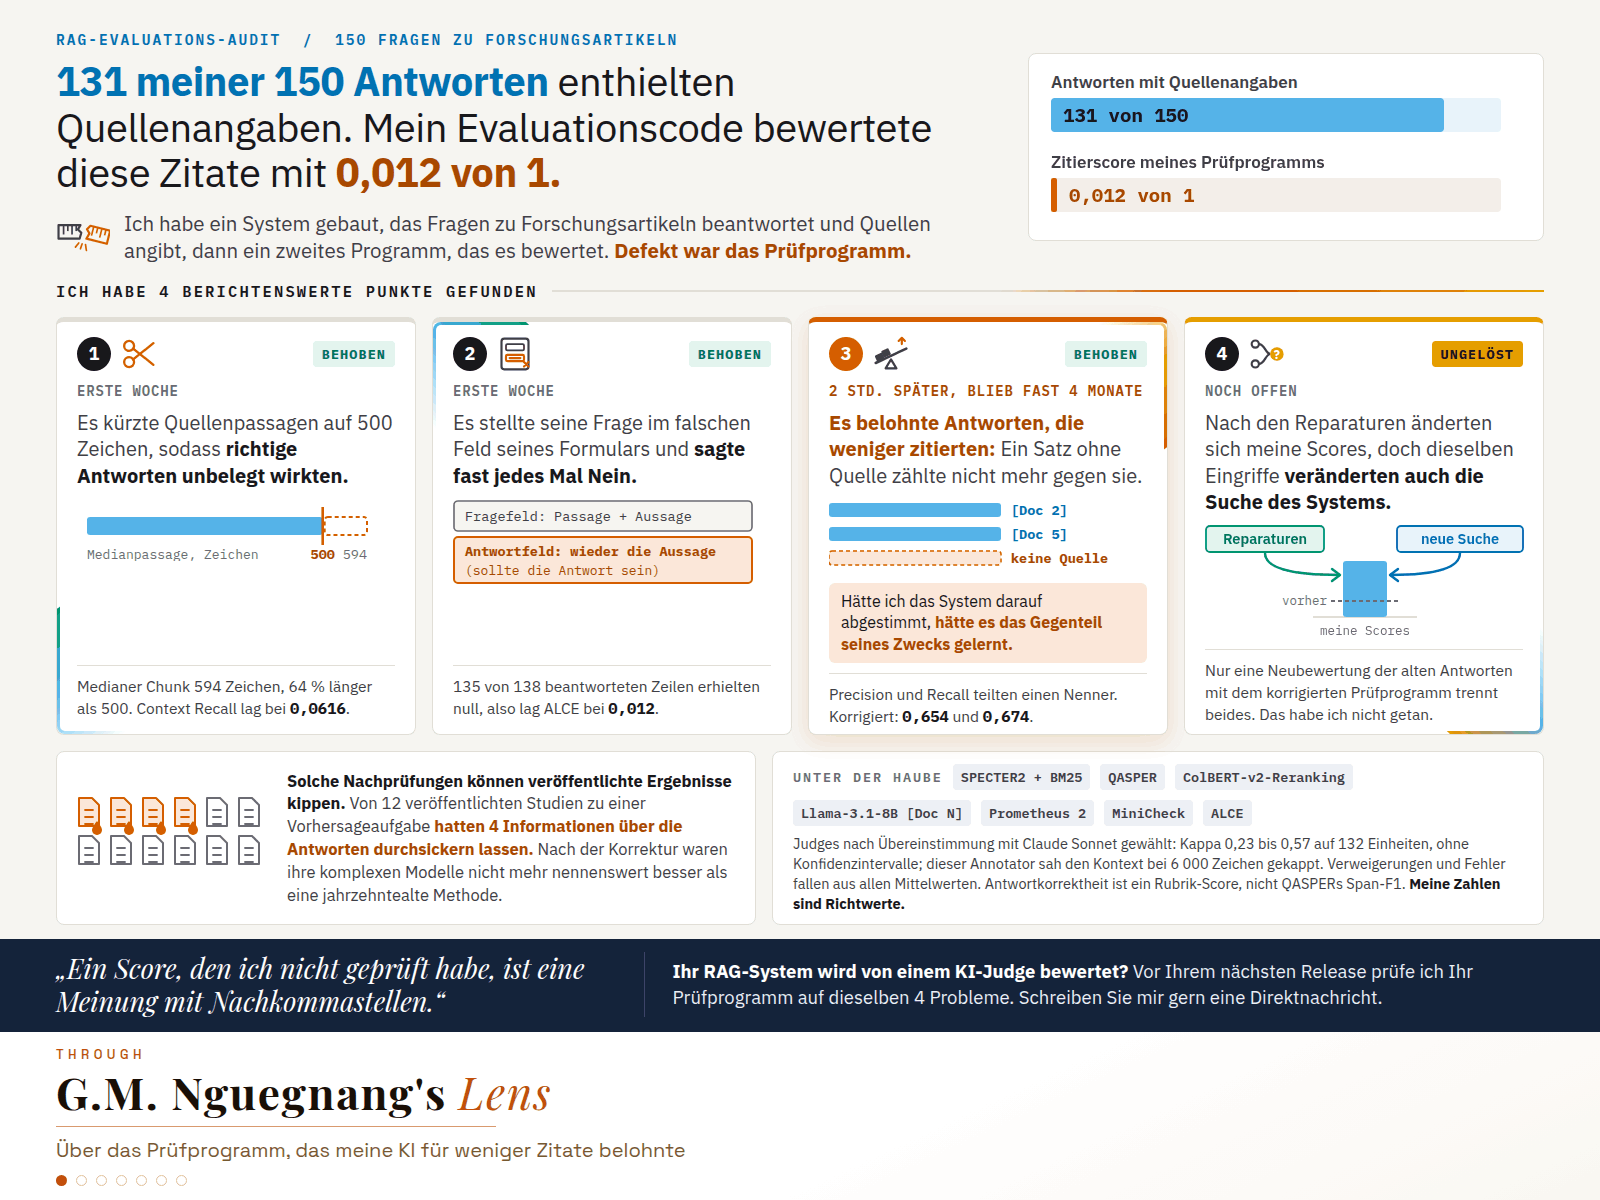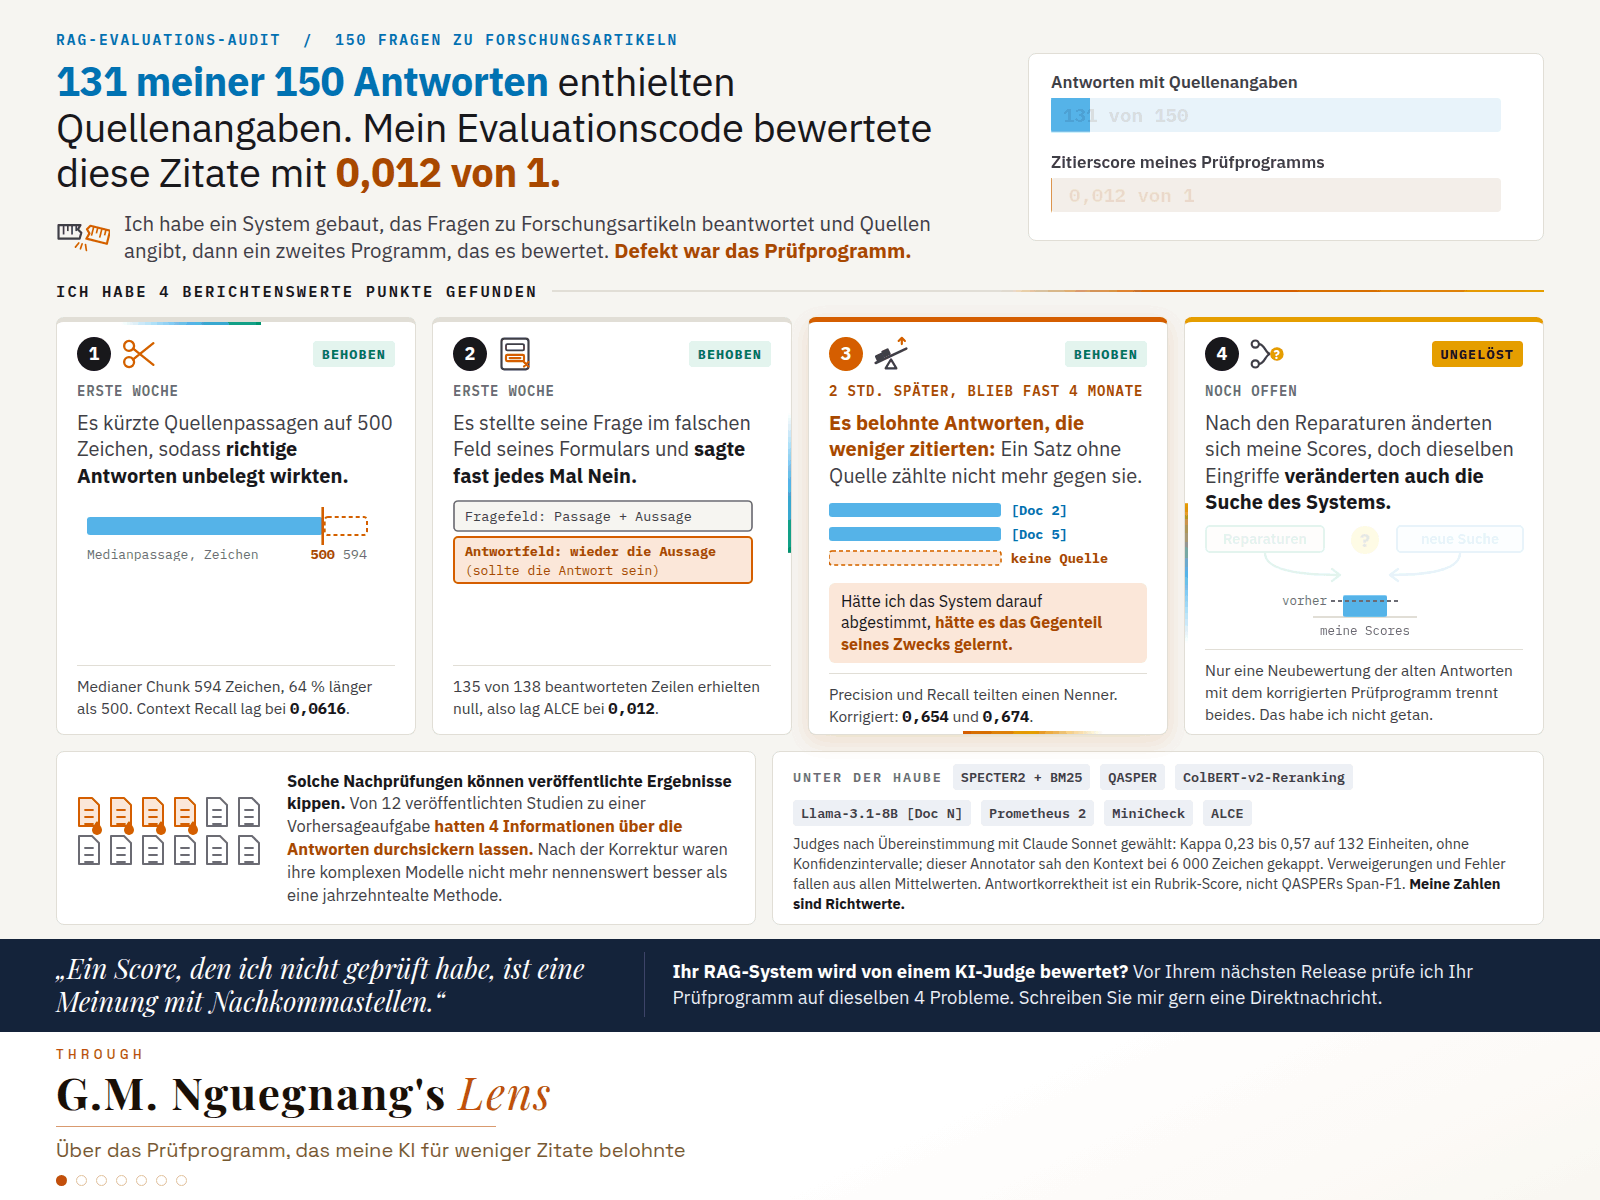
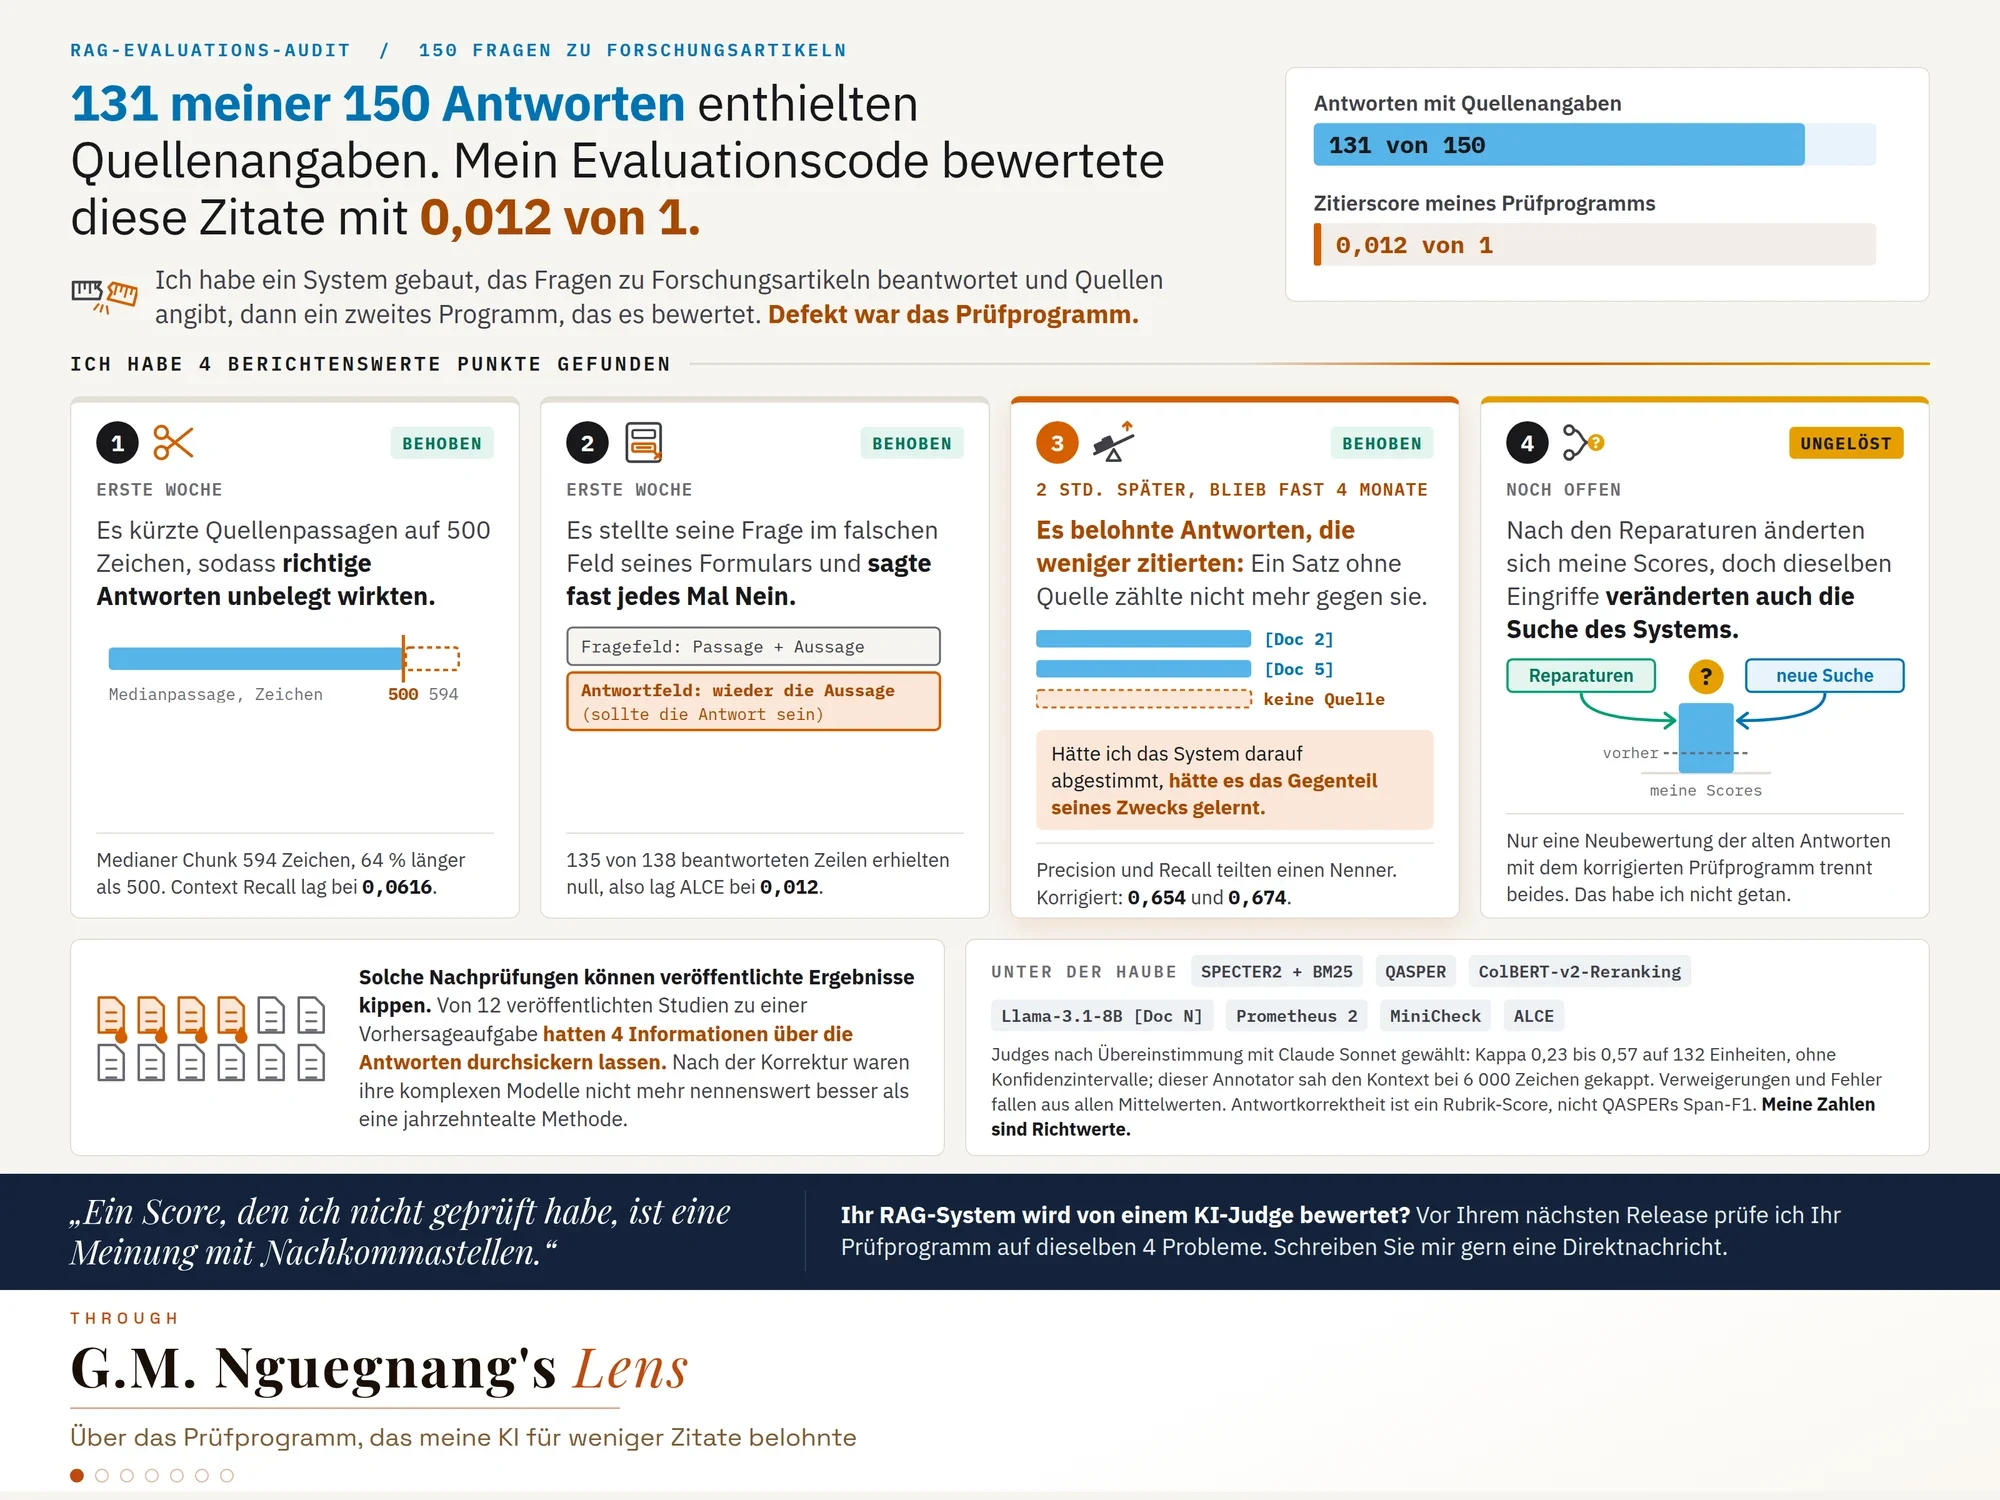
131 meiner 150 Antworten enthielten Quellenangaben. Mein Evaluationscode bewertete diese Zitate mit 0,012 von 1.
Ich habe ein System gebaut, das Fragen zu Forschungsartikeln beantwortet und seine Quellen angibt. Dann schrieb ich ein zweites Programm, das es bewertet.
Defekt war das Prüfprogramm.
Warum das zählt
Ich habe 4 berichtenswerte Punkte gefunden.
In seiner ersten Woche kürzte mein Prüfprogramm Quellenpassagen auf 500 Zeichen, sodass richtige Antworten unbelegt wirkten. Außerdem stellte es seine Frage im falschen Feld seines Formulars und sagte dann fast jedes Mal Nein.
Beides habe ich behoben. Zwei Stunden später baute ich den dritten Fehler ein, und er blieb fast vier Monate in meinem Prüfprogramm.
Es belohnte Antworten dafür, weniger zu zitieren: Ein Satz ohne Quelle zählte nicht mehr gegen sie. Hätte ich das System auf dieses Prüfprogramm abgestimmt, hätte ich ihm das Gegenteil dessen beigebracht, wofür ich es gebaut habe.
Den vierten Punkt kann ich nicht klären. Meine Scores verschoben sich nach den Reparaturen, doch dieselbe Änderungsrunde veränderte auch, wie das System sucht. Nur eine Neubewertung der Antworten von vor den Reparaturen mit dem korrigierten Prüfprogramm würde beides trennen, und die habe ich nicht gemacht.
Solche Nachprüfungen können veröffentlichte Ergebnisse kippen. Als Forschende 12 veröffentlichte Studien zu einer Vorhersageaufgabe nachprüften, hatten 4 Informationen über die Antworten in die Trainingsdaten der Modelle durchsickern lassen. Nach der Korrektur waren ihre komplexen Modelle nicht mehr nennenswert besser als eine jahrzehntealte Methode.
Ein Score, den ich nicht geprüft habe, ist eine Meinung mit Nachkommastellen.
Wie es funktioniert
SPECTER2 und BM25 über QASPER, Reranking mit ColBERT v2, Llama-3.1-8B zitiert als [Doc N]. Judges: Prometheus 2 und MiniCheck. Zitiermetrik: ALCE.
Fehler 1: eine Kürzung c[:500] vor der Bewertung von Context Recall und Faithfulness. Medianer Chunk 594 Zeichen, 64 % länger als 500. Context Recall lag bei 0,0616.
Fehler 2: Die Entailment-Prüfung setzte die Aussage in das Antwortfeld von Prometheus 2, das die zu bewertende Antwort erwartet. 135 von 138 beantworteten Zeilen erhielten null, also lag ALCE bei 0,012.
Fehler 3: Precision und Recall teilten sich einen Nenner, und ein Codekommentar schrieb das dem ALCE-Paper zu. ALCE mittelt den Recall über Aussagen, die Precision über Zitate. Bei mir waren beide auf allen 128 bewerteten Zeilen identisch; korrigiert liegen sie bei 0,654 und 0,674.
Nachdem ich RAGAS aufgegeben hatte, wählte ich den Judge jeder Metrik nach seiner Übereinstimmung mit einem zweiten KI-Judge, Claude Sonnet: Kappa 0,23 bis 0,57, also ausreichend bis moderat, auf 132 Einheiten, ohne Konfidenzintervalle. Dieser Annotator sah den Kontext bei 6 000 Zeichen gekappt, dieselbe Fehlerklasse wie Fehler 1. Seine Labels müssen mit vollem Kontext neu erstellt werden.
Verweigerungen und Fehler fallen aus jedem Mittelwert heraus, deshalb kann eine behobene Verweigerung einen Mittelwert senken. Die Antwortkorrektheit ist ein Rubrik-Score, nicht der F1-Wert von QASPER auf Span-Ebene, den ich noch nicht berechne. Lesen Sie meine Zahlen als Richtwerte.
Ihr RAG-System wird von einem KI-Judge bewertet? Vor Ihrem nächsten Release prüfe ich Ihr Prüfprogramm auf dieselben 4 Probleme. Schreiben Sie mir gern eine Direktnachricht.