1 von 3: KI-Datenbankabfragen, die fehlerfrei laufen und trotzdem falsch antworten
Ein begutachteter Test von 12 KI-Modellen: Die Abfragen des besten Modells liefen fast immer, doch etwa 1 von 3 lieferte trotzdem die falsche Antwort. Berechtigungen verhindern Schaden. Eine falsche Antwort erkennen sie nicht.
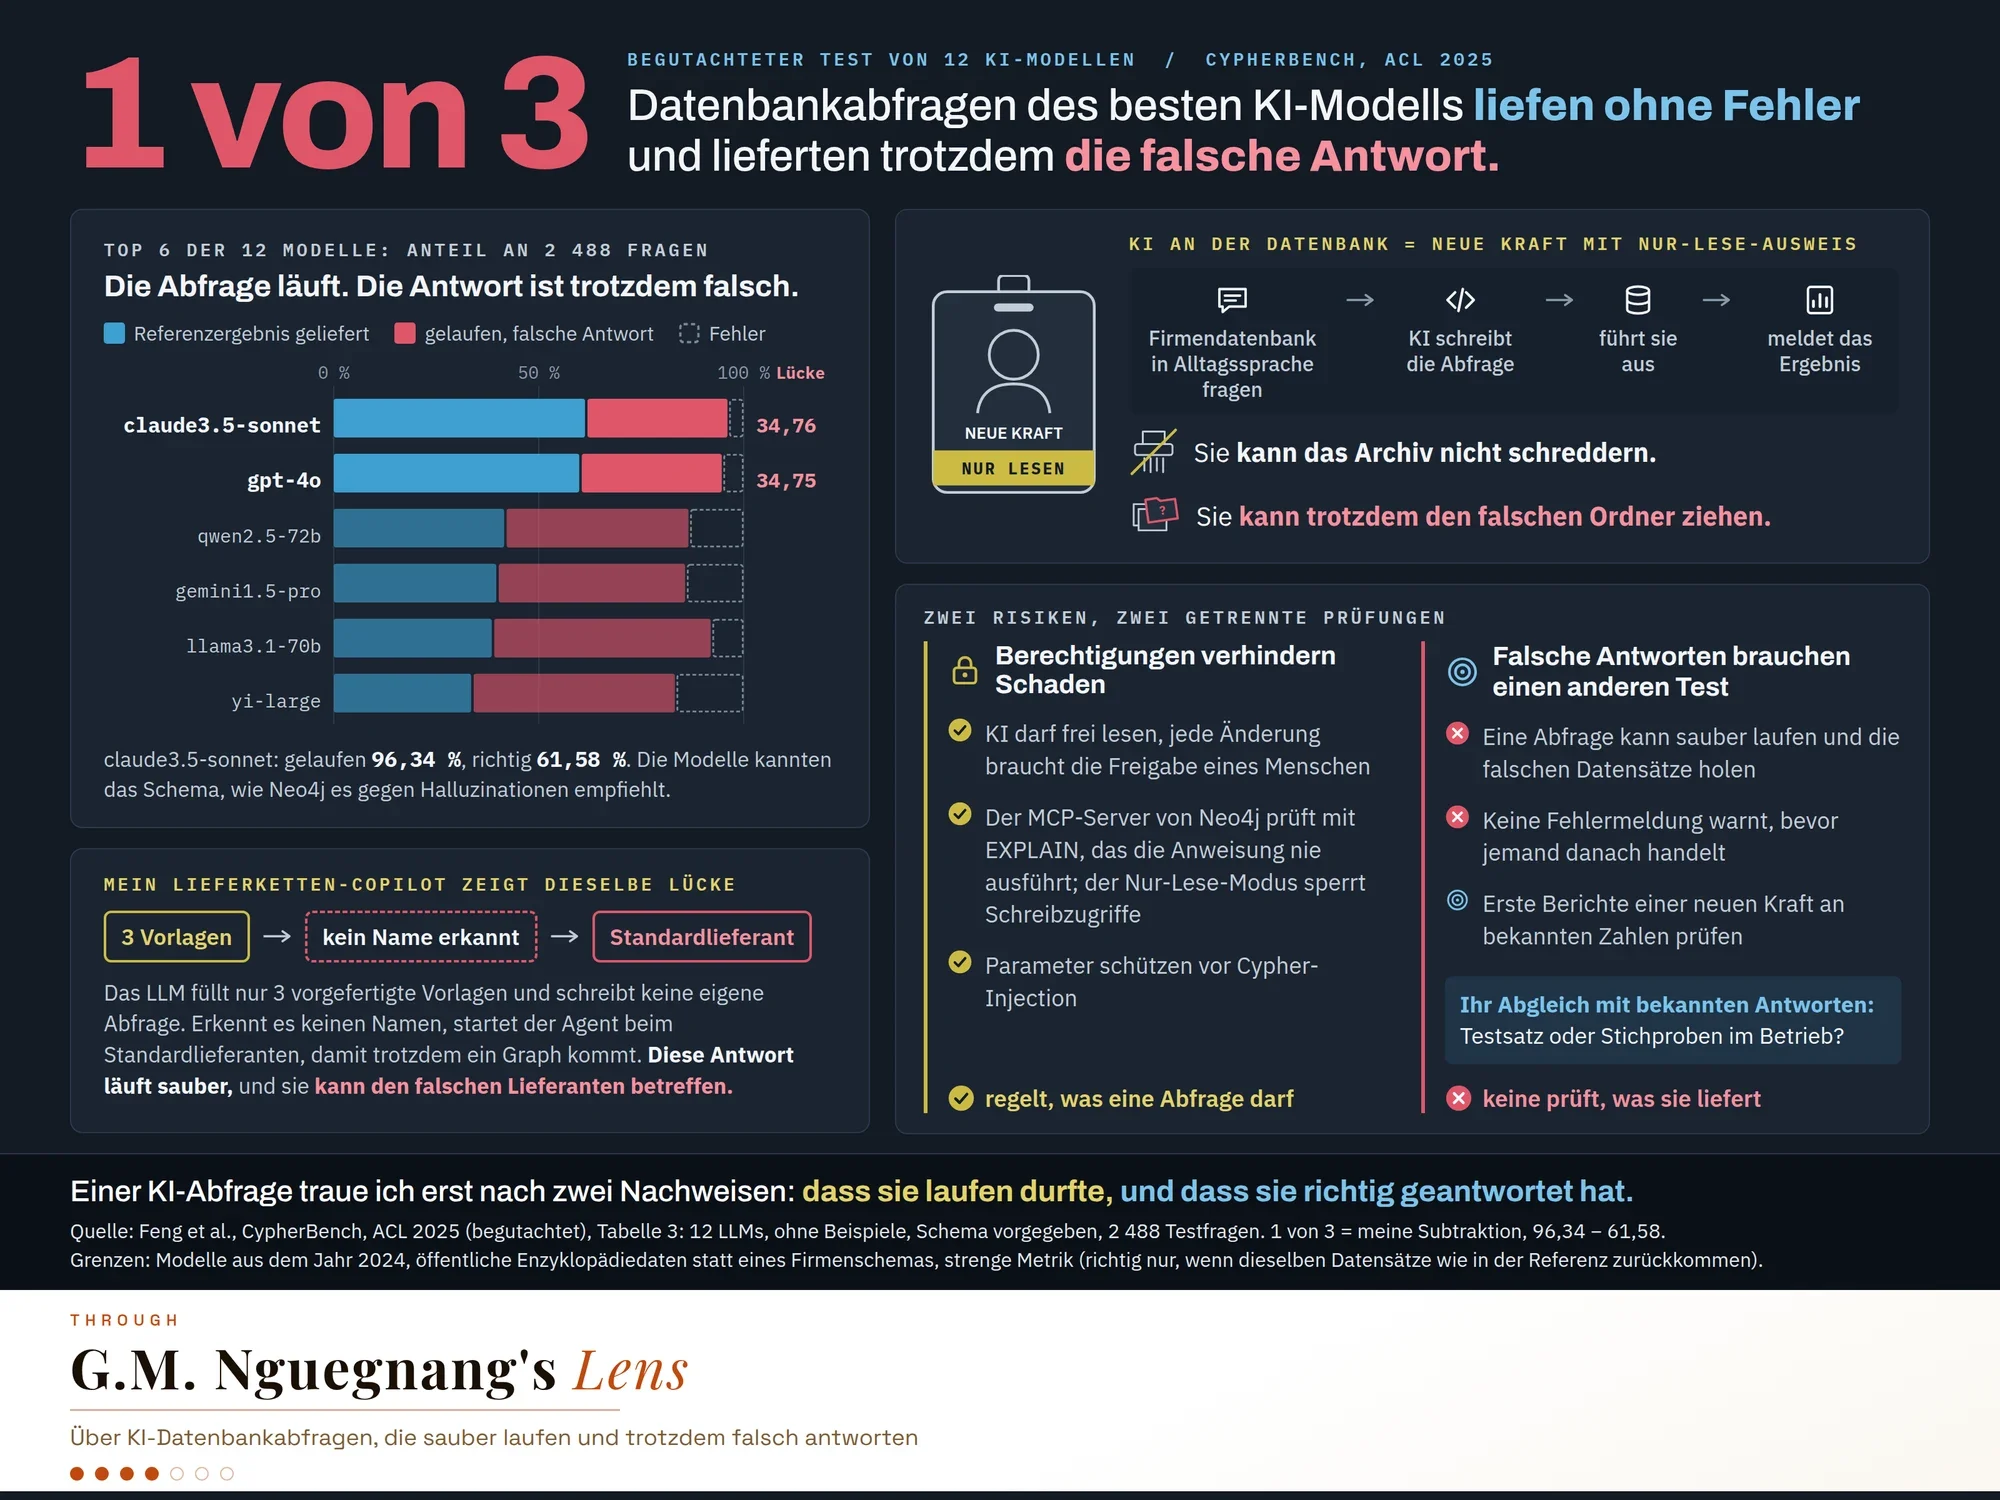
Etwa 1 von 3 Datenbankabfragen des besten KI-Modells lief ohne Fehler und lieferte trotzdem die falsche Antwort. Das zeigt ein begutachteter Test von 12 Modellen.
Warum das zählt
KI-Assistenten lassen Menschen inzwischen eine Firmendatenbank in Alltagssprache befragen. Die KI schreibt die Abfrage, führt sie aus und meldet das Ergebnis.
Die Sicherheitsempfehlungen des Datenbankherstellers sind solide. Die KI darf frei lesen, jede Änderung braucht die Freigabe eines Menschen. Man denke an eine neue Kraft mit Nur-Lese-Ausweis: Sie kann das Archiv nicht schreddern.
Den falschen Ordner ziehen kann sie trotzdem. Eine Abfrage kann sauber laufen und die falschen Datensätze holen, und keine Fehlermeldung warnt die fragende Person, bevor sie danach handelt.
Die beiden Risiken brauchen deshalb getrennte Prüfungen. Berechtigungen verhindern Schaden. Falsche Antworten brauchen einen anderen Test, so wie man die ersten Berichte einer neuen Kraft an Zahlen prüft, die man schon kennt.
Einer KI-Abfrage traue ich erst nach zwei Nachweisen: dass sie laufen durfte und dass sie richtig geantwortet hat.
Wie es funktioniert
CypherBench, ein auf der ACL 2025 veröffentlichter Benchmark, gab 12 LLMs ein Graphschema ohne gelöste Beispiele und ließ sie für 2 488 Testfragen Cypher schreiben, die Abfragesprache von Neo4j.
Das beste Modell, claude3.5-sonnet, schrieb Abfragen, die in 96,34 % der Fälle liefen. Nur 61,58 % lieferten das Referenzergebnis. Die Modelle kannten das Schema bereits, das Neo4j in seinen Empfehlungen gegen Halluzinationen vorsieht.
Die 1 von 3 ist meine eigene Subtraktion aus der Tabelle des Papers: 96,34 minus 61,58. Die Lücke von GPT-4o beträgt 34,76 Punkte.
Grenzen: Modelle aus dem Jahr 2024, öffentliche Enzyklopädiedaten statt eines Firmenschemas und eine strenge Metrik, die ein Ergebnis nur dann als richtig zählt, wenn es dieselben Datensätze wie die Referenz liefert.
Der MCP-Server von Neo4j, die Brücke zwischen KI-Assistenten und Neo4j, ordnet Abfragen mit EXPLAIN ein, das die Anweisung nie ausführt, und sperrt im Nur-Lese-Modus alle Schreibzugriffe.
Parameter schützen vor Cypher-Injection, wenn Werte in vorgefertigte Abfragen eingesetzt werden. Jede dieser Prüfungen regelt, was eine Abfrage darf. Keine prüft, was sie liefert.
Mein Lieferketten-Copilot zeigt dieselbe Lücke. Das LLM liefert nur Werte für 3 vorgefertigte Vorlagen und kann deshalb keine eigene Abfrage schreiben. Erkennt es in der Frage aber keinen Namen, startet der Agent bei einem Standardlieferanten, damit trotzdem ein Graph zurückkommt. Diese Antwort läuft sauber, und sie kann den falschen Lieferanten betreffen.
Wenn eine KI für Ihr Team Datenbankabfragen schreibt: Wie gleichen Sie mit bekannten Antworten ab, mit einem festen Testsatz oder mit Stichproben bei echten Antworten?