Die teurere KI-Suche verlor bei einfachen Faktenfragen
Eine begutachtete Studie auf der KDD 2026 schickte klassische Suche und Graphsuche durch dieselben Tests. Wer gewann, hing von der Frage ab, und der KI-Richter, der das Duell bewertete, drehte sein Urteil mitunter, sobald die Antworten die Plätze tauschten.
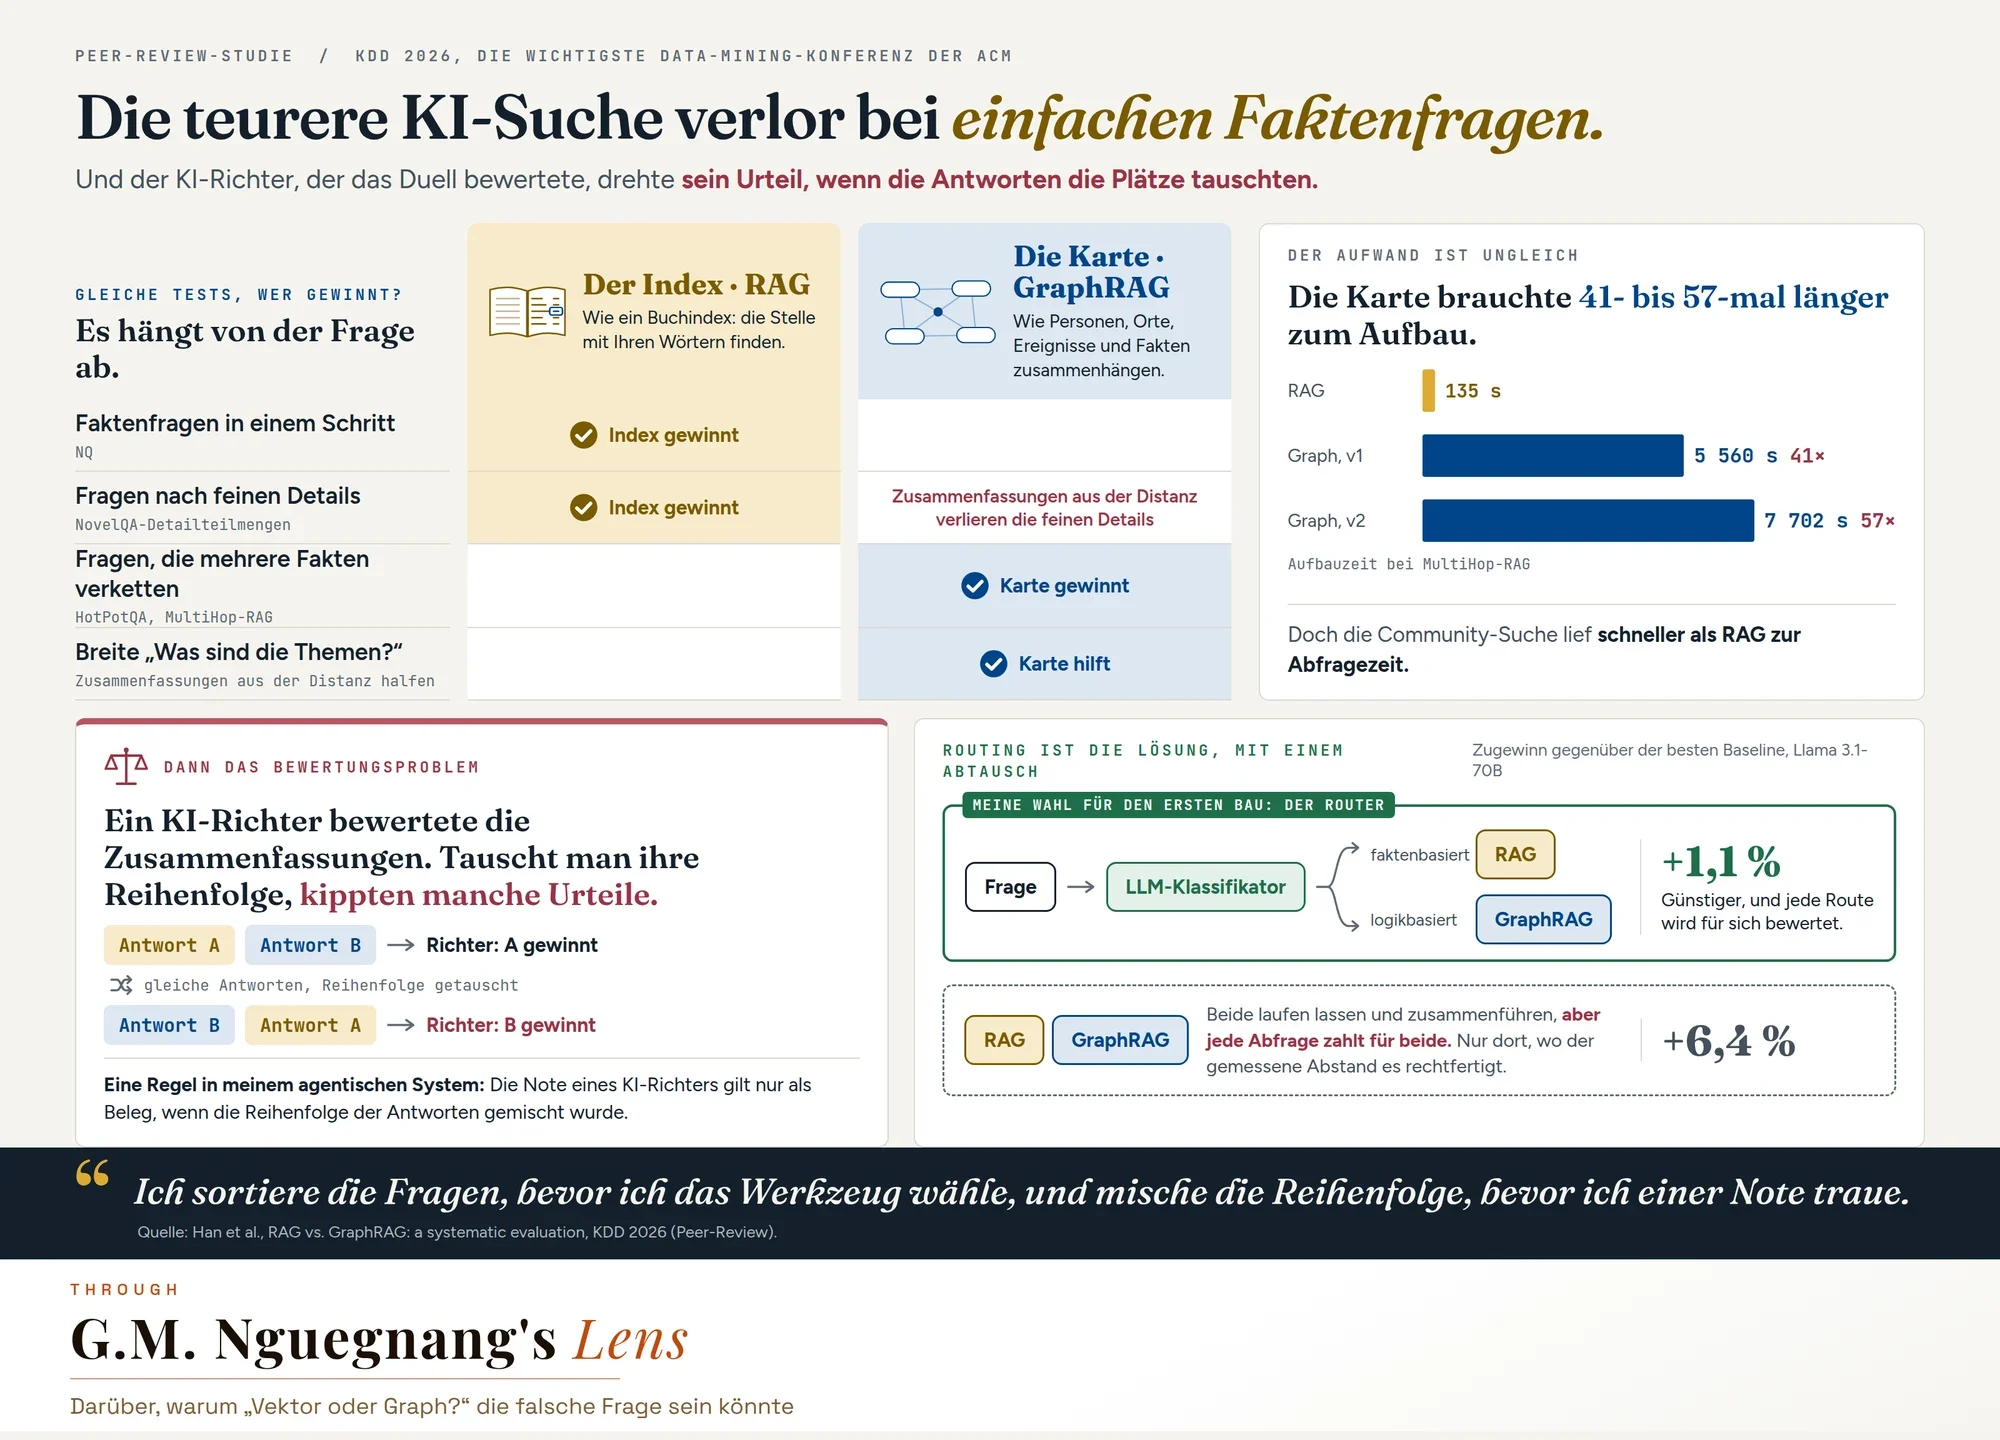
Die teurere KI-Suche verlor bei einfachen Faktenfragen. Und der KI-Richter, der das Duell bewertete, drehte sein Urteil mitunter, sobald die Antworten die Plätze tauschten.
Warum das zählt
Klassische KI-Suche arbeitet wie ein Buchindex: die Stelle finden, an der Ihre Wörter stehen. Graphsuche arbeitet wie eine Karte davon, wie Personen, Orte, Ereignisse und Fakten zusammenhängen.
Eine begutachtete Studie auf der KDD 2026, der wichtigsten Data-Mining-Konferenz der ACM, schickte beide durch dieselben Tests. Die Karte gewann bei Fragen, die mehrere Fakten verketten. Der Index gewann bei Fragen in einem Schritt und bei feinen Details. In einem Test brauchten die Karten-Varianten 41- bis 57-mal länger zum Aufbau.
Die Zusammenfassungen der Karte aus der Distanz halfen bei breiten Fragen der Art „Was sind die Themen?“. Sie ließen zugleich die feinen Details fallen, die enge Fragen brauchen.
Dann das Bewertungsproblem. Ein KI-Richter benotete die Zusammenfassungen. Tauscht man ihre Reihenfolge, kippen manche Urteile.
Diese Regel stand bereits in meinem agentischen System: Die Note eines KI-Richters gilt nur als Beleg, wenn die Reihenfolge der Antworten gemischt wurde. Die Studie zeigt, was ohne sie geschieht.
Ich sortiere die Fragen, bevor ich das Werkzeug wähle, und mische die Reihenfolge, bevor ich einer Note traue.
Wie es funktioniert
Han und Mitautoren verglichen RAG und GraphRAG unter einem Protokoll. RAG führte bei Fragen in einem Schritt und bei detailorientierten Aufgaben (NQ sowie die Detailteilmengen von NovelQA). Die GraphRAG-Verfahren führten bei Fragen über mehrere Schritte (HotPotQA, MultiHop-RAG).
Die globale Suche über Communities, das GraphRAG-Design von Microsoft, kann feine Belege verlieren. Bei den Detailfragen von NovelQA wurde das sichtbar: Dieselbe Zusammenfassung, die ein Thema erkennbar macht, lässt die gefragte Zahl fallen.
Der Aufwand ist ungleich verteilt. Bei MultiHop-RAG brauchten die beiden Graph-Varianten 5 560 s und 7 702 s zum Aufbau, gegenüber 135 s für RAG. Doch die Community-Suche lief zur Abfragezeit schneller als RAG. Der Aufwand steckt im Aufbau, nicht in der Abfrage: ein anderes Budget und eine andere Entscheidung.
Routing ist die Lösung, mit einem Abtausch. Ein LLM-Klassifikator etikettierte jede Anfrage als faktenbasiert oder schlussfolgernd und schickte sie dann an RAG oder GraphRAG: 1,1 % über der besten Baseline, Llama 3.1-70B. Beides laufen zu lassen und zusammenzuführen brachte 6,4 % mehr, doch dann zahlt jede Anfrage für beides.
Meine Wahl für einen ersten Bau ist der Router. Er ist günstiger, und jede Route wird für sich bewertet, sodass eine Verschlechterung nur eine Quelle haben kann. Für beides würde ich nur dort zahlen, wo der gemessene Abstand es rechtfertigt, und ich würde die Reihenfolge der Antworten mischen, bevor ein LLM-Richter sie sieht.
Was die Studie nicht klärt, ist Ihr Korpus. Das sind öffentliche Benchmarks, deren Entitäten aus dem Datensatz stammen. In einem Korpus, dessen Entitäten Ihre eigenen sind, Lieferanten, Schäden, Teile, hat die Karte weit mehr zu verbinden, als NQ ihr je gibt, und die Aufbaukosten fallen einmal an, gegen ein Schema, das sich langsam ändert.