131 de mes 150 réponses citaient leurs sources. Mon évaluateur a noté ces citations 0,012 sur 1
J'ai construit un système qui répond à des questions sur des articles de recherche en citant ses sources, puis un second programme pour l'évaluer. C'est l'évaluateur qui était fautif : j'y ai trouvé 4 problèmes, j'en ai corrigé 3, et le dernier reste ouvert.
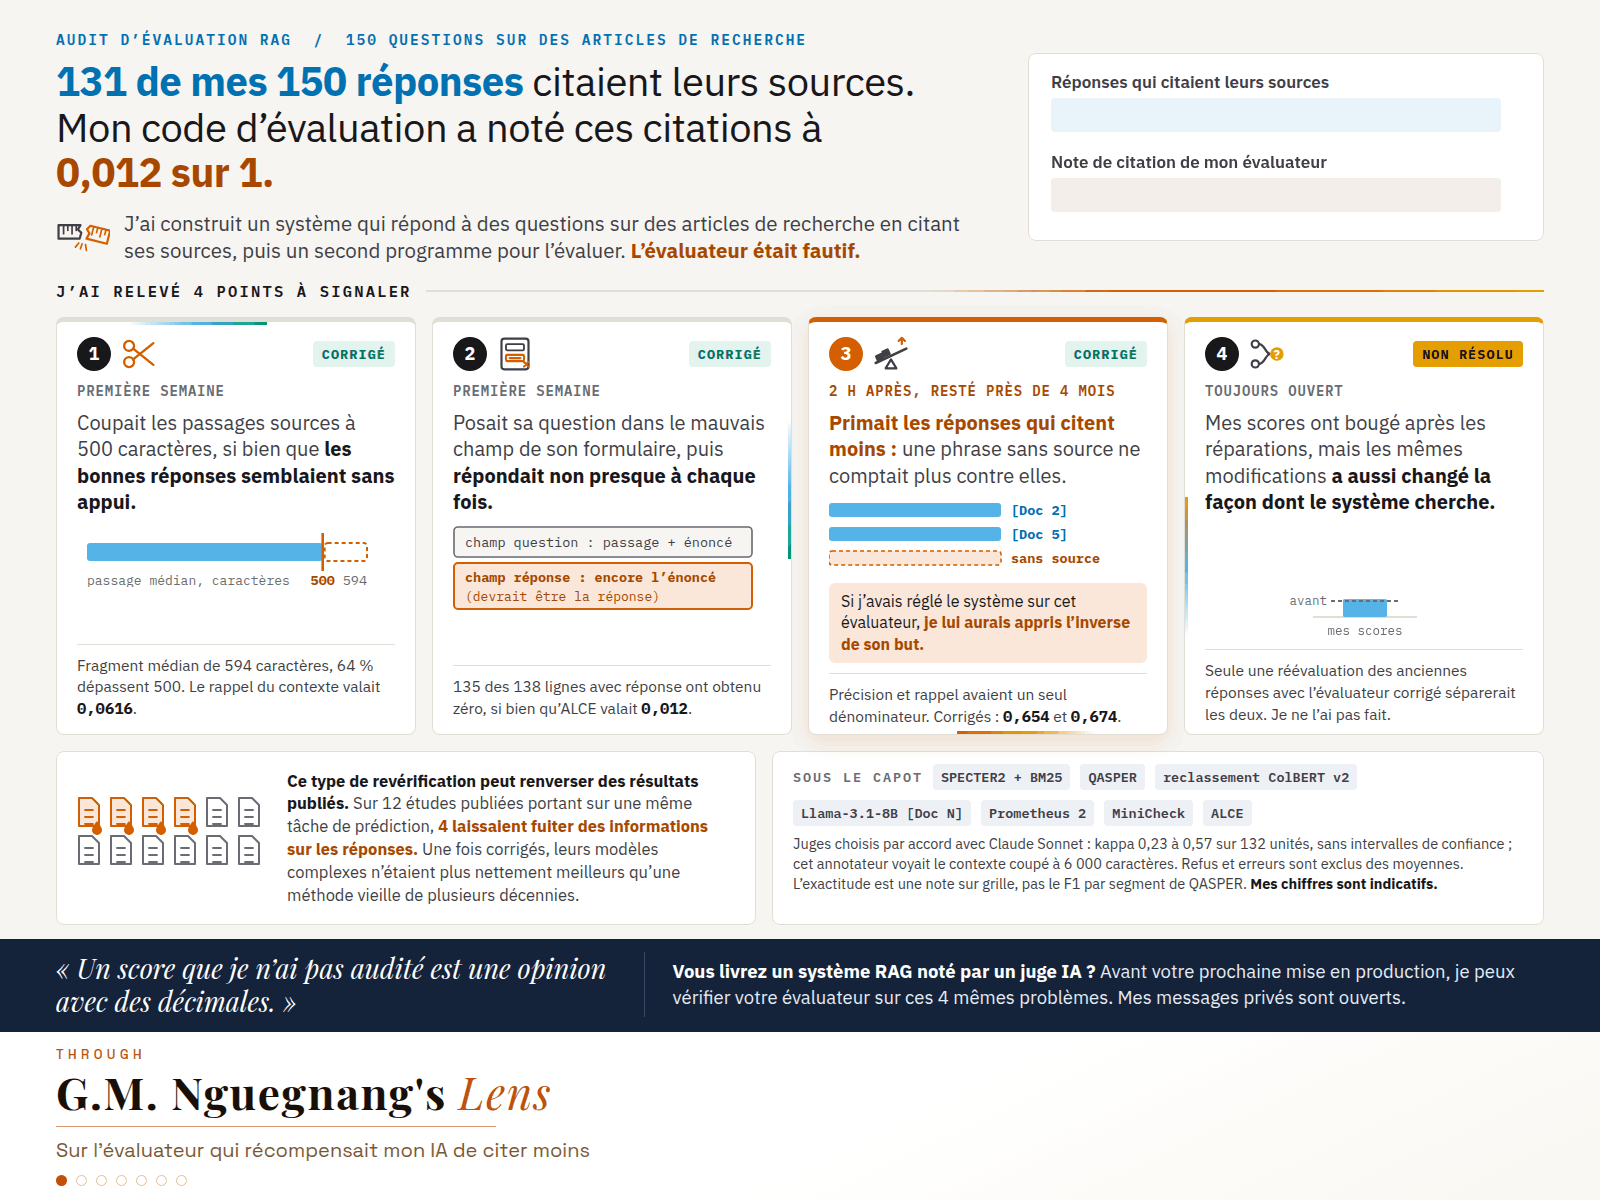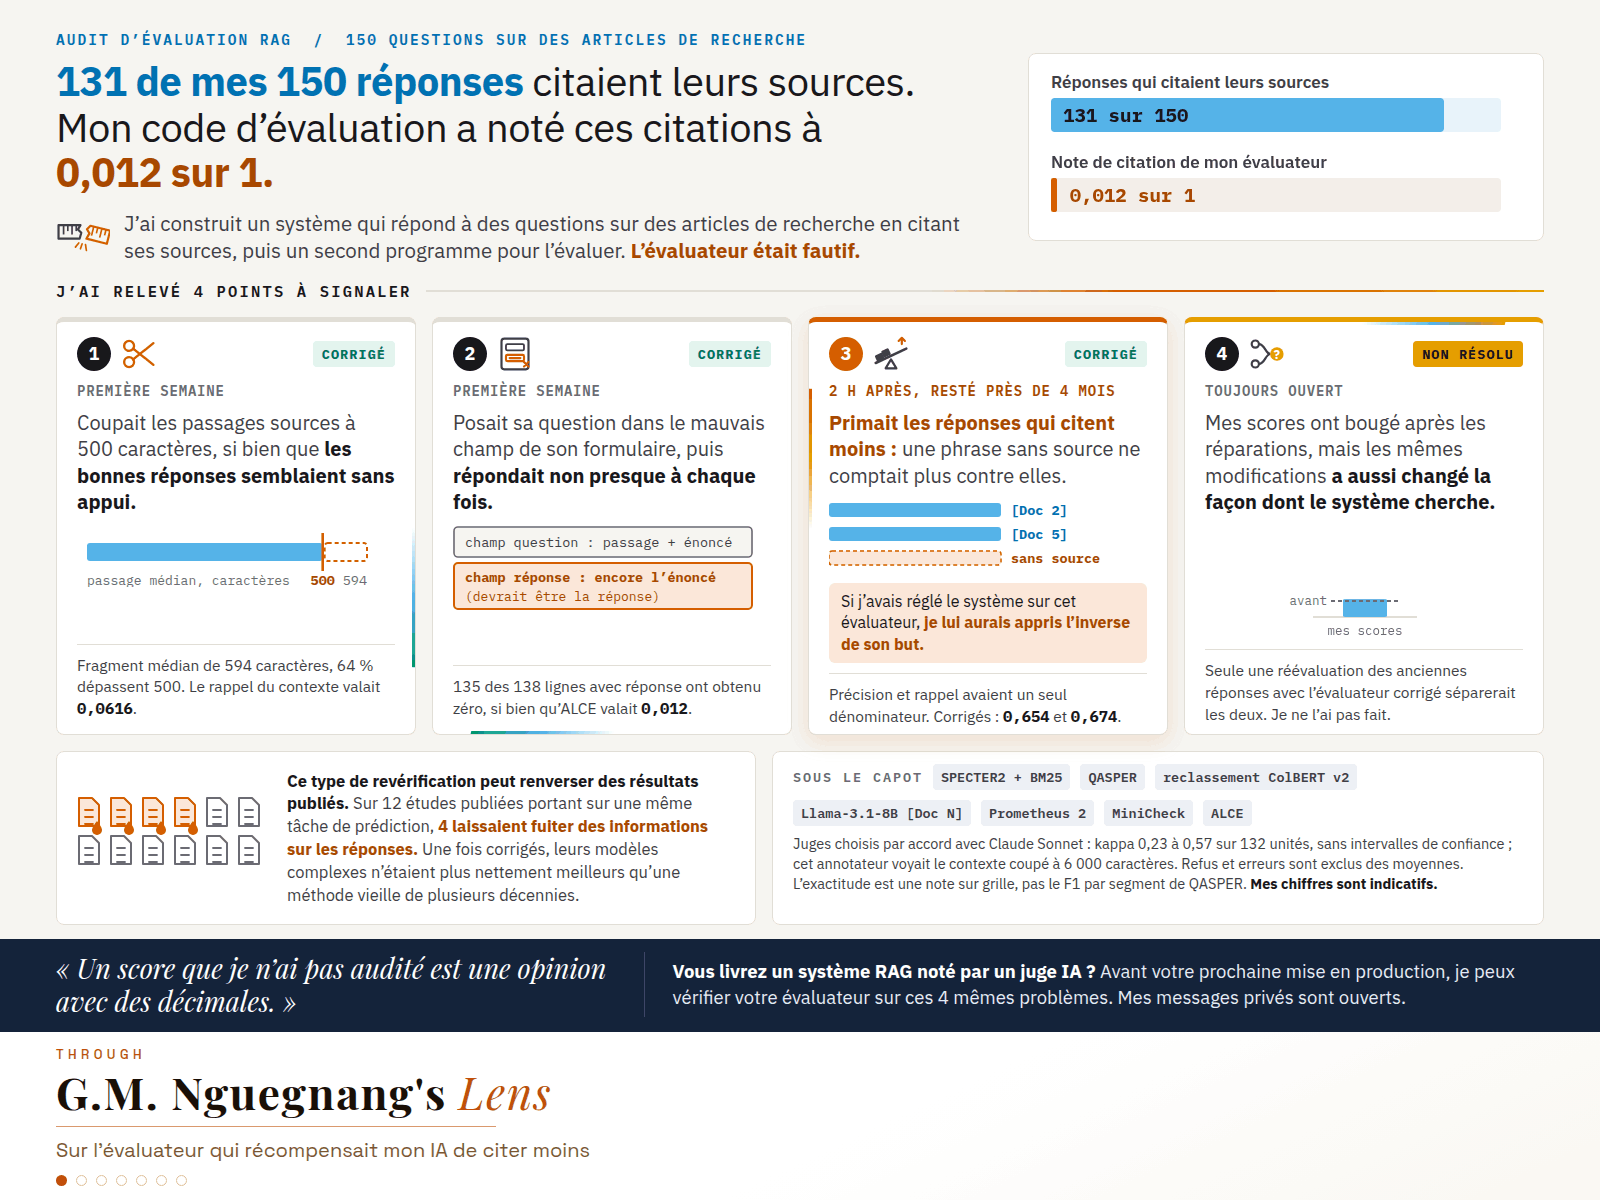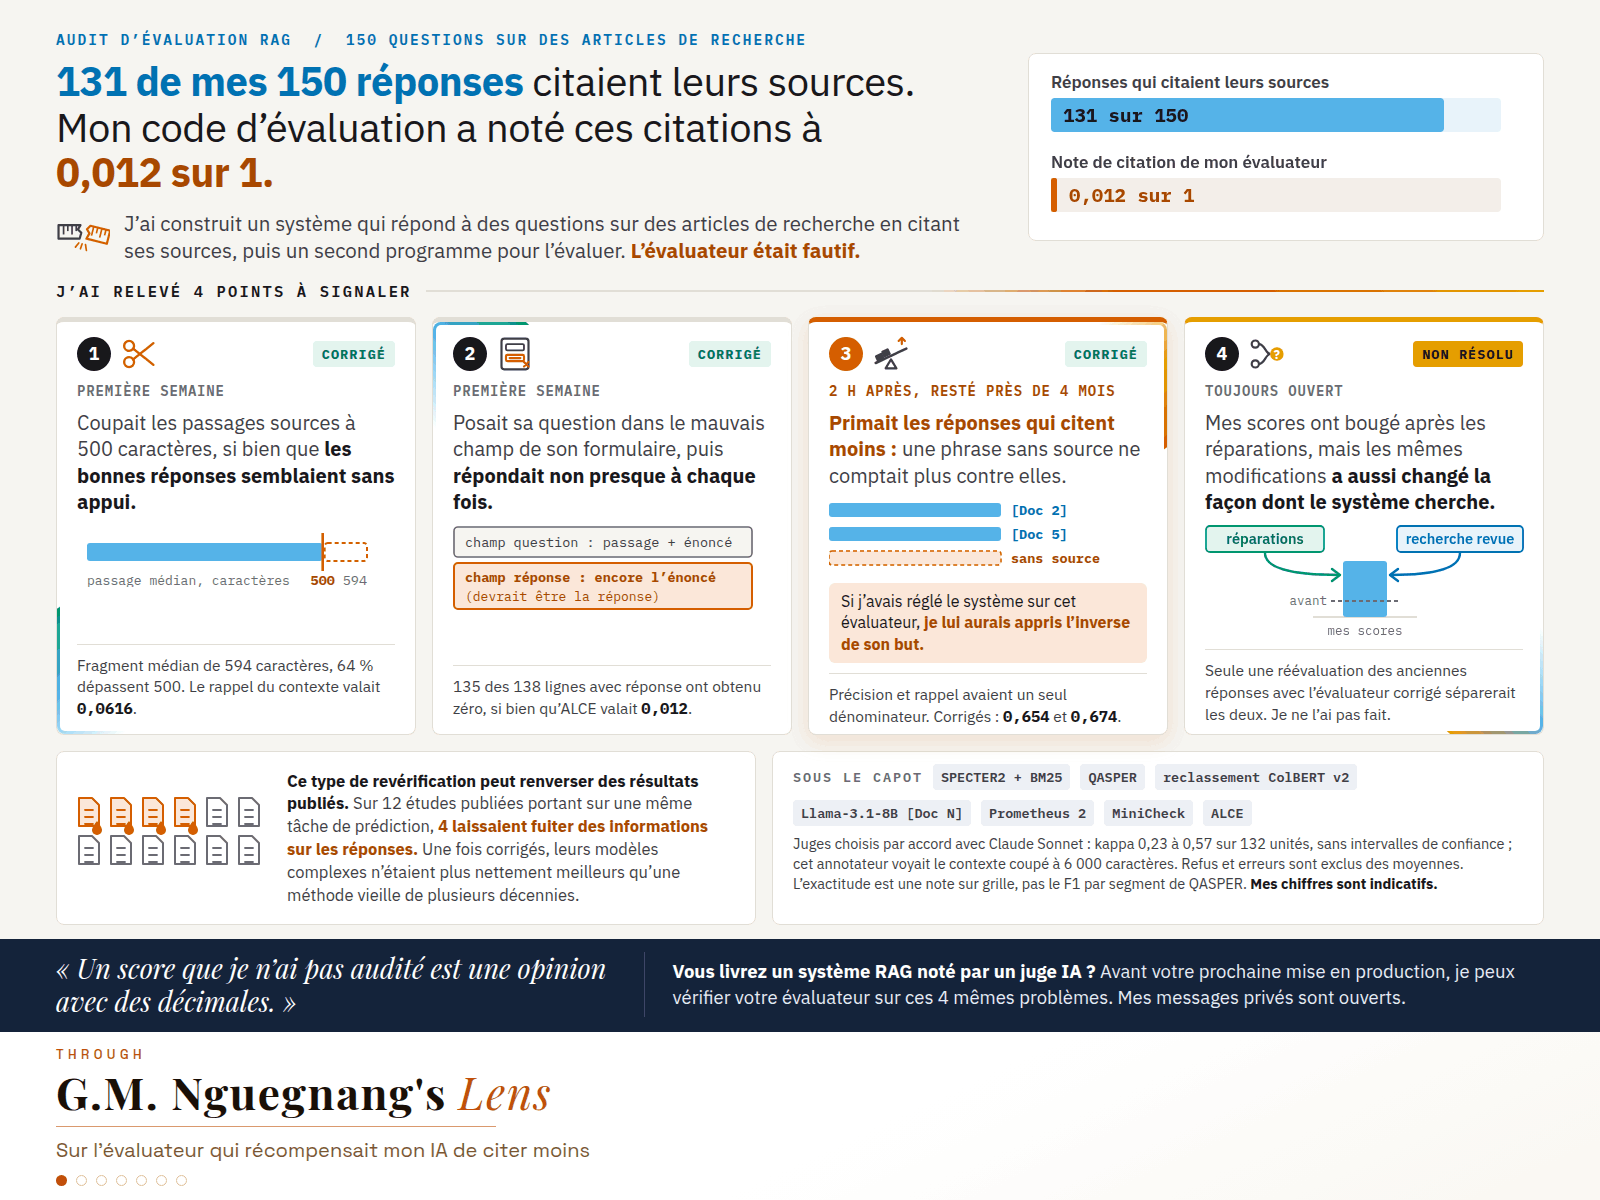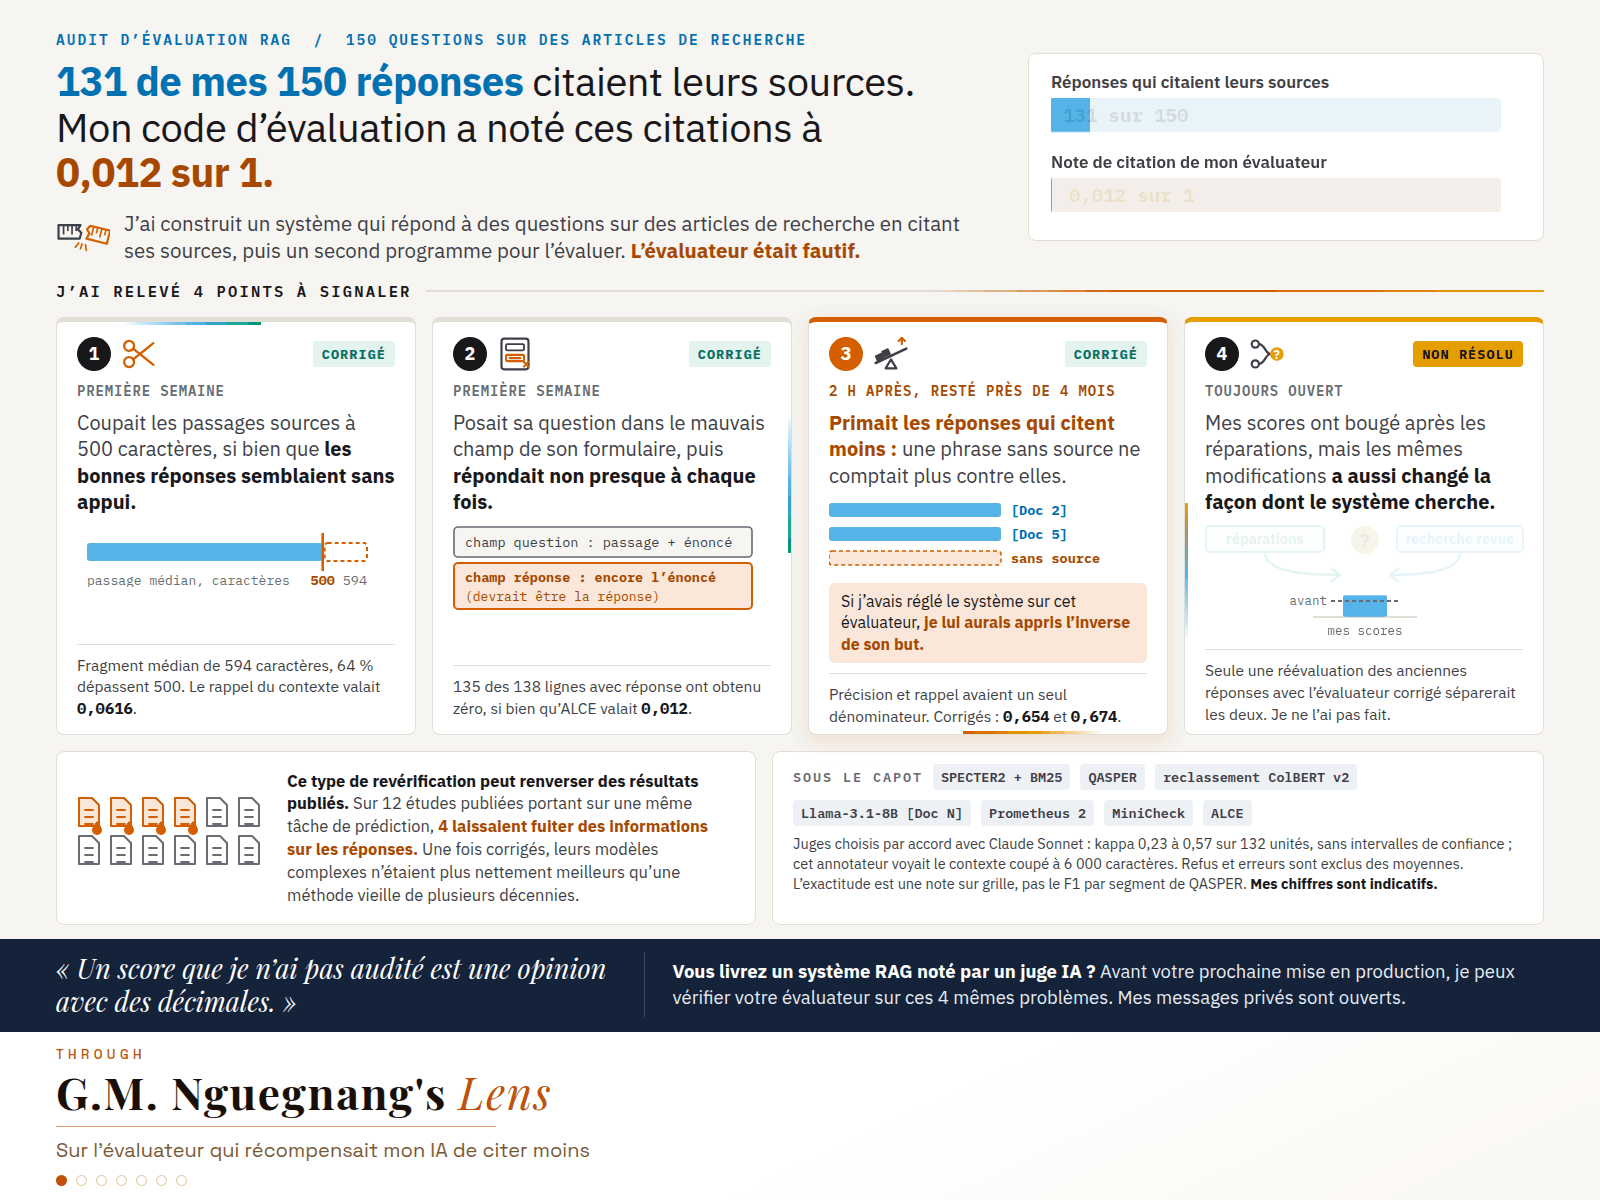
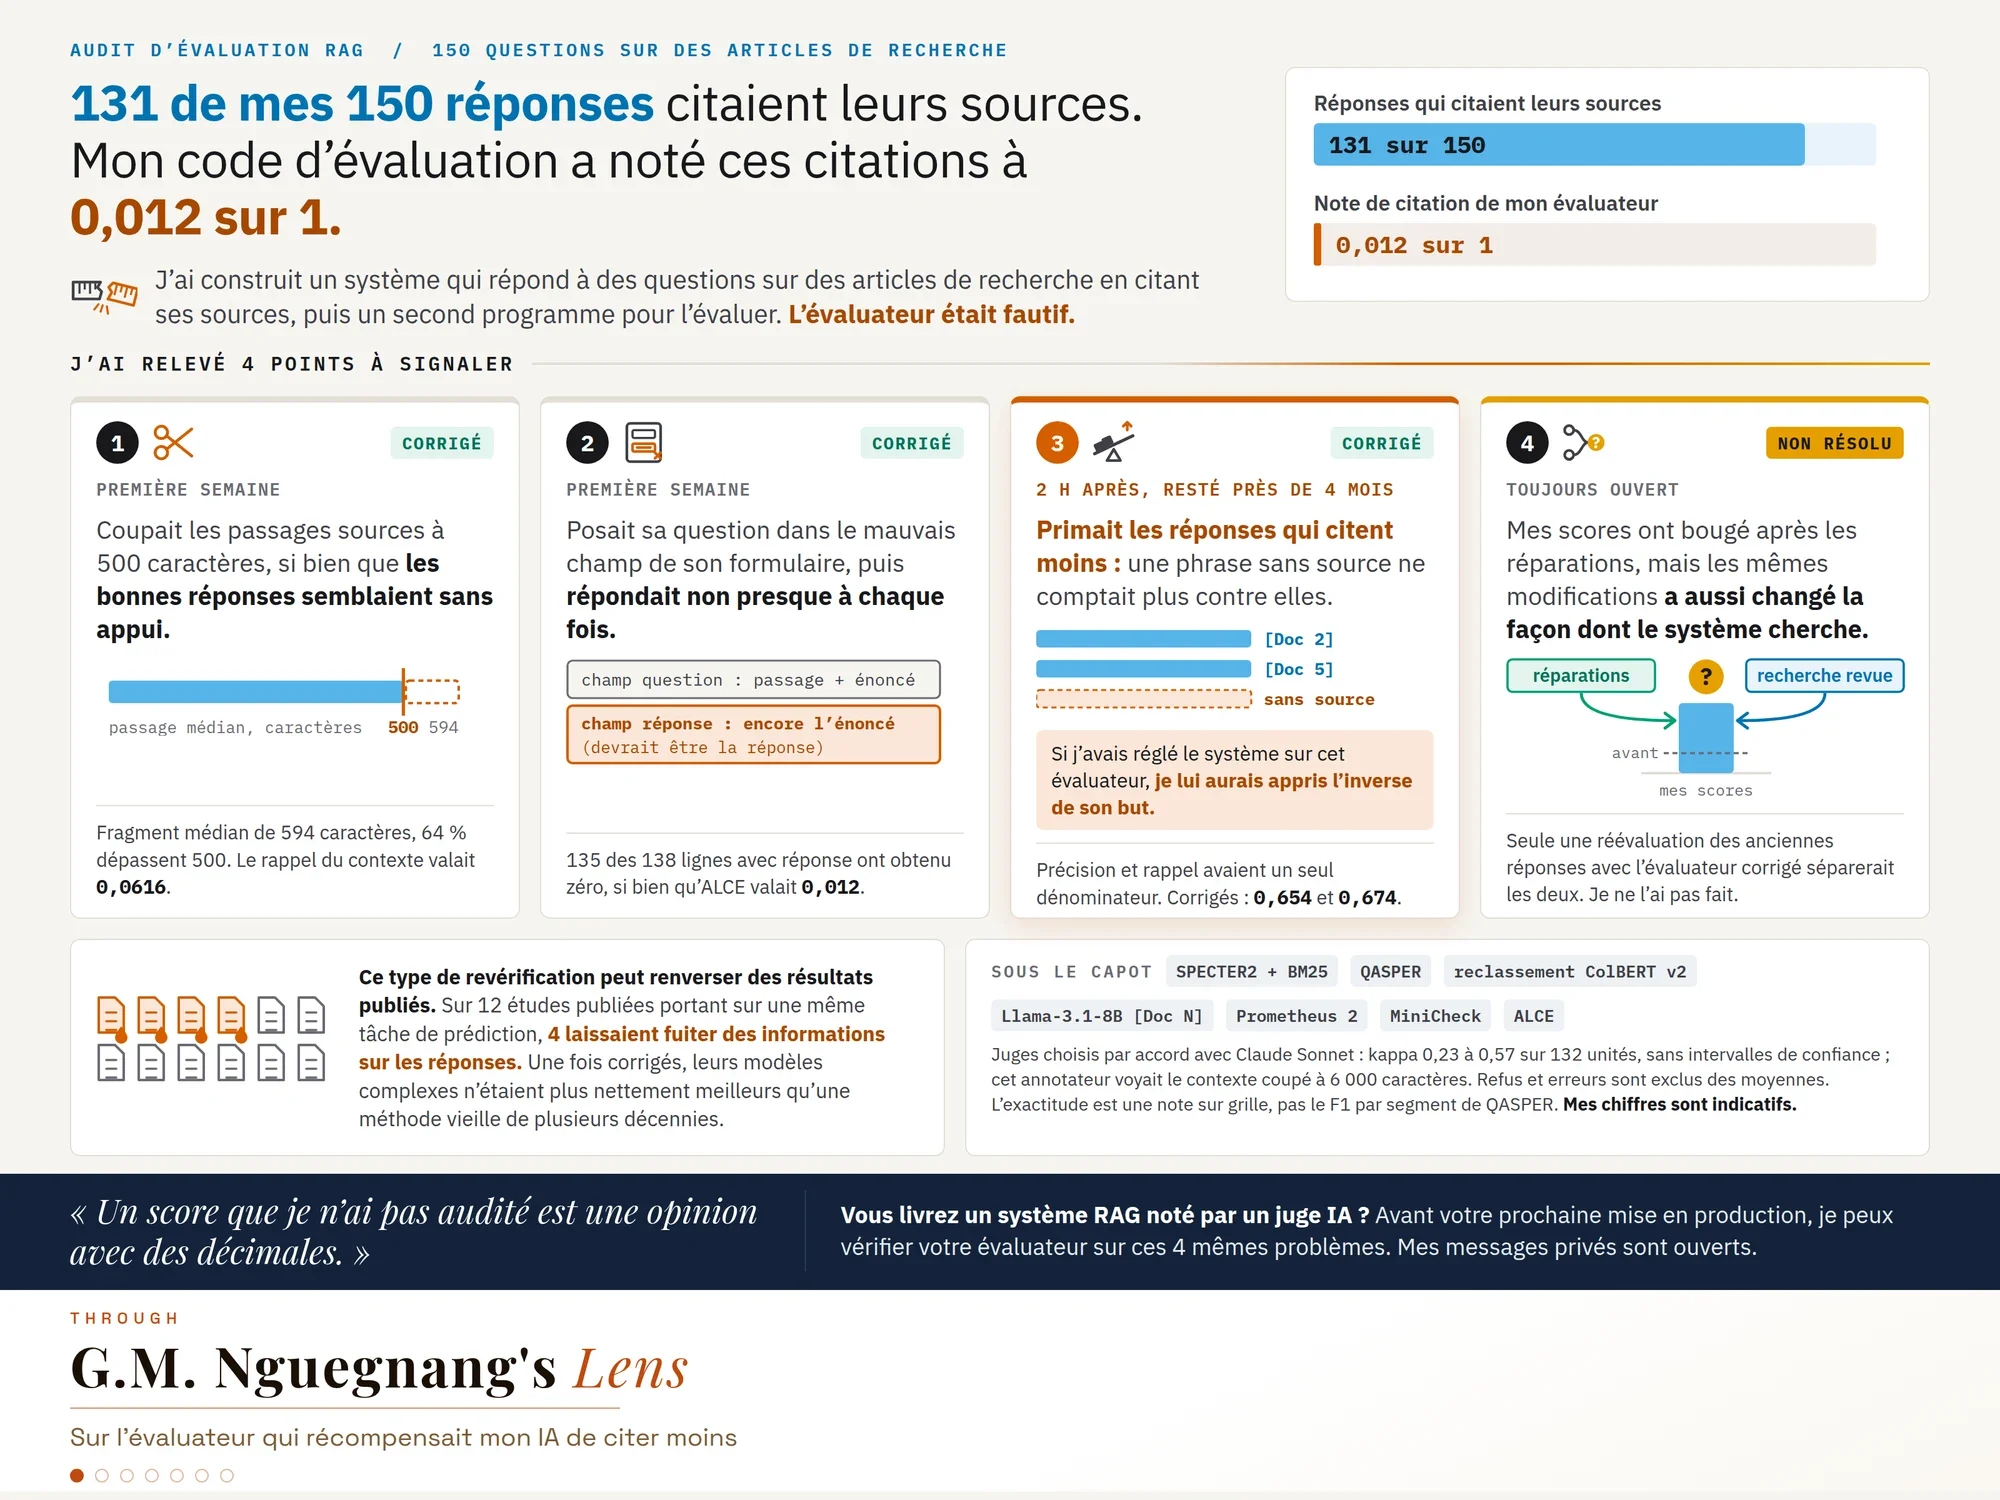
131 de mes 150 réponses citaient leurs sources. Mon code d’évaluation a noté ces citations à 0,012 sur 1.
J’ai construit un système qui répond à des questions sur des articles de recherche et cite ses sources. Puis j’ai écrit un second programme pour l’évaluer.
C’est l’évaluateur qui était fautif.
Pourquoi cela compte
J’ai relevé 4 points qui méritent d’être signalés.
Dès sa première semaine, mon évaluateur coupait les passages sources à 500 caractères, si bien que les bonnes réponses semblaient sans appui. Il posait aussi sa question dans le mauvais champ de son formulaire, puis répondait non presque à chaque fois.
J’ai corrigé les deux. Deux heures plus tard, j’ai introduit le troisième bogue, et il est resté dans mon évaluateur pendant près de quatre mois.
Il récompensait les réponses qui citaient moins : une phrase sans source ne comptait plus contre elles. Si j’avais réglé le système sur cet évaluateur, je lui aurais appris l’inverse de ce pour quoi je l’ai construit.
Le quatrième, je ne peux pas le trancher. Mes scores ont bougé après les réparations, mais le même lot de modifications a aussi changé la façon dont le système cherche. Seule une réévaluation des réponses d’avant les réparations, avec l’évaluateur corrigé, permettrait de séparer les deux effets, et je ne l’ai pas faite.
Ce type de revérification peut renverser des résultats publiés. Quand des chercheurs ont revérifié 12 études publiées sur une même tâche de prédiction, 4 laissaient fuiter des informations sur les réponses dans les données d’apprentissage des modèles. Une fois ce défaut corrigé, leurs modèles complexes n’étaient plus nettement meilleurs qu’une méthode vieille de plusieurs décennies.
Un score que je n’ai pas audité est une opinion avec des décimales.
Comment cela fonctionne
SPECTER2 et BM25 sur QASPER, reclassement par ColBERT v2, Llama-3.1-8B qui cite sous la forme [Doc N]. Juges : Prometheus 2 et MiniCheck. Métrique de citation : ALCE.
Défaut 1 : une troncature c[:500] avant le calcul du rappel du contexte et de la fidélité. Fragment médian de 594 caractères, 64 % dépassent 500. Le rappel du contexte valait 0,0616.
Défaut 2 : la vérification d’implication plaçait l’affirmation dans le champ de réponse de Prometheus 2, qui attend la réponse évaluée. 135 des 138 lignes avec réponse obtenaient zéro, si bien qu’ALCE valait 0,012.
Défaut 3 : précision et rappel partageaient un même dénominateur, et un commentaire du code l’attribuait à l’article d’ALCE. ALCE fait la moyenne du rappel sur les énoncés et de la précision sur les citations. Les deux valeurs étaient identiques sur les 128 lignes notées ; une fois corrigées, elles se séparent en 0,654 et 0,674.
Après avoir abandonné RAGAS, j’ai choisi le juge de chaque métrique selon son accord avec un second juge IA, Claude Sonnet : kappa de 0,23 à 0,57, un accord passable à modéré, sur 132 unités, sans intervalles de confiance. Cet annotateur voyait le contexte coupé à 6 000 caractères, la même famille de bogue que le défaut 1. Ses annotations sont à refaire avec le contexte complet.
Les refus et les erreurs sont exclus de chaque moyenne, si bien que corriger un refus peut faire baisser une moyenne. L’exactitude des réponses est une note sur grille, pas le F1 par segment de QASPER, que je ne calcule pas encore. Considérez mes chiffres comme indicatifs.
Vous livrez un système RAG noté par un juge IA ? Avant votre prochaine mise en production, je peux vérifier votre évaluateur sur ces 4 mêmes problèmes. Écrivez-moi en message privé.