60 des 150 questions sur lesquelles je teste mon IA renvoient à un tableau ou à une figure. Mon IA n'en voyait aucun
Mon assistant IA cherche dans les articles de recherche avant de répondre, et sa recherche ignorait chaque tableau et chaque figure. En corrigeant ce défaut, j'en ai trouvé un second, dans la grille qui sert à l'évaluer.
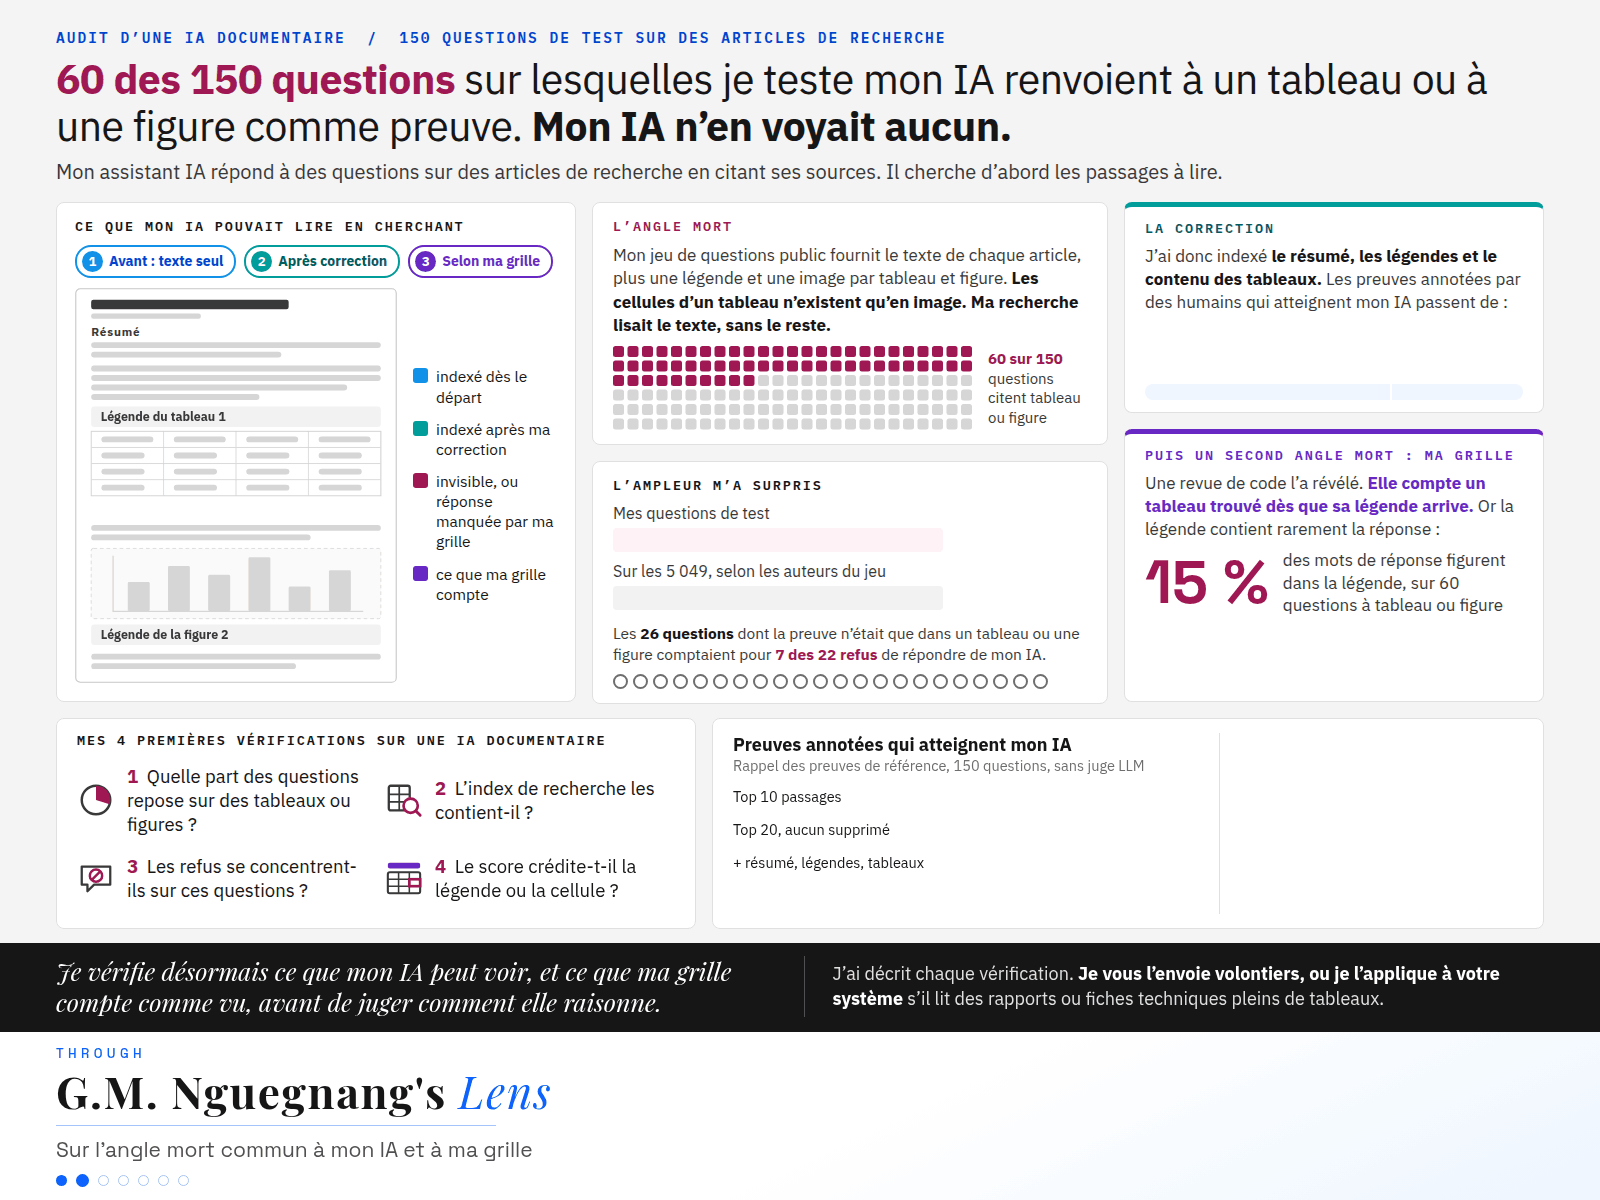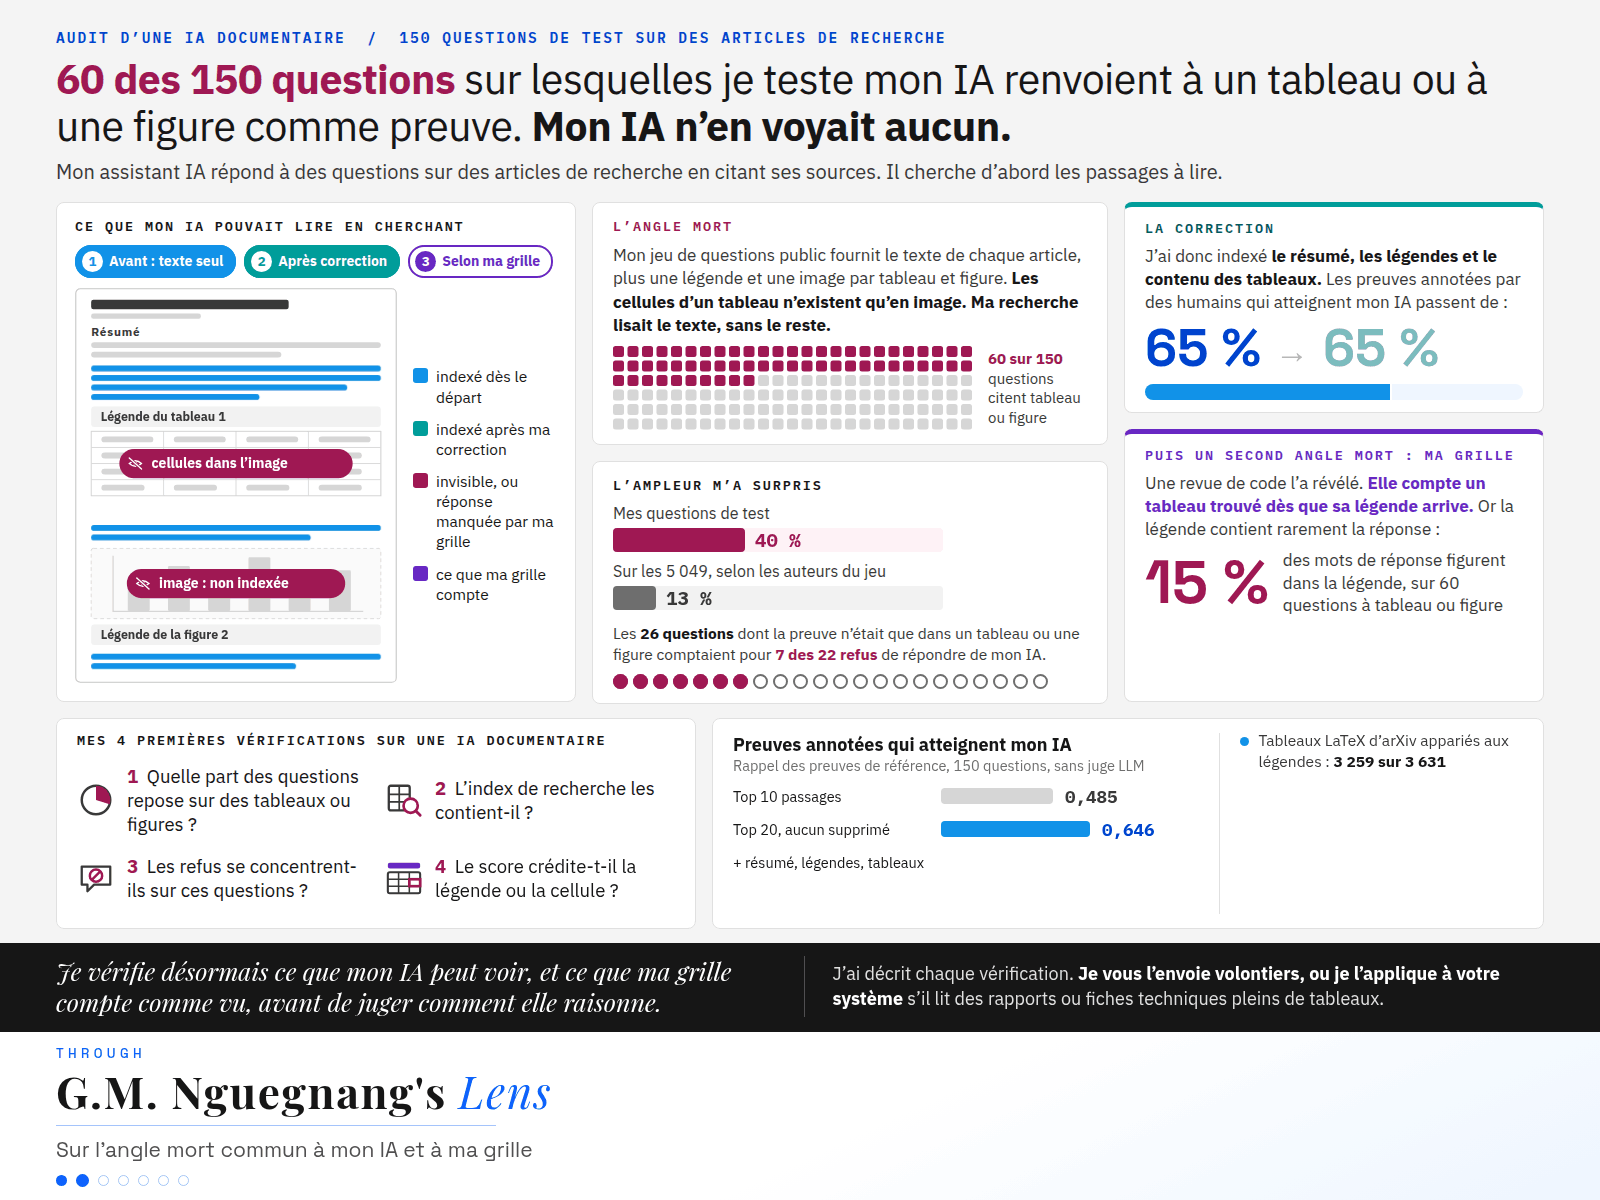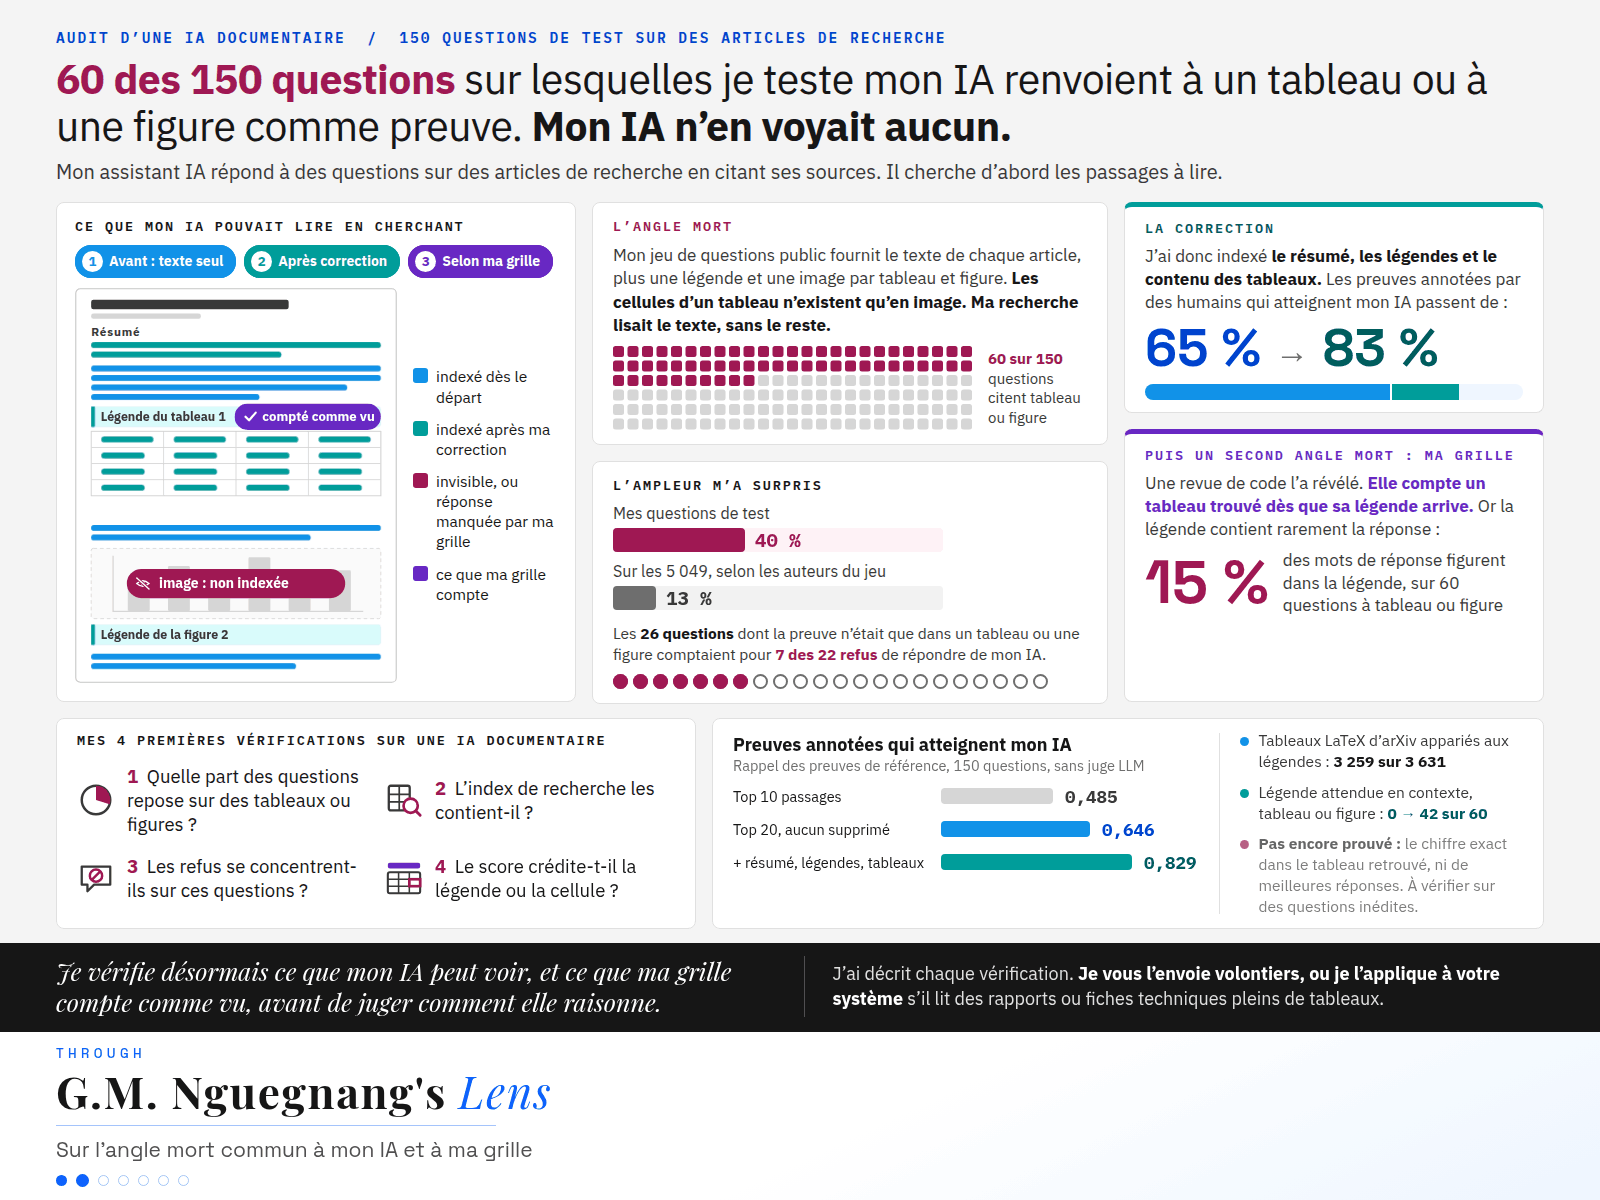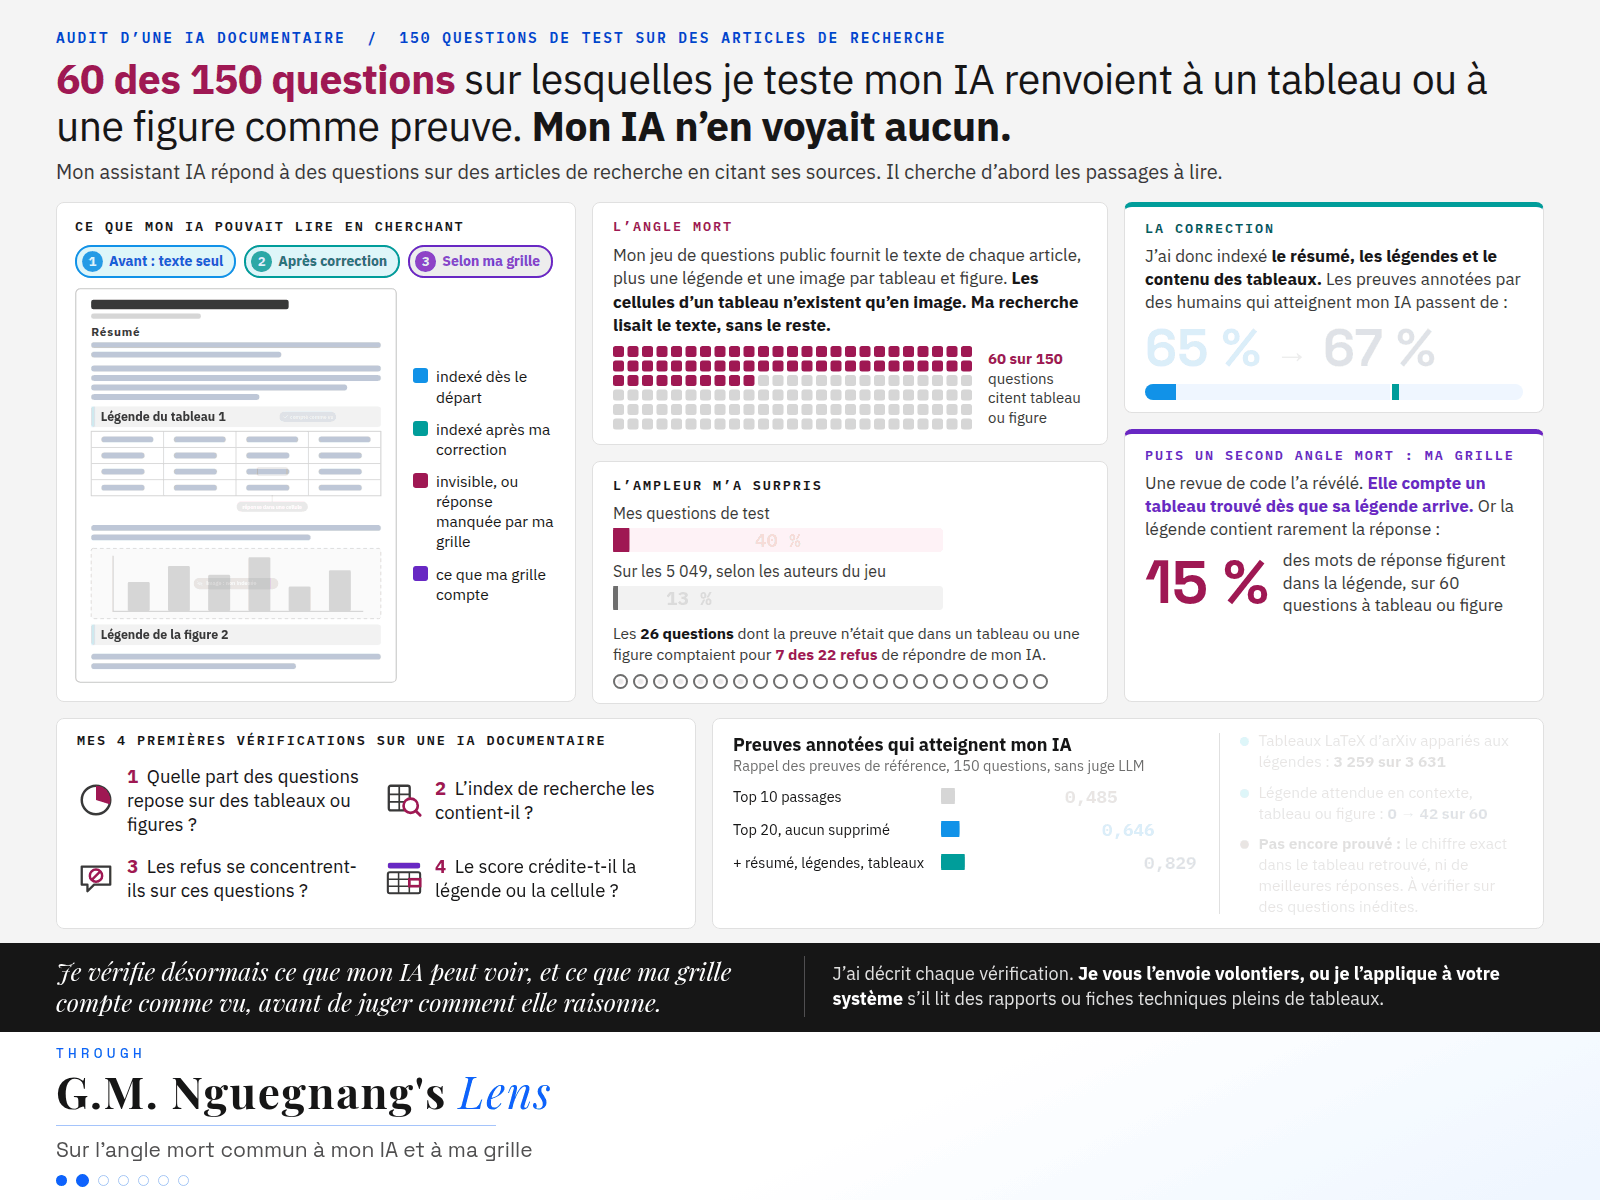
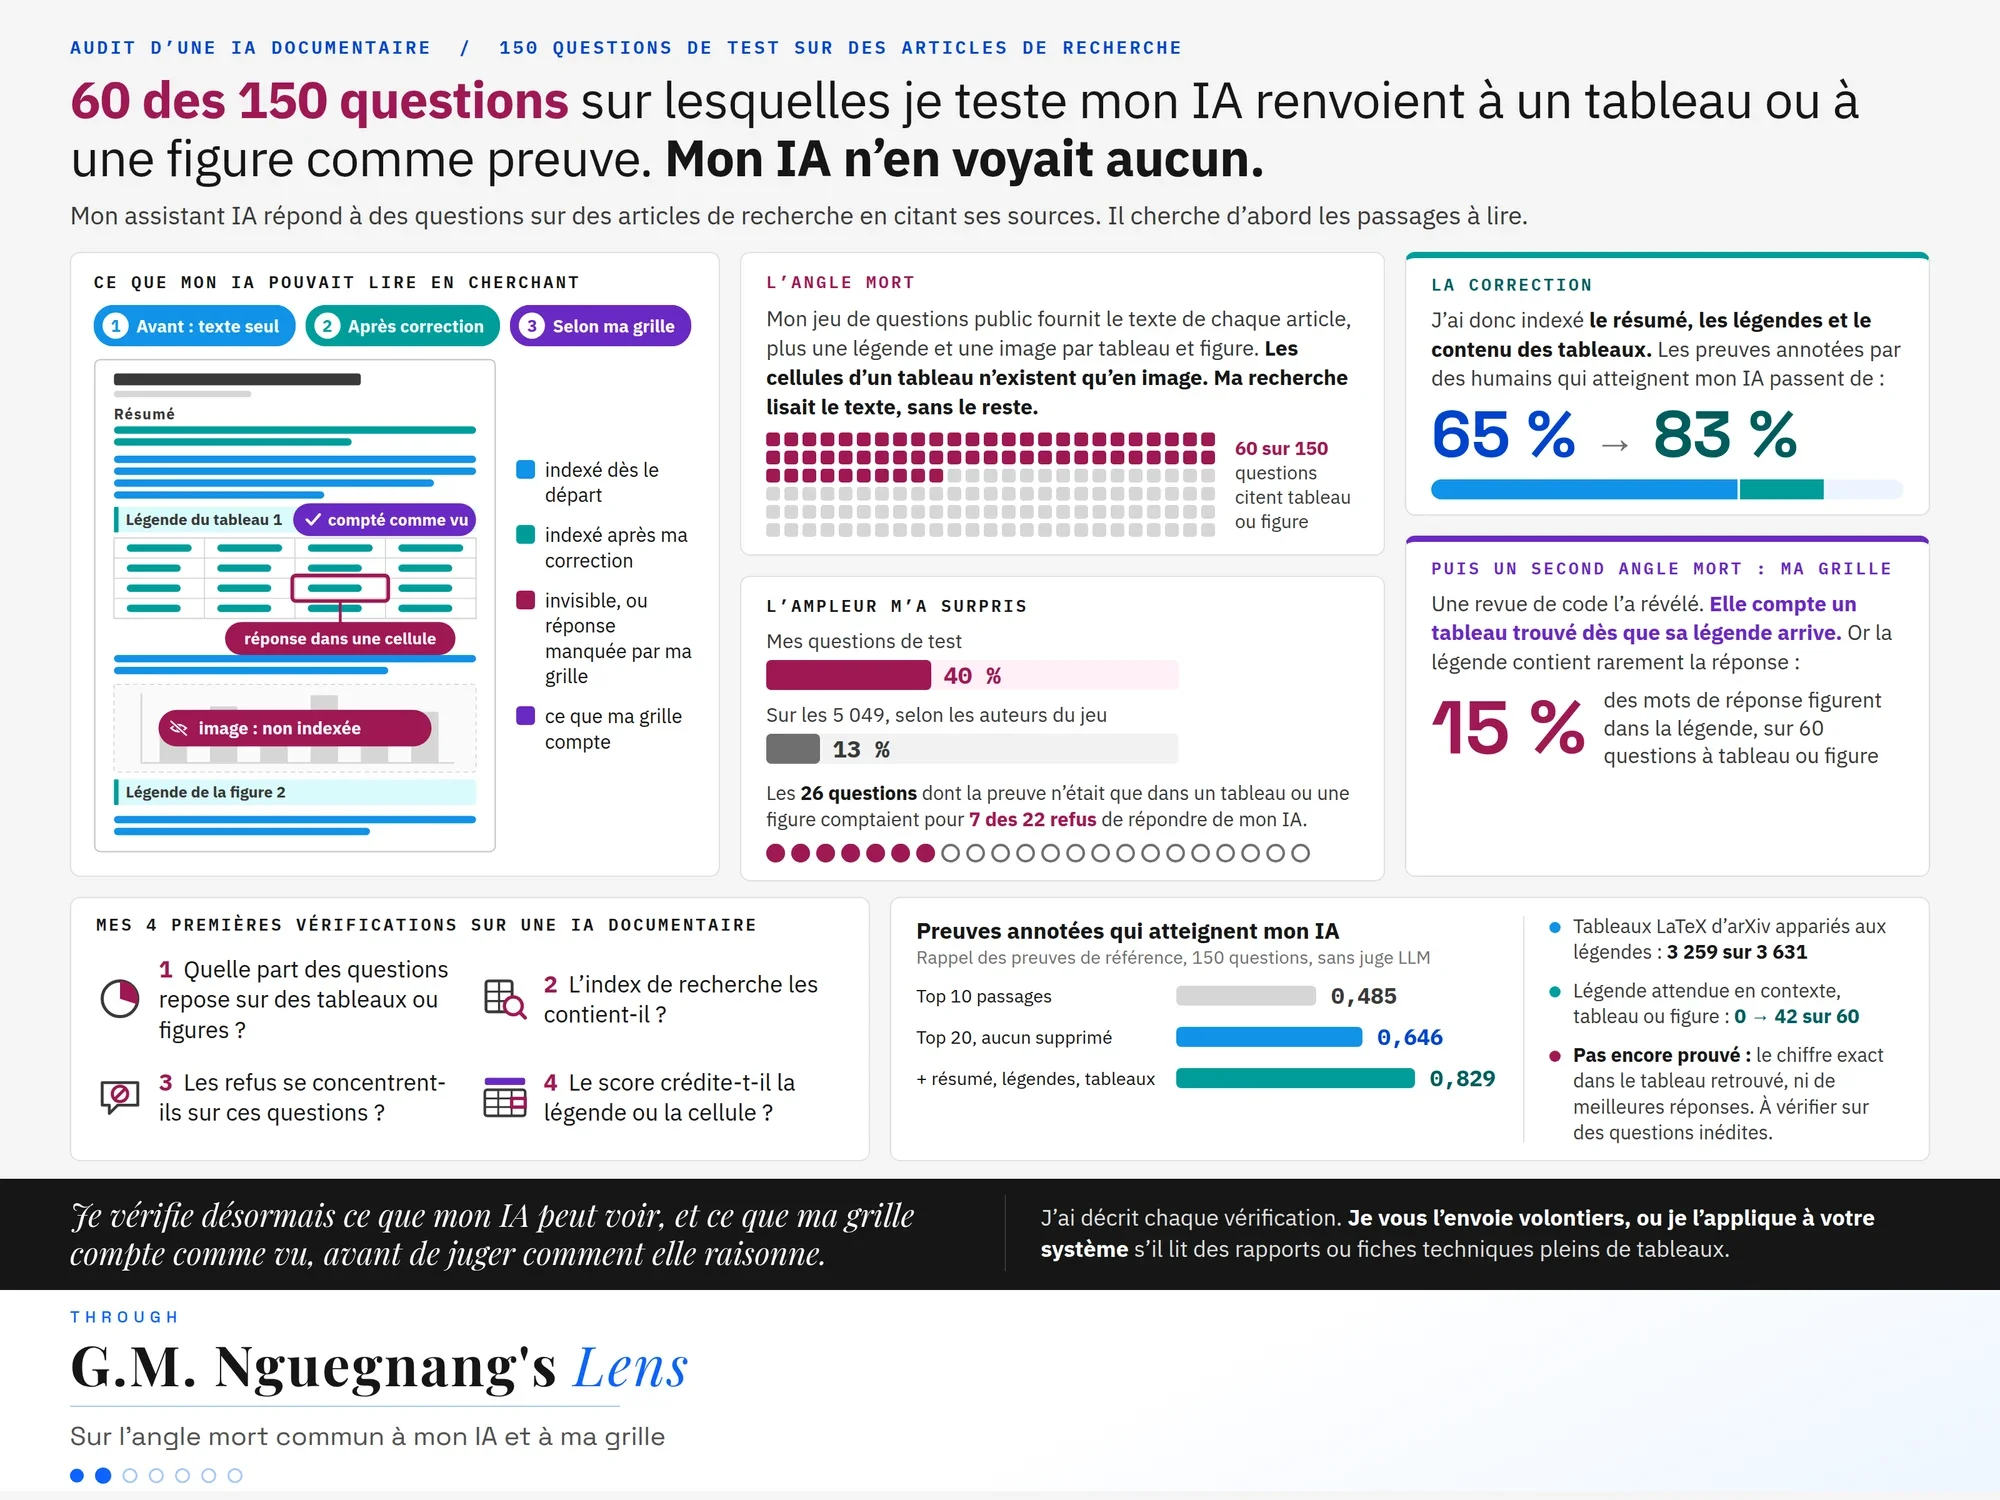
60 des 150 questions sur lesquelles je teste mon IA renvoient à un tableau ou à une figure comme preuve.
Mon IA n’en voyait aucun.
Pourquoi cela compte
Je construis un assistant IA qui répond à des questions sur des articles de recherche et cite ses sources. Avant de répondre, il cherche dans l’article les passages à lire.
Le jeu de questions public sur lequel je le teste fournit le texte de chaque article, plus une légende et une image pour chaque tableau et chaque figure. Dans ces données, les cellules d’un tableau n’existent que dans l’image. Ma recherche lisait le texte et ignorait le reste.
L’ampleur m’a surpris : 40 % de mes questions de test, contre 13 % sur l’ensemble des 5 049 selon les auteurs du jeu. Les 26 questions dont la preuve se trouvait uniquement dans un tableau ou une figure comptaient pour 7 des 22 refus de répondre de mon IA.
J’ai donc rendu cherchables le résumé, les légendes et le contenu des tableaux. La part des preuves annotées par des humains qui parvient à mon IA est passée de 65 % à 83 %.
Une revue de code a ensuite révélé un second angle mort, dans ma propre grille d’évaluation. Elle compte un tableau comme trouvé dès que sa légende arrive. Or les légendes contiennent rarement la réponse : sur les 60 questions à tableau ou figure, seuls 15 % des mots de la réponse figurent dans la légende.
Je vérifie désormais ce que mon IA peut voir, et ce que ma grille compte comme vu, avant de juger comment elle raisonne.
Comment cela fonctionne
Dans QASPER, le champ figures_and_tables contient une légende et un nom de fichier image. Ses auteurs ont écarté ces questions de leurs modèles de référence et laissé la réponse multimodale à des travaux futurs.
Les articles viennent d’arXiv avec leur source LaTeX. Je convertis donc les environnements tabular en Markdown, j’associe chacun à sa légende (Dice ≥ 0,6 sur les mots de la légende) et j’indexe la légende avec les lignes du tableau. 3 259 des 3 631 légendes de tableaux ont trouvé leur contenu.
Rappel des preuves de référence sur les 150 questions, sans grand modèle de langage (LLM) comme juge :
- 0,485 → 0,646 : 20 passages au lieu de 10, aucun supprimé
- 0,829 avec les fragments de résumé, de légendes et de tableaux
- Questions à tableau ou figure avec la légende de référence en contexte : 0 → 42 sur 60
Ce que je ne peux pas encore affirmer : que le tableau retrouvé contient le chiffre exact demandé, ni que les réponses se sont améliorées. J’ai réglé le système sur ces 150 questions, donc les deux points seront testés sur des questions inédites.
Les 4 vérifications que je fais désormais en premier sur une IA documentaire :
- Quelle part des questions de test repose sur des tableaux ou des figures ?
- L’index de recherche les contient-il ?
- Les refus se concentrent-ils sur ces questions ?
- Le score crédite-t-il la légende ou la cellule ?
J’ai décrit comment je mène chaque vérification. Je vous envoie volontiers ce document, ou j’applique ces vérifications à votre système s’il lit des rapports ou des fiches techniques remplis de tableaux.