Sans les noms de colonnes, GPT-4 obtenait 0,55 sur 1 sur des tables GitHub. Sur des tables de clients SAP : 0,03
Les tables d'entreprise stockent des codes, pas leur sens. Une étude de GPT-4 sur de vraies tables de clients SAP montre ce qu'une IA en fait : elle voit ce qui s'est passé, puis devine ce que cela veut dire.
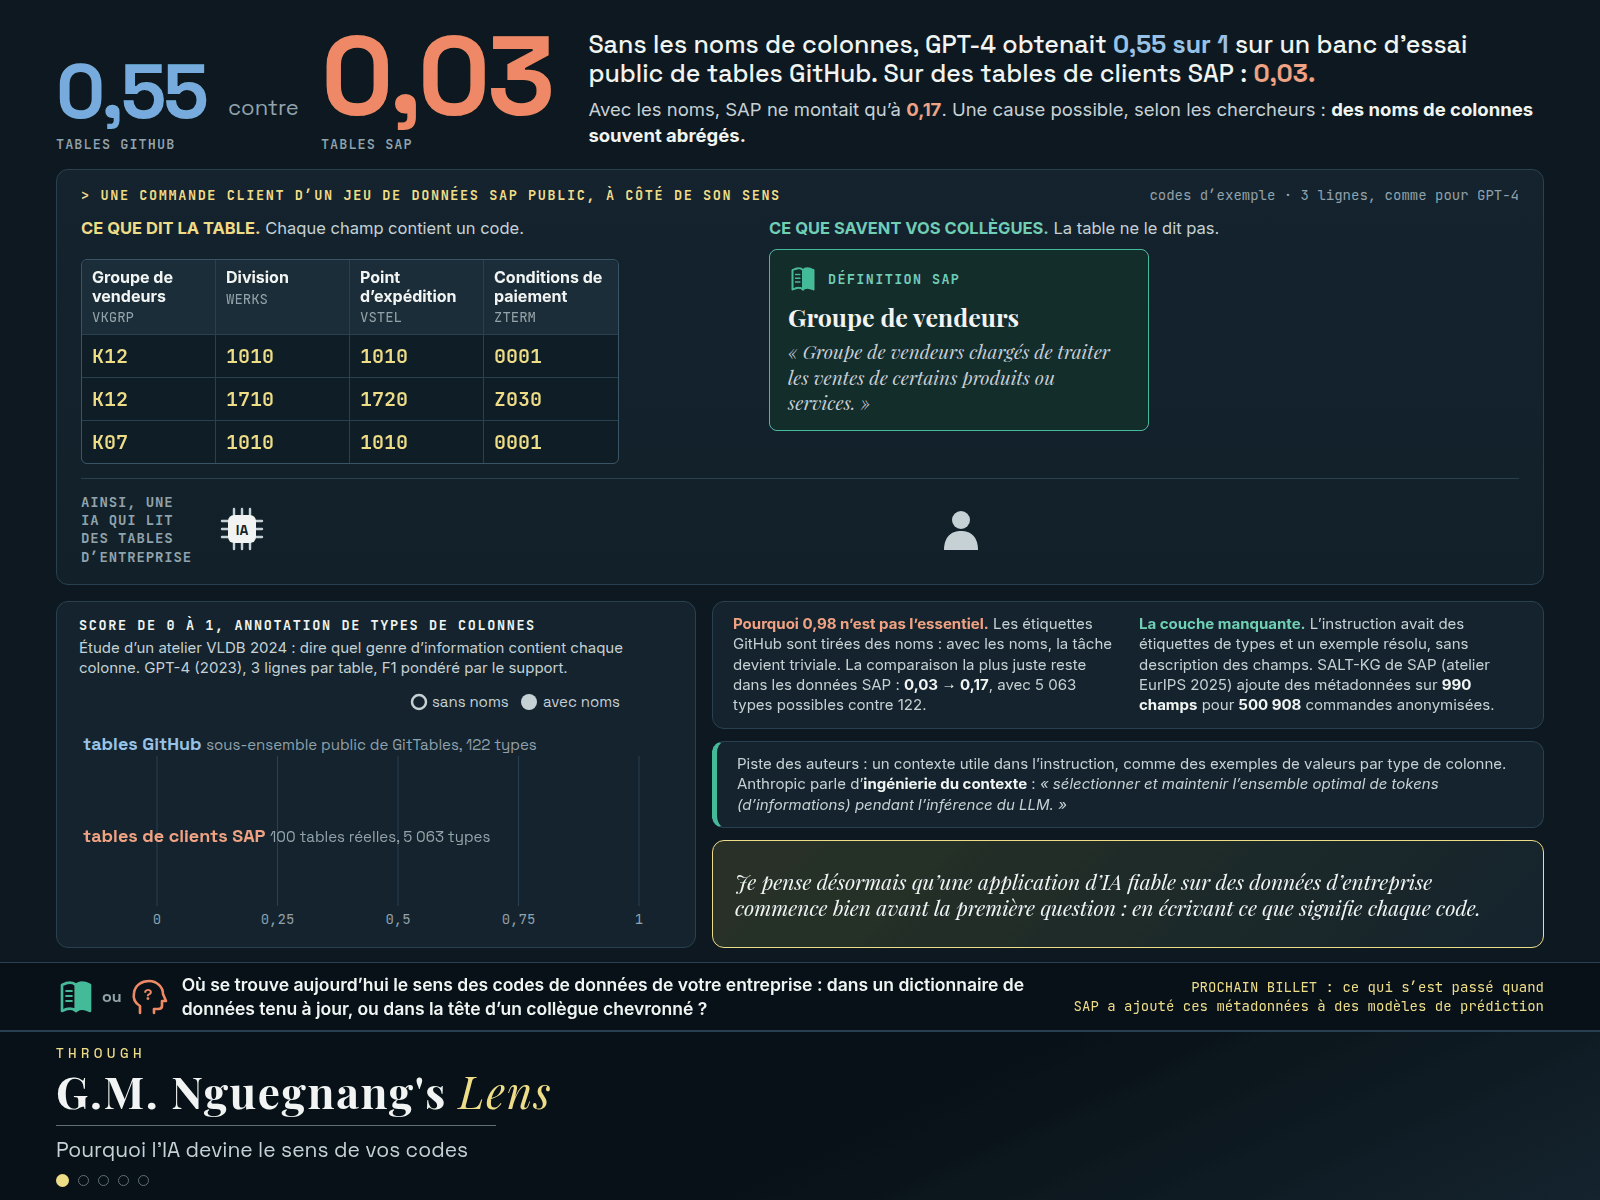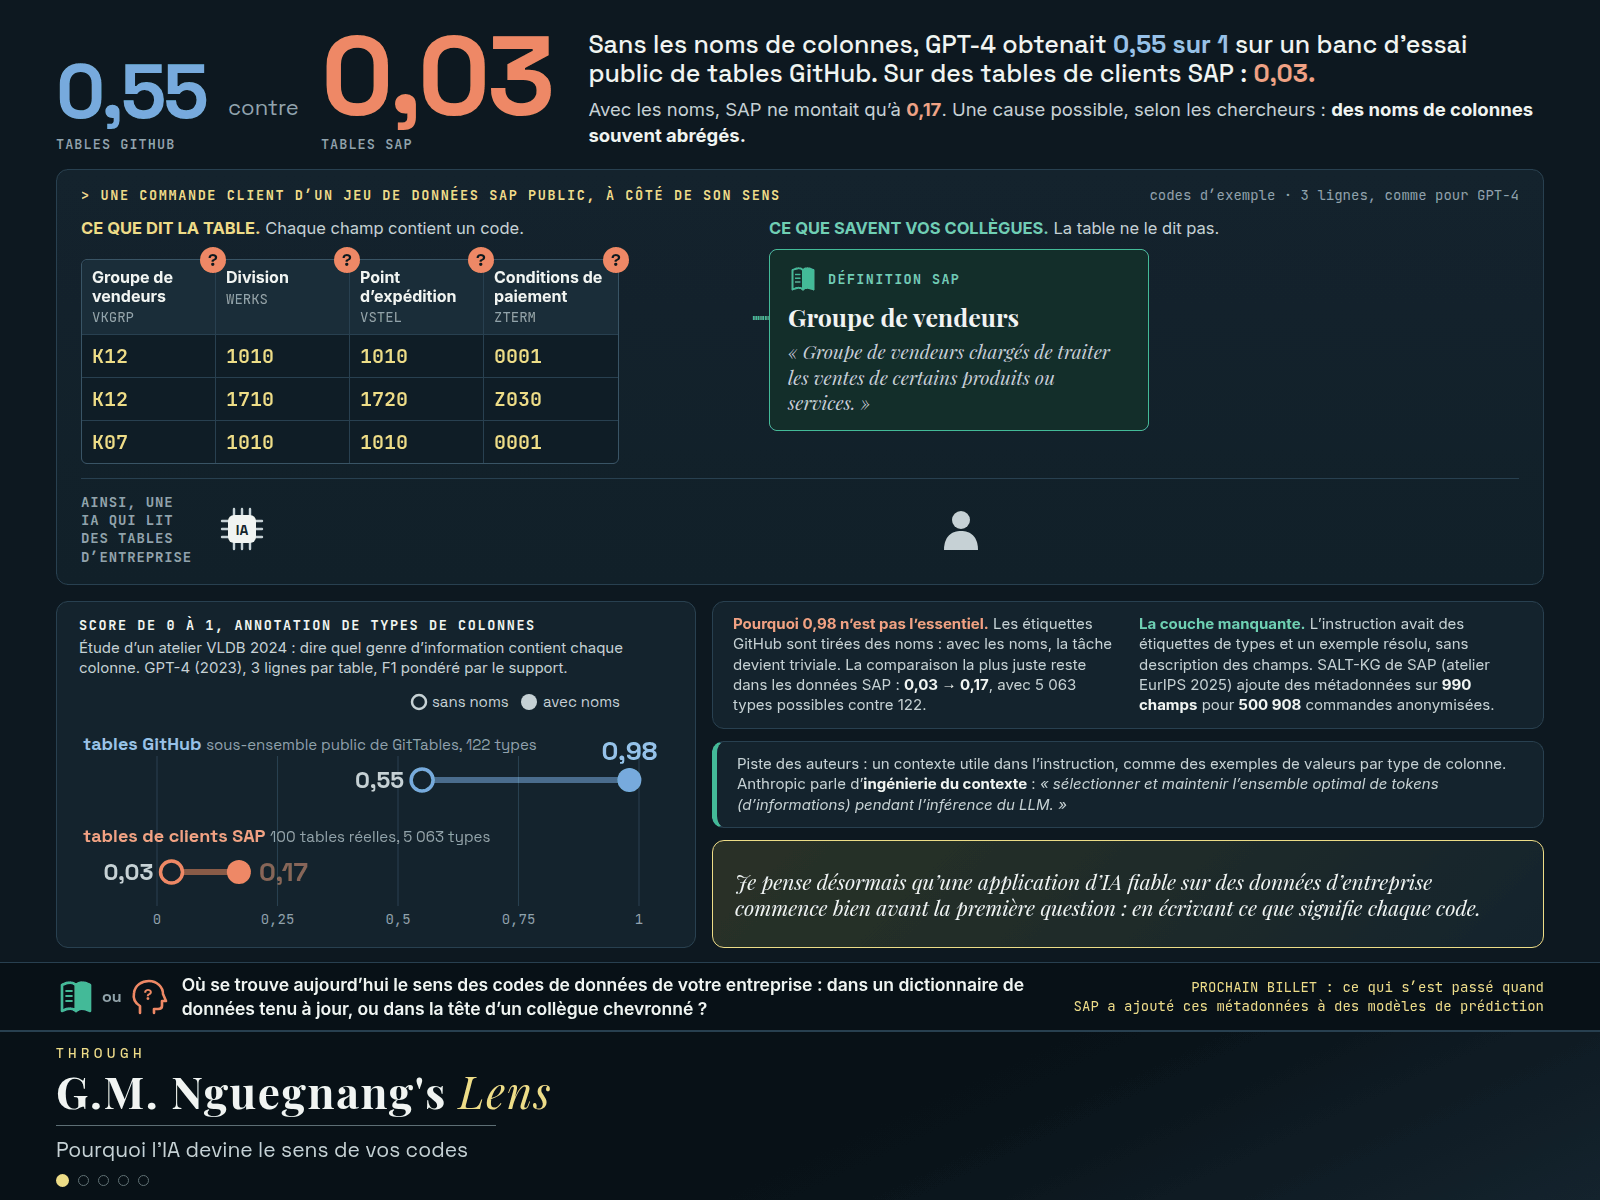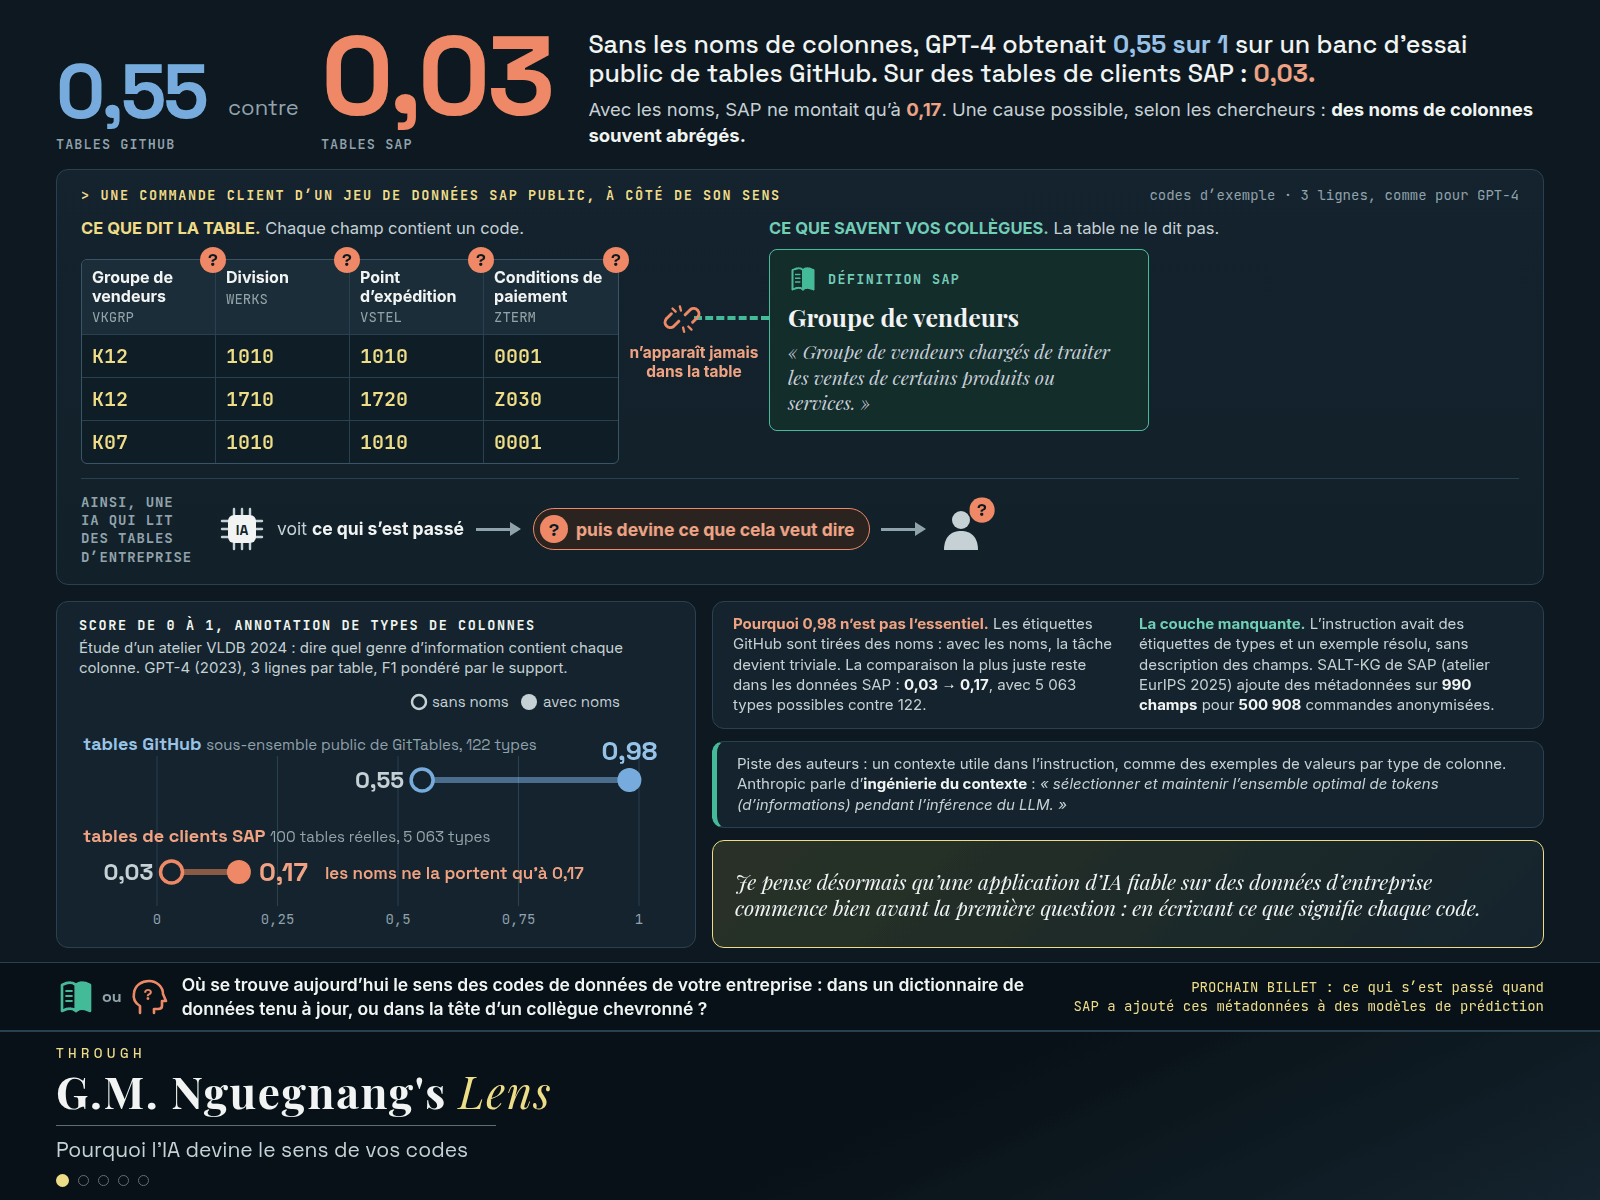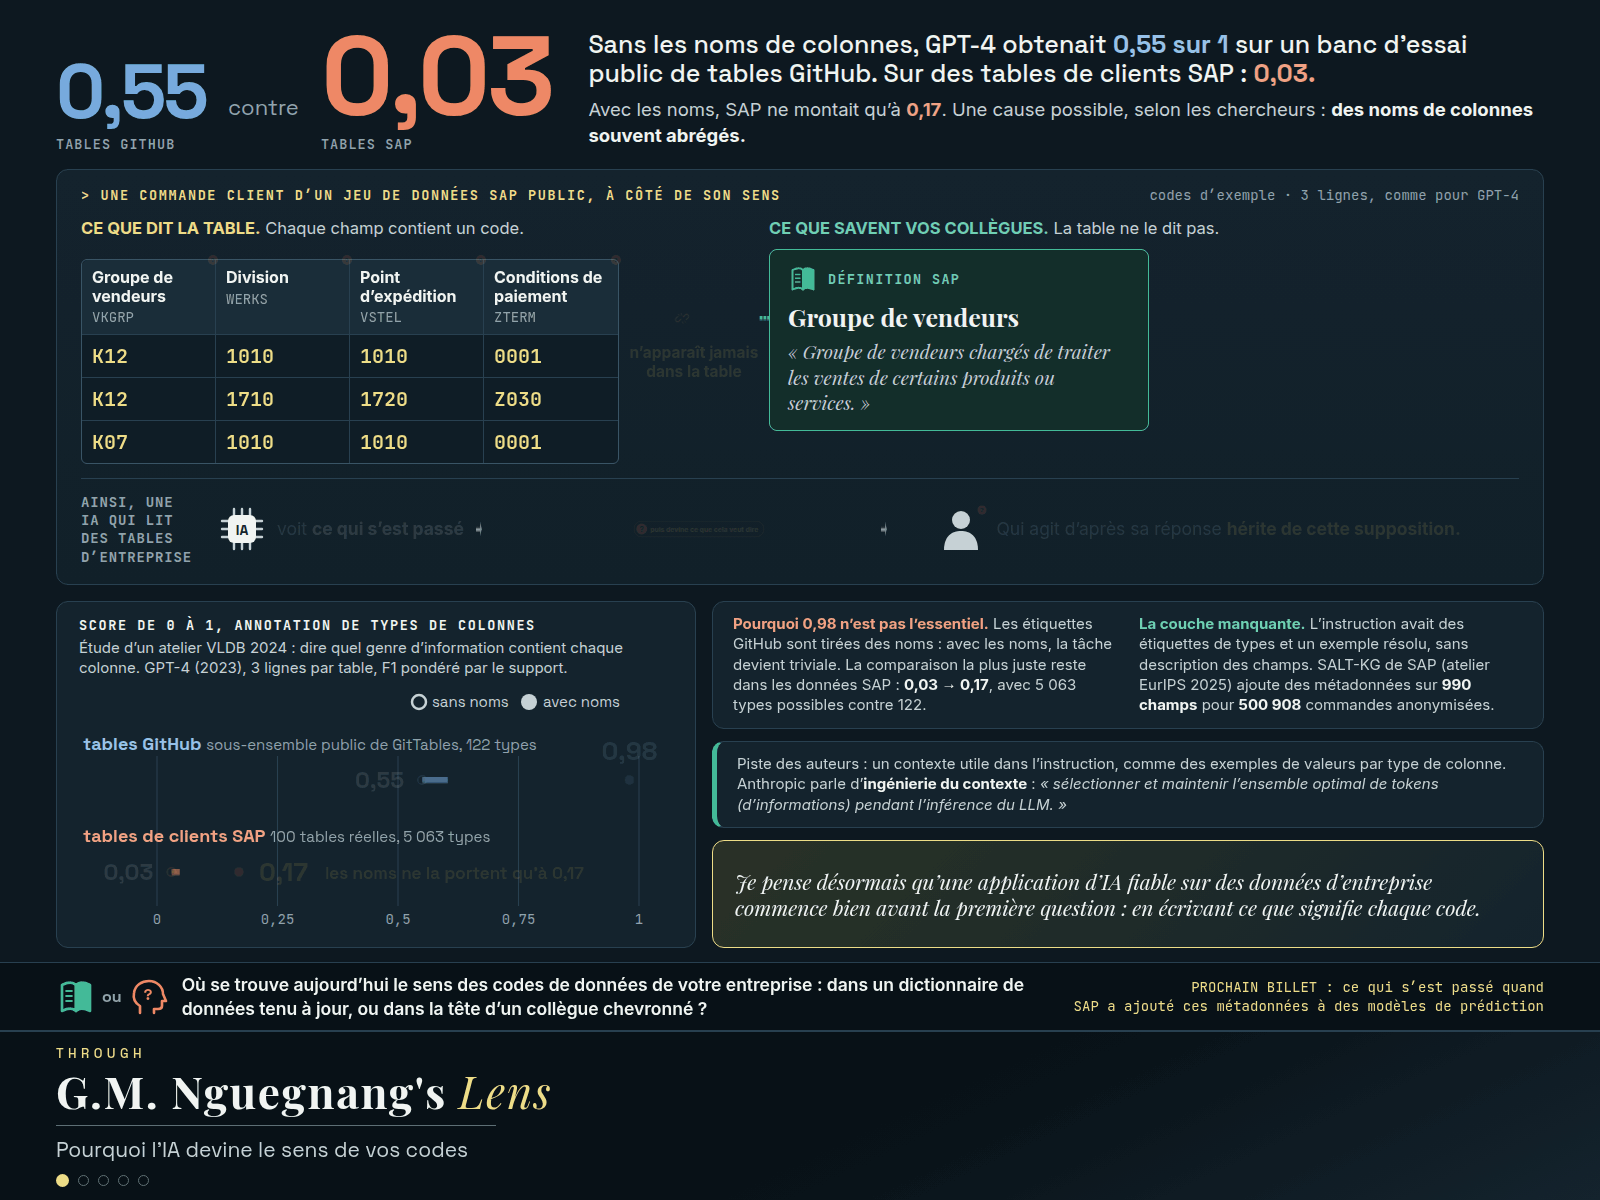
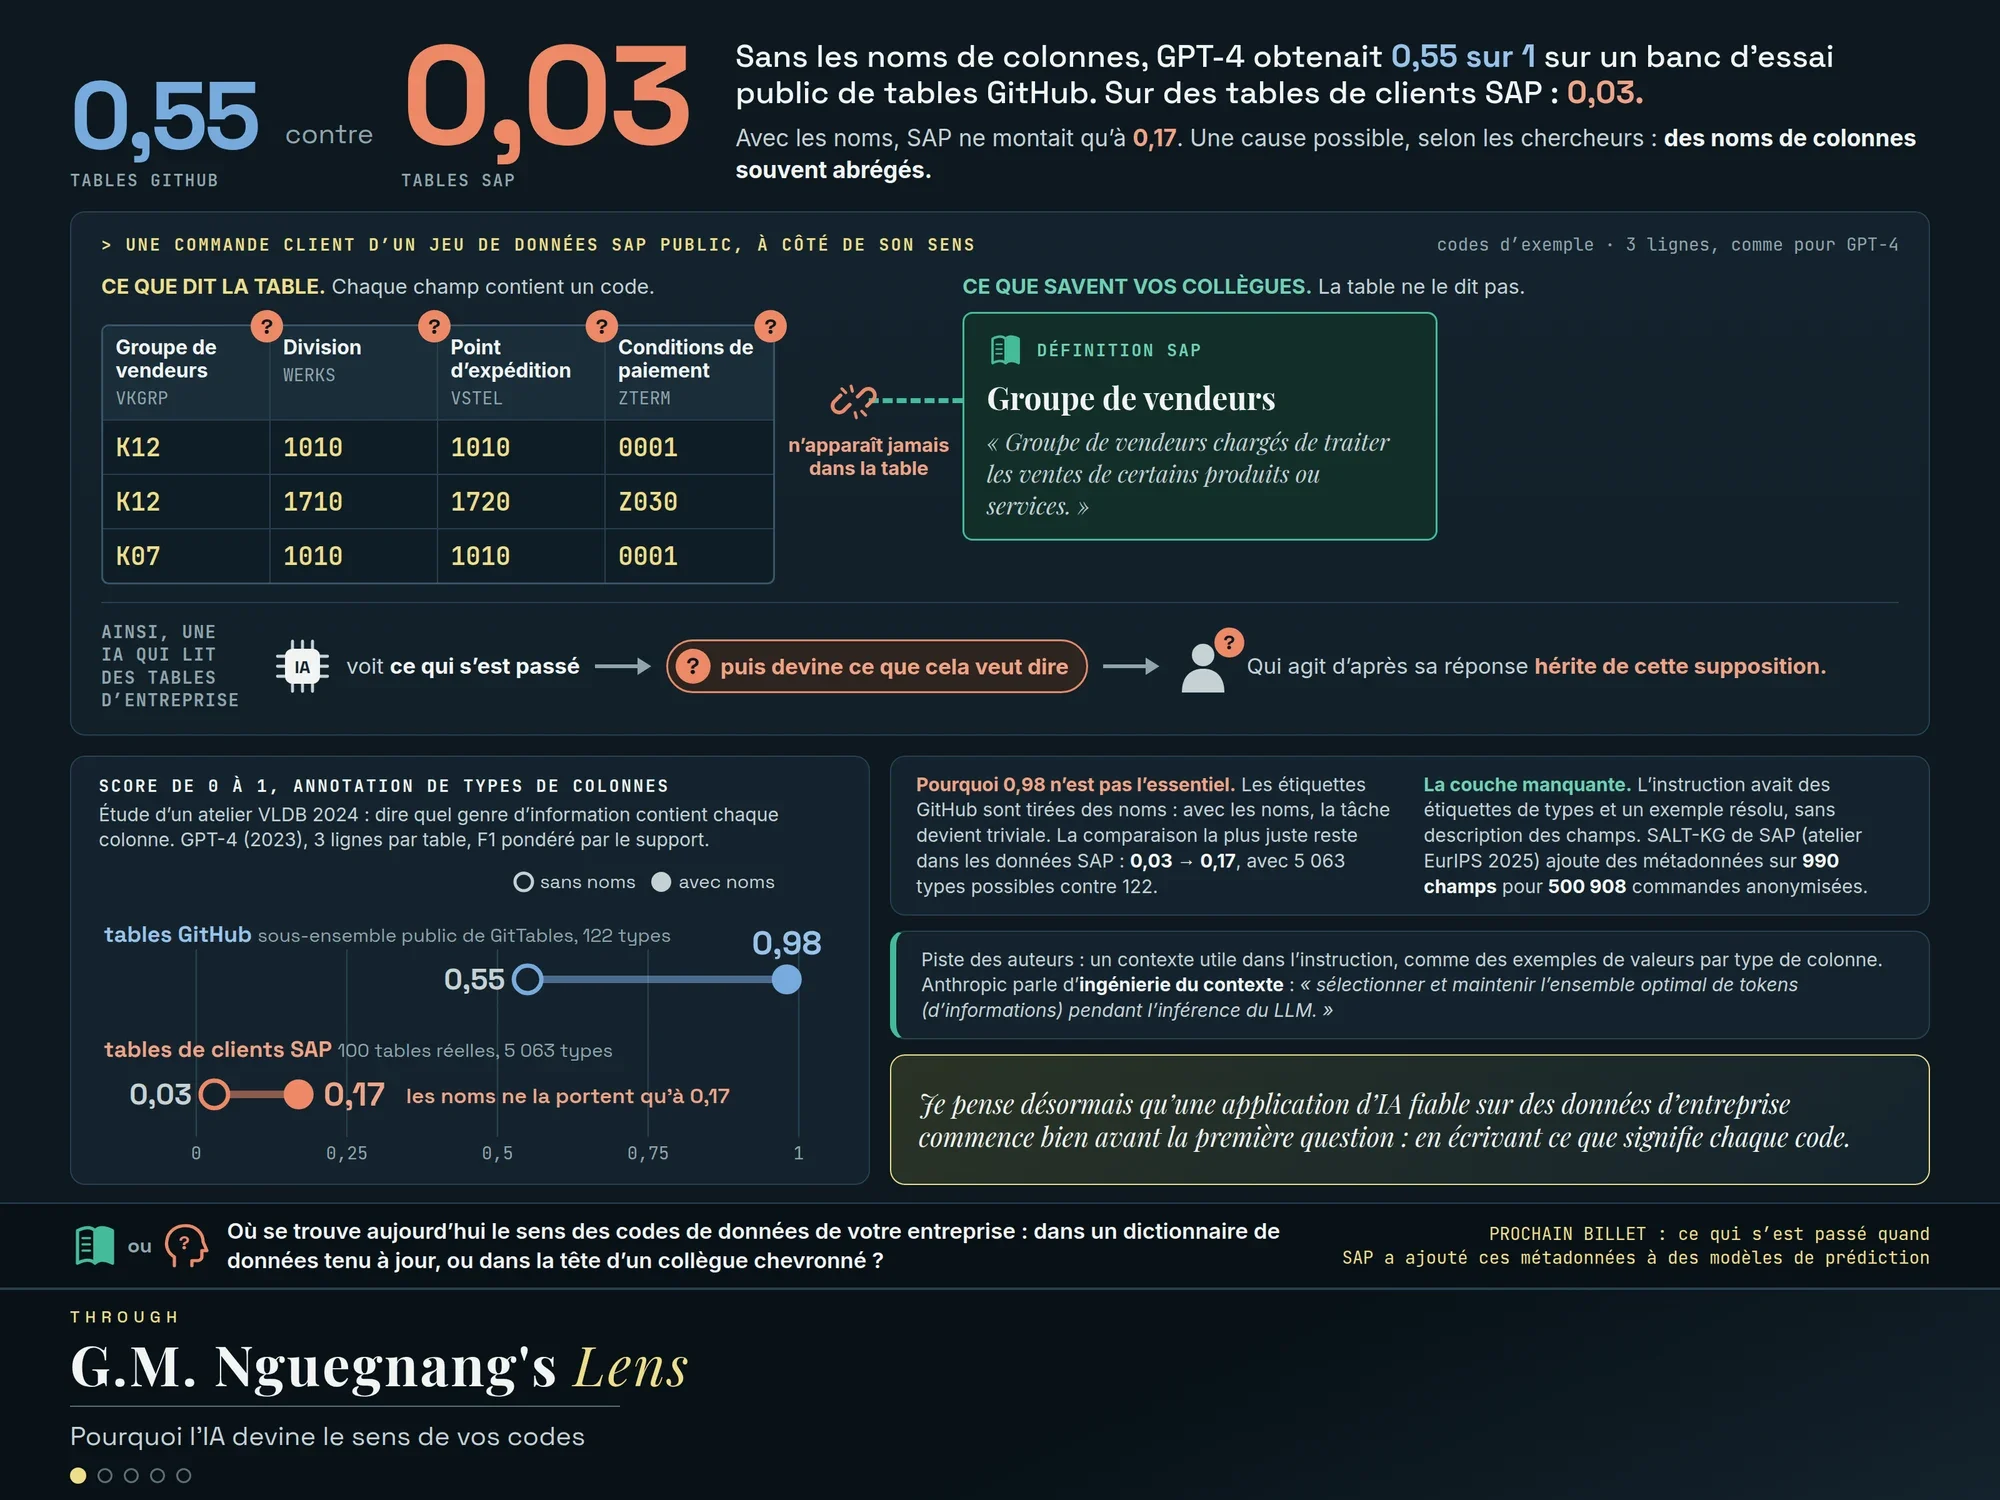
Sans les noms de colonnes, GPT-4 obtenait 0,55 sur 1 sur un banc d’essai public de tables GitHub. Sur des tables de clients SAP : 0,03.
Avec les noms, SAP ne montait qu’à 0,17. Une cause possible, selon les chercheurs : des noms de colonnes souvent abrégés.
Pourquoi cela compte
Prenez une commande client tirée d’un jeu de données SAP public. Elle contient des champs comme Groupe de vendeurs, Division, Point d’expédition et Conditions de paiement. Chacun contient un code.
Vos collègues savent ce que ces codes désignent. La table ne le dit pas.
SAP définit le groupe de vendeurs ainsi : « A group of sales people who are responsible for processing sales of certain products or services » (un groupe de vendeurs chargés de traiter les ventes de certains produits ou services). Dans les données de vente publiées, cette colonne ne contient que des codes courts.
La phrase existe. Elle n’apparaît jamais dans la table elle-même, comme le montre l’infographie côte à côte.
Une IA qui lit des tables d’entreprise voit donc souvent ce qui s’est passé, puis devine ce que cela veut dire. Qui agit d’après sa réponse hérite de cette supposition.
Je pense désormais qu’une application d’IA fiable sur des données d’entreprise commence bien avant la première question : en écrivant ce que signifie chaque code.
Comment cela fonctionne
Les chiffres viennent d’une étude présentée dans un atelier de VLDB 2024 sur l’annotation de types de colonnes : dire quel genre d’information contient chaque colonne. Le score est un F1 pondéré par le support, de 0 à 1.
Avec les noms, les scores sont de 0,98 sur un sous-ensemble public de GitTables contre 0,17 sur 100 tables réelles de clients SAP. L’écart paraît plus large, mais les auteurs expliquent pourquoi les évaluations existantes laissent d’ordinaire les noms de côté : les étiquettes en sont tirées, et la tâche deviendrait triviale.
Le jeu SAP compte aussi 5 063 types possibles contre 122. La comparaison la plus juste reste donc à l’intérieur des données SAP : les noms n’ont fait passer un GPT-4 de 2023, à qui l’on montrait 3 lignes par table, que de 0,03 à 0,17. L’instruction générative (prompt) contenait une liste d’étiquettes de types et un exemple résolu, mais aucune description des champs.
Une piste suggérée par les auteurs : ajouter à l’instruction un contexte utile, comme des exemples de valeurs pour chaque type de colonne. Cela relève de ce qu’Anthropic appelle l’ingénierie du contexte (context engineering) : « curating and maintaining the optimal set of tokens (information) during LLM inference », autrement dit sélectionner et maintenir l’ensemble optimal de jetons (d’informations) pendant l’inférence du grand modèle de langage.
Le banc d’essai SALT-KG de SAP (atelier EurIPS 2025) construit une partie de la couche manquante : des métadonnées sur 990 champs, dont une entrée pour chaque colonne de ses 500 908 commandes clients anonymisées, issues d’un vrai progiciel de gestion intégré (ERP).
Prochain billet : ce qui s’est passé quand SAP a ajouté ces métadonnées à des modèles de prédiction.
Où se trouve aujourd’hui le sens des codes de données de votre entreprise : dans un dictionnaire de données tenu à jour, ou dans la tête d’un collègue chevronné ?