1 sur 3 : des requêtes d'IA qui tournent sans erreur et répondent faux
Un test de 12 modèles d'IA évalué par les pairs : les requêtes du meilleur modèle s'exécutent presque toujours, mais environ 1 sur 3 renvoie quand même une mauvaise réponse. Les droits d'accès empêchent les dégâts. Ils ne repèrent pas une mauvaise réponse.
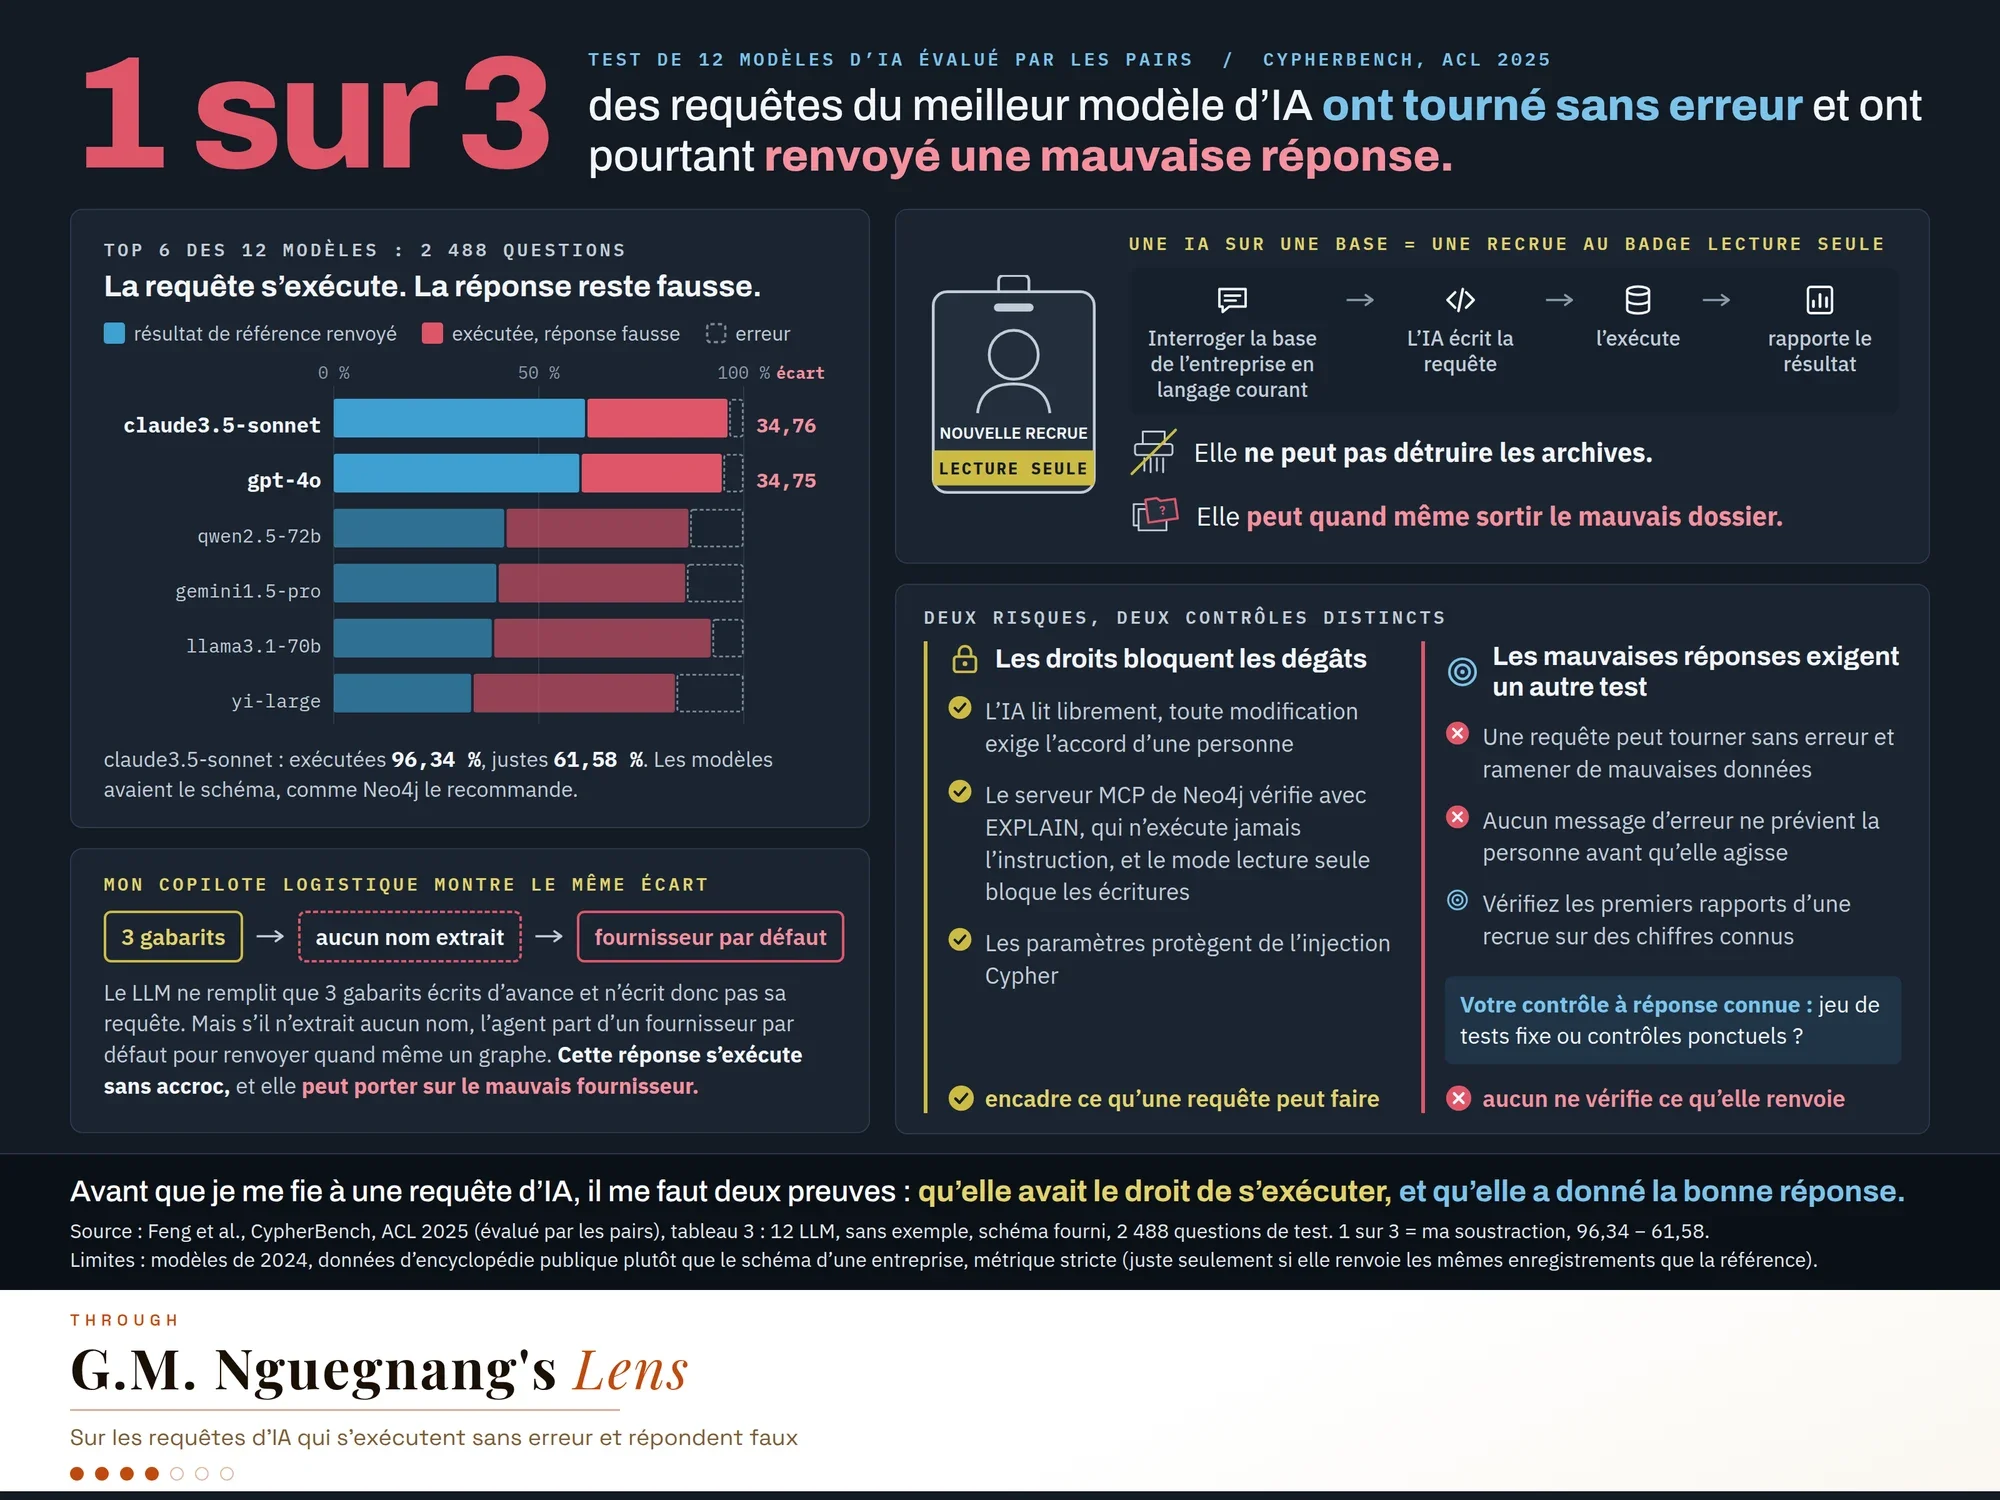
Environ 1 requête sur 3 écrite par le meilleur modèle d’IA s’est exécutée sans erreur et a pourtant renvoyé une mauvaise réponse. Le chiffre vient d’un test de 12 modèles évalué par les pairs.
Pourquoi cela compte
Les assistants d’IA permettent désormais d’interroger la base de données d’une entreprise en langage courant. L’IA écrit la requête, l’exécute et rapporte le résultat.
Les recommandations de sécurité de l’éditeur de la base sont solides. L’IA peut lire librement, et toute modification exige l’accord d’une personne. Imaginez une nouvelle recrue avec un badge en lecture seule : elle ne peut pas détruire les archives.
Elle peut quand même sortir le mauvais dossier. Une requête peut s’exécuter sans accroc et ramener les mauvais enregistrements, et aucun message d’erreur ne prévient la personne qui a posé la question avant qu’elle agisse.
Les deux risques demandent donc deux contrôles distincts. Les droits d’accès empêchent les dégâts. Les mauvaises réponses exigent un autre test, comme on vérifie les premiers rapports d’une recrue sur des chiffres déjà connus.
Avant de me fier à une requête d’IA, il me faut deux preuves : qu’elle avait le droit de s’exécuter, et qu’elle a donné la bonne réponse.
Comment cela fonctionne
CypherBench, un banc d’essai publié à ACL 2025, a donné à 12 LLM le schéma d’un graphe sans aucun exemple résolu, puis leur a demandé d’écrire en Cypher, le langage de requête de Neo4j, pour 2 488 questions de test.
Le meilleur modèle, claude3.5-sonnet, a écrit des requêtes qui s’exécutaient dans 96,34 % des cas. Seules 61,58 % renvoyaient le résultat de référence. Les modèles disposaient déjà du schéma, que les recommandations de Neo4j fournissent pour éviter les hallucinations.
Le « 1 sur 3 » est ma propre soustraction à partir du tableau de l’article : 96,34 moins 61,58. L’écart de GPT-4o est de 34,76 points.
Limites : des modèles de 2024, des données d’encyclopédie publique plutôt que le schéma d’une entreprise, et une métrique stricte, qui ne compte un résultat comme juste que s’il renvoie les mêmes enregistrements que la référence.
Le serveur MCP de Neo4j, la passerelle qui relie les assistants d’IA à Neo4j, classe les requêtes avec EXPLAIN, qui n’exécute jamais l’instruction, et bloque les écritures en mode lecture seule.
Les paramètres protègent de l’injection Cypher quand des valeurs entrent dans des requêtes écrites d’avance. Chaque contrôle encadre ce qu’une requête peut faire. Aucun ne vérifie ce qu’elle renvoie.
Mon copilote logistique montre le même écart. Le LLM ne fournit que des valeurs pour 3 gabarits écrits d’avance, il ne peut donc pas écrire sa propre requête. Mais quand il n’extrait aucun nom de la question, l’agent part d’un fournisseur par défaut pour qu’un graphe revienne quand même. Cette réponse s’exécute sans accroc, et elle peut porter sur le mauvais fournisseur.
Quand une IA écrit des requêtes pour votre équipe, quel est votre contrôle à réponse connue : un jeu de tests fixe, ou des contrôles ponctuels sur les réponses réelles ?