Ingénierie IA et IA agentique
Systèmes agentiques et recherche d'information
6 projets qui couvrent le déploiement en production, l'alignement de modèles, la recherche sur l'accès à l'information et le consulting sur les modèles frontières. Chacun se termine sur un chiffre, un commit ou une adresse en service. Ouvrez un projet pour lire l'étude de cas complète.
-
Multi-agents · déployé
Un planificateur pose une question d'approvisionnement en langage courant. Le système fait le calcul exact au lieu de l'estimer, et s'arrête pour l'accord d'un responsable au-delà de 10 000 $.
99 % de précision d'intention hors échantillon · 168 tests · 10 intentions métier
Un agent LangGraph oriente la question vers 1 des 7 solveurs exacts (OR-Tools, CVXPY, SciPy) ou vers une chaîne CRAG sur pgvector. Des entrées Pydantic typées séparent le modèle des solveurs, et une porte humaine suspend toute décision au-delà de 10 000 $ jusqu'à l'accord d'un responsable.
-
Infrastructure de déploiement · production
ERP agentique : l'infrastructure de déploiement
AKS · IaC BicepLa chaîne qui met le copilote sur une infrastructure réelle, avec les 6 contrôles à passer avant qu'une version atteigne un utilisateur.
IaC Bicep · surcouches Kustomize · test de fumée à 6 contrôles · OTel
Chaque envoi lance 6 tâches d'intégration continue, dont une équipe rouge, puis confie les nouvelles images à un déploiement qui attend l'approbation d'un relecteur. 7 modules Bicep décrivent la pile Azure, et un test de fumée à 6 contrôles suit chaque mise en service.
-
Alignement de modèles · SFT et DPO
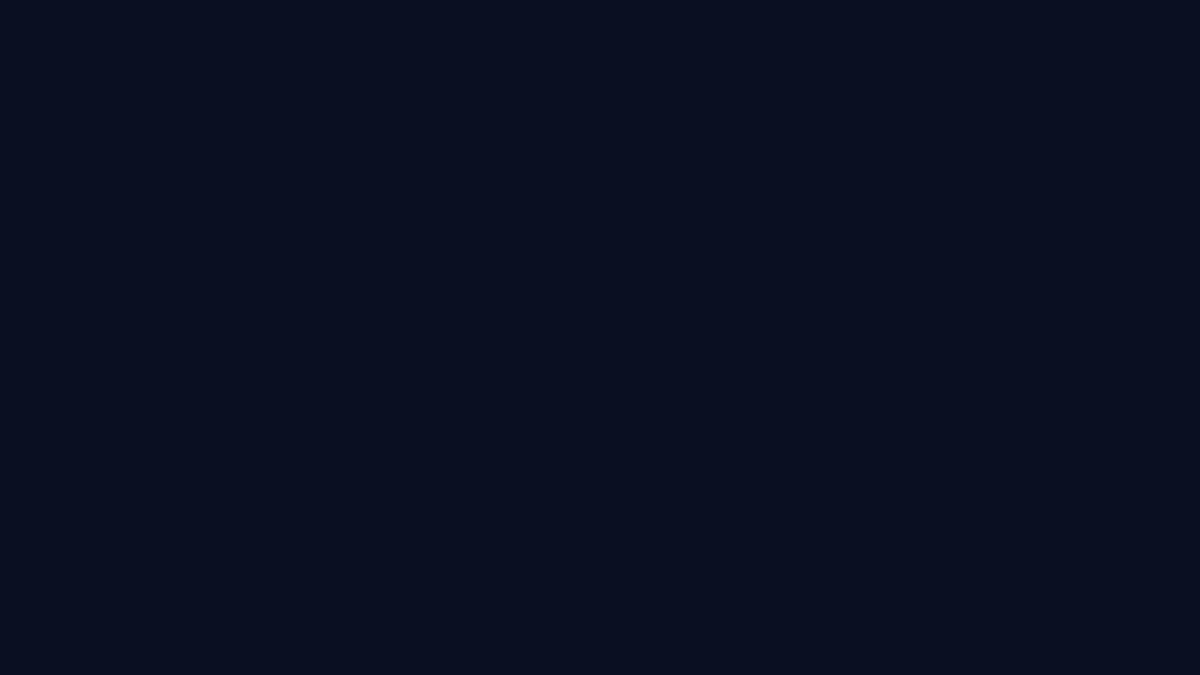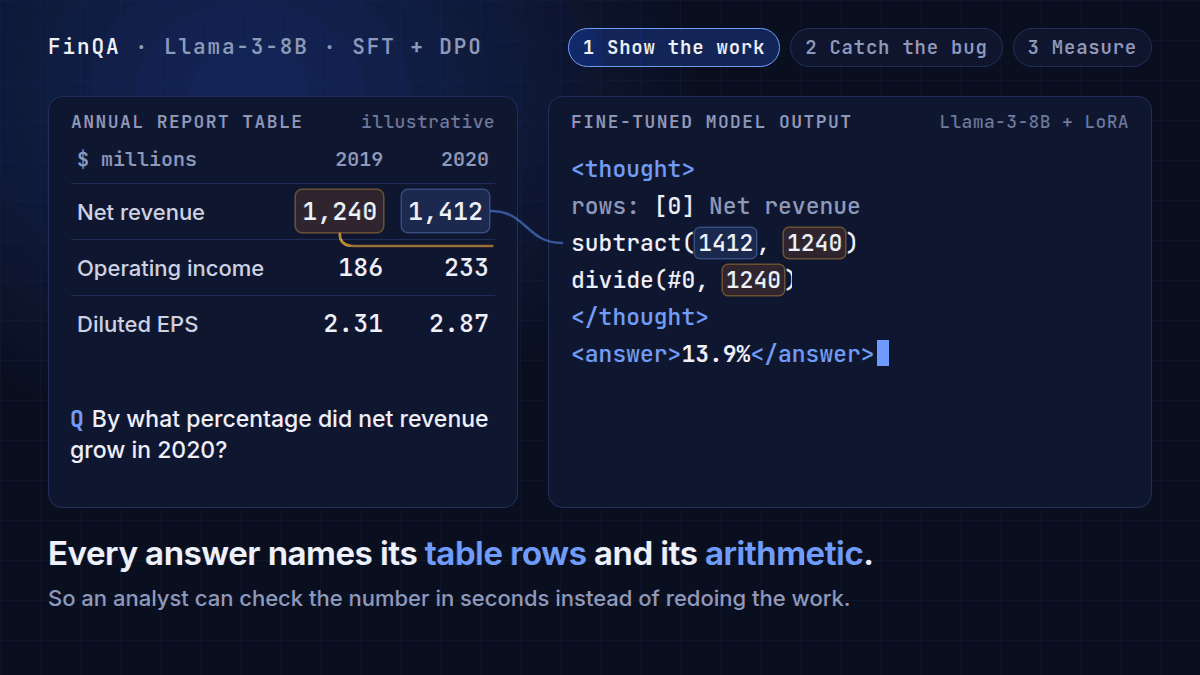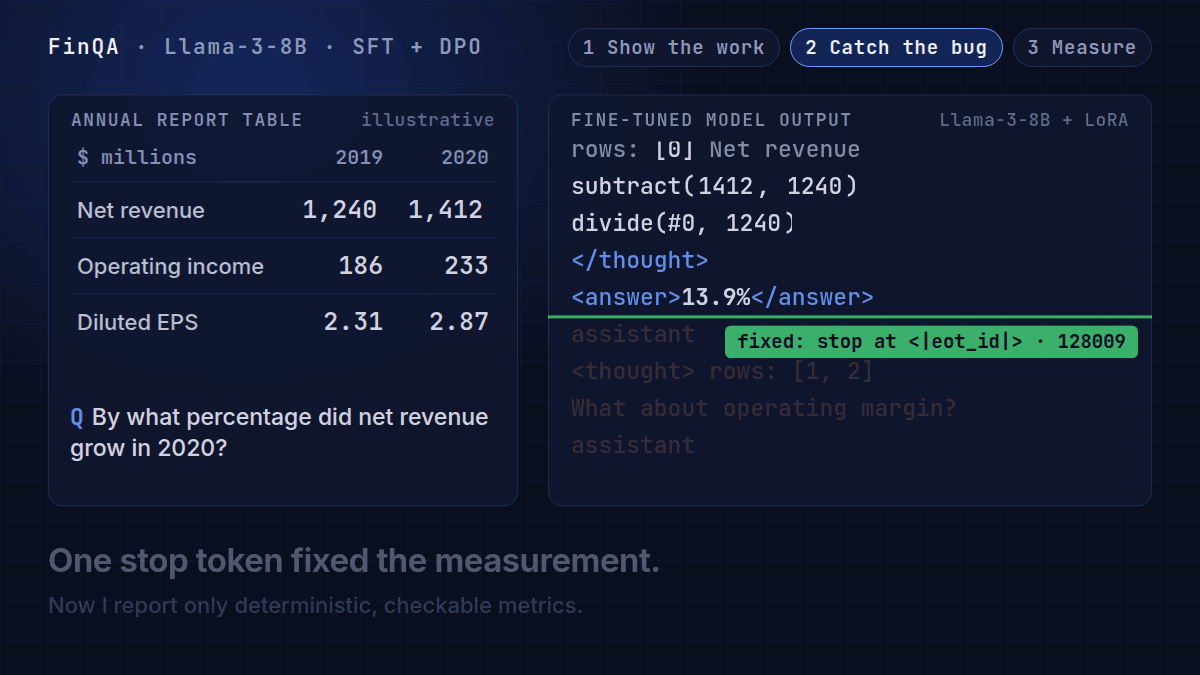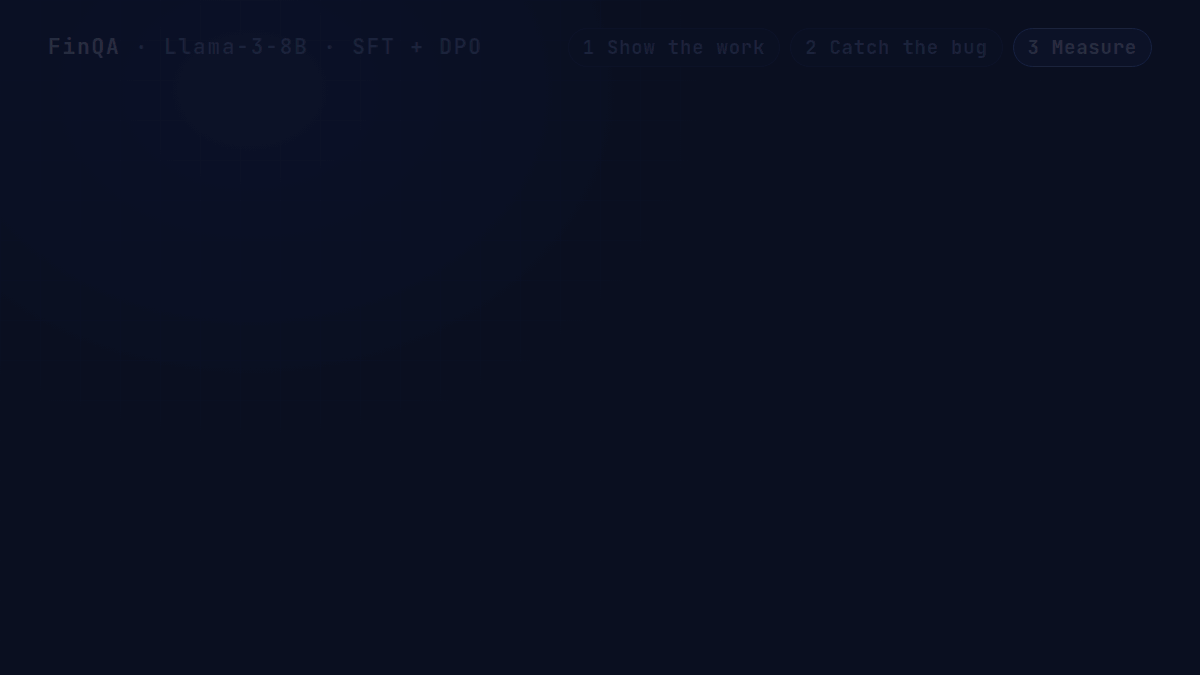
Alignement pour les questions-réponses financières par SFT, RLAIF et DPO
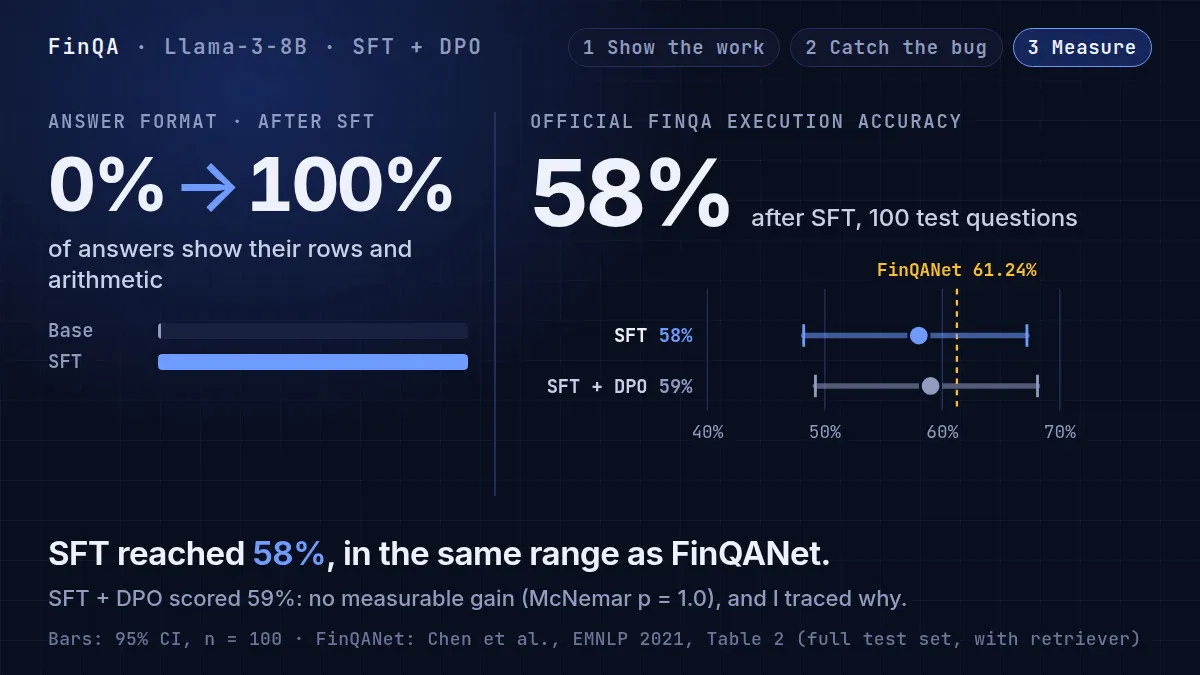
Llama-3-8B · FinQAJ'ai appris à un modèle de 8 milliards de paramètres à montrer son raisonnement sur des questions financières, et j'ai trouvé un défaut de mesure qui faisait paraître mes propres résultats bien pires qu'ils ne l'étaient.
Exactitude d'exécution FinQA 58 % (100 questions de test) · Format de réponse de 0 % à 100 %
Affinage supervisé avec LoRA sur une seule RTX 4090, puis 1 647 paires de préférence étiquetées par Zephyr-7B-β et un DPO. Le SFT+DPO obtient 59 % contre 58 % pour le SFT (test de McNemar, p = 1,0), et j'ai remonté ce résultat nul à trois causes.
-
RAG en production · déployé
Posez une question sur un corpus d'articles de recherche et recevez une réponse avec ses sources. Elle tourne en deux services Docker sur une machine équipée d'un GPU.
Précision des citations ALCE 0,654 · ~47 800 fragments indexés · 50 → 7 passages
FastAPI et Chainlit dans une pile Docker Compose à deux services, publiée sur GHCR à chaque envoi. Aucun environnement Python à préparer et aucun index à télécharger à la main.
-
Recherche d'information · en cours
RAG hybride pour des réponses citées sur des articles de recherche
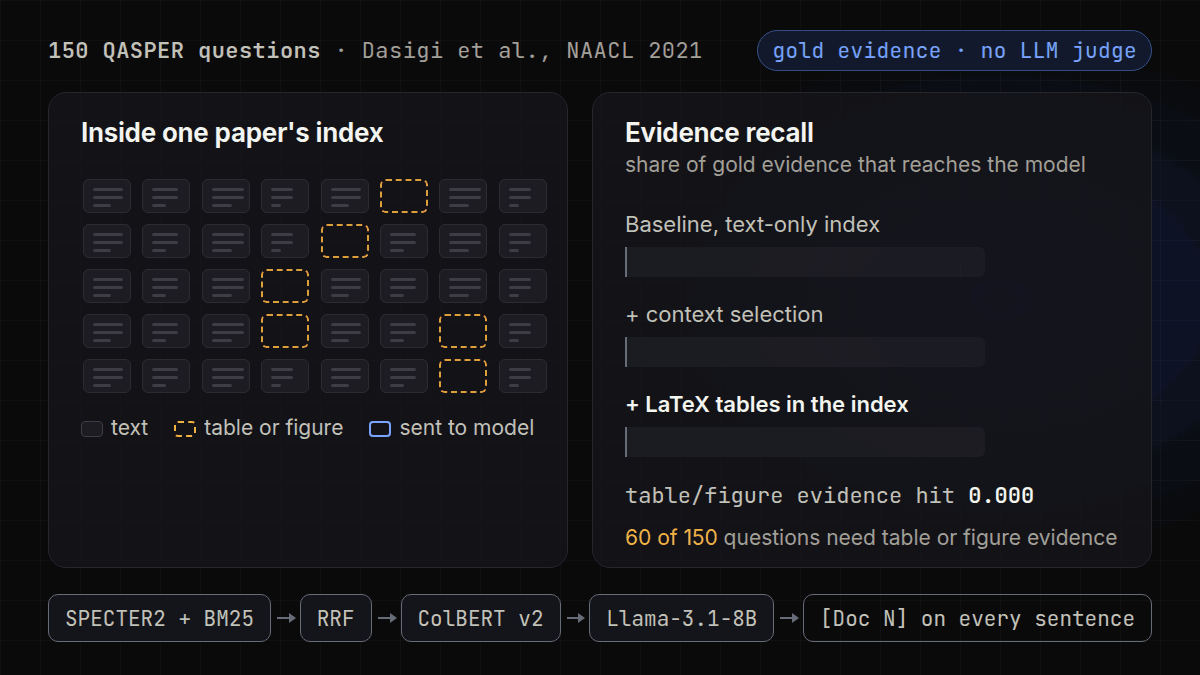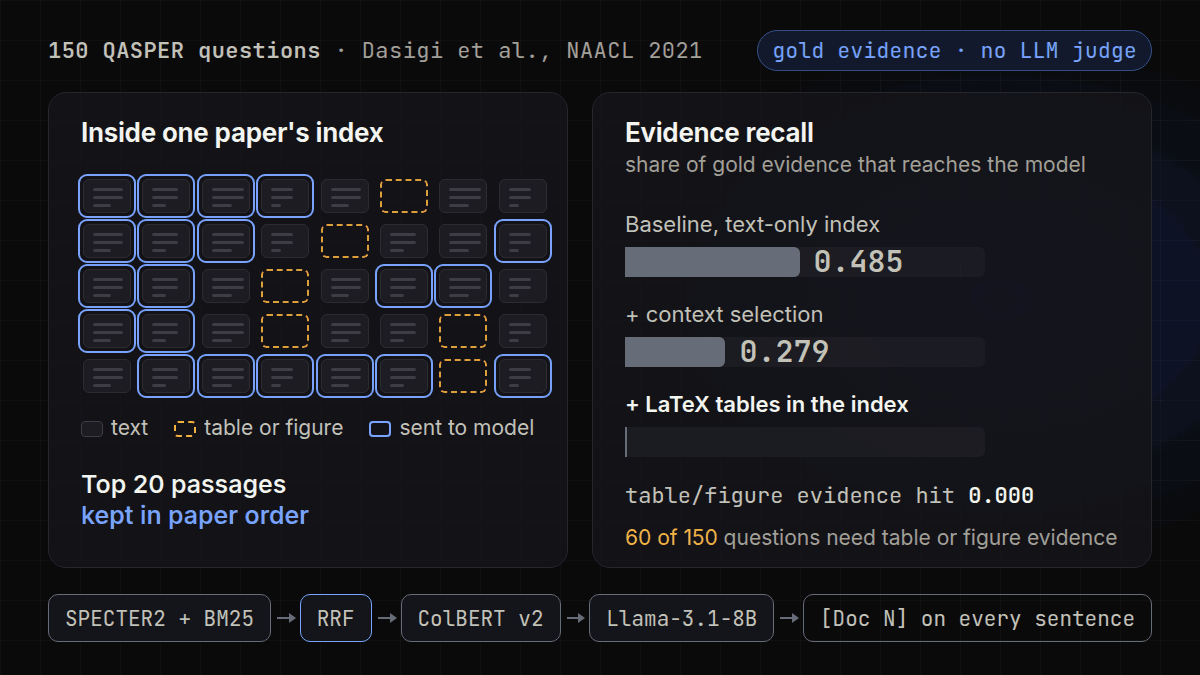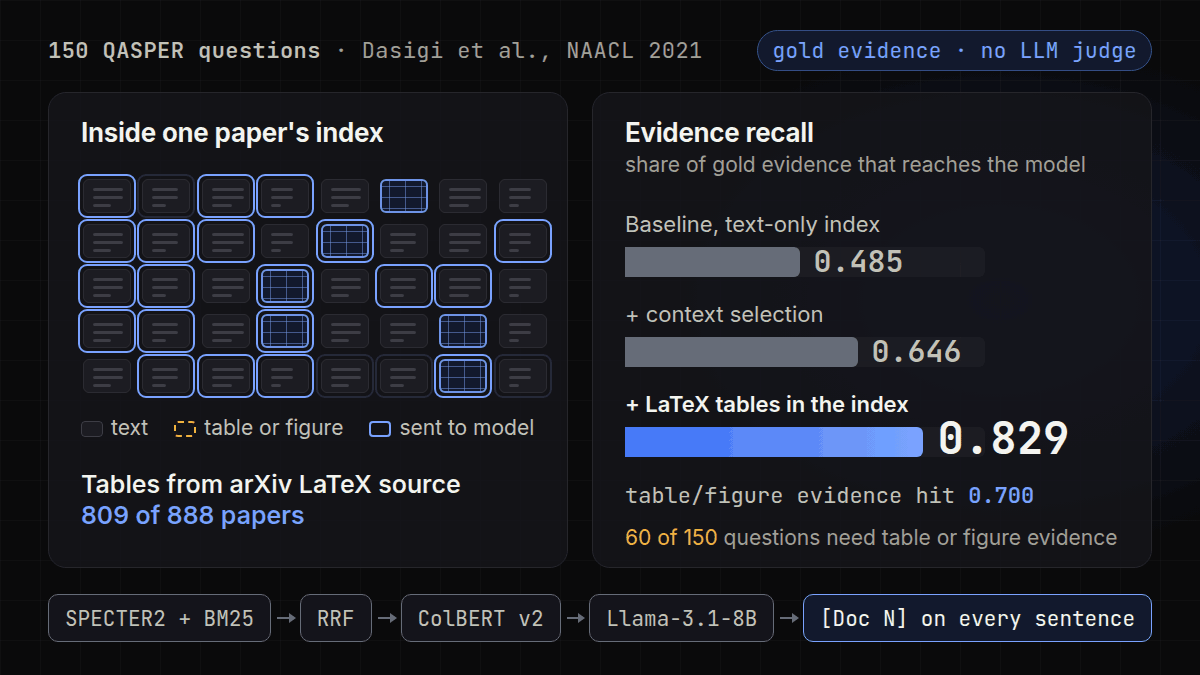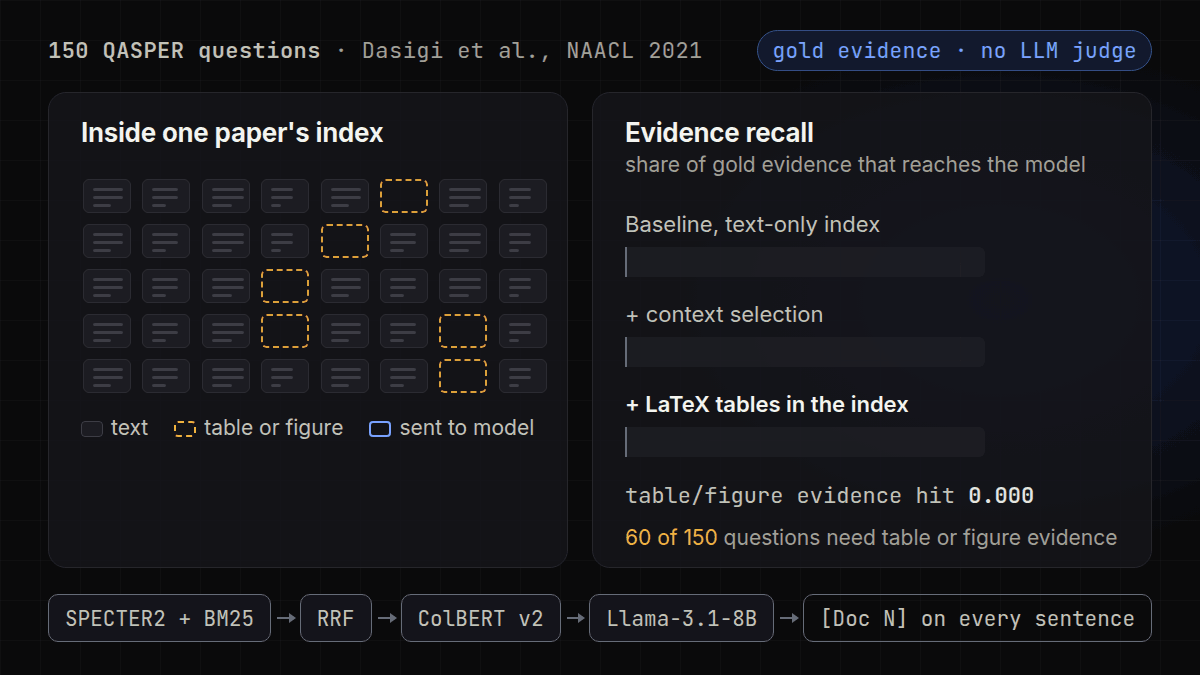
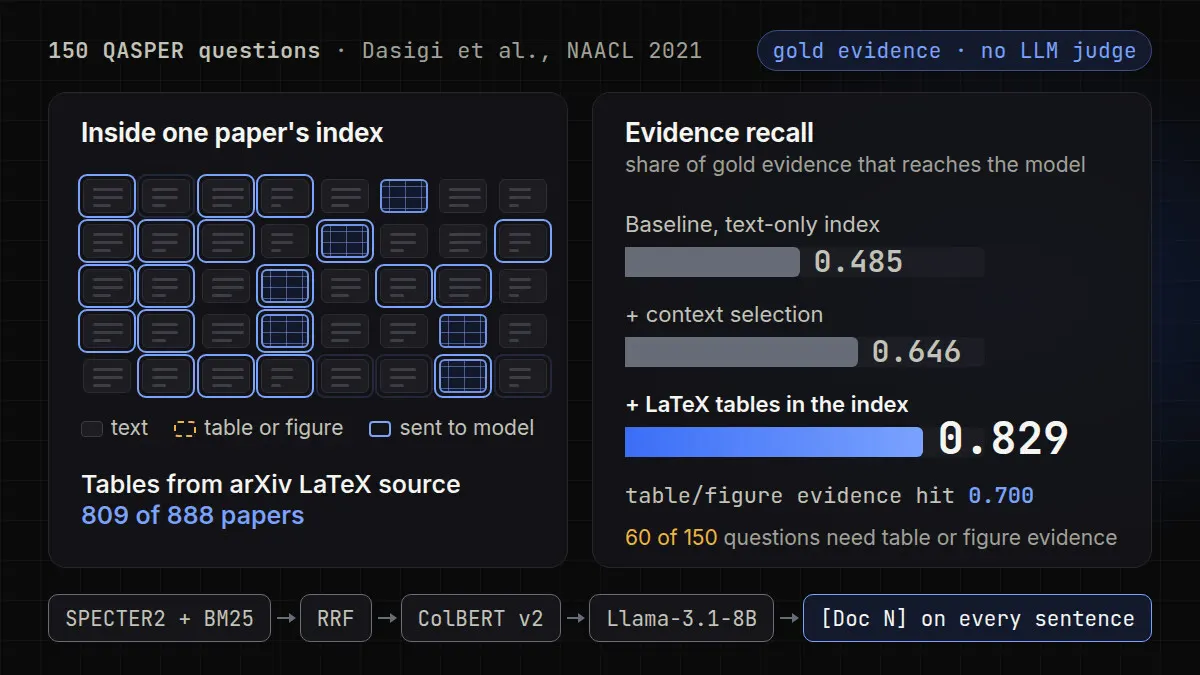
Jeu de référence QASPERUne chaîne qui répond aux questions sur des articles de recherche avec une citation dans chaque phrase, et un audit de mon propre code d'évaluation.
Rappel des preuves de 0,485 à 0,829 · 150 questions · sans juge LLM
Recherche SPECTER2 et BM25, classement ColBERT v2 et génération par Llama-3.1-8B. J'ai récupéré le corps des tableaux depuis les sources LaTeX d'arXiv pour 809 articles sur 888.
-
Alignement de modèles frontières · conseil en cours
Rendre les modèles frontières meilleurs sur les problèmes scientifiques difficiles, et concevoir la notation pour que le progrès se mesure au lieu de s'affirmer.
RLHF · RLVR · Grilles de critères · Chaîne de raisonnement
RLVR quand la réponse est objective, RLHF quand elle ne l'est pas, et des grilles de critères entre les deux pour une notation graduée. Avec l'analyse des trajectoires d'agents et les jeux de préférences qui alimentent le SFT et le DPO.