Quand le contrôle qualité de mon IA donnait l'alerte, le passage de la réponse survivait deux fois moins souvent que lorsqu'il restait muet
Sur le papier, mon assistant IA a 4 étapes : recherche, tri, contrôle, réponse. En mesurant ce que chacune faisait aux passages qu'il lit, j'ai vu que l'une ne choisissait presque rien et qu'une autre ne pouvait que perdre des preuves.
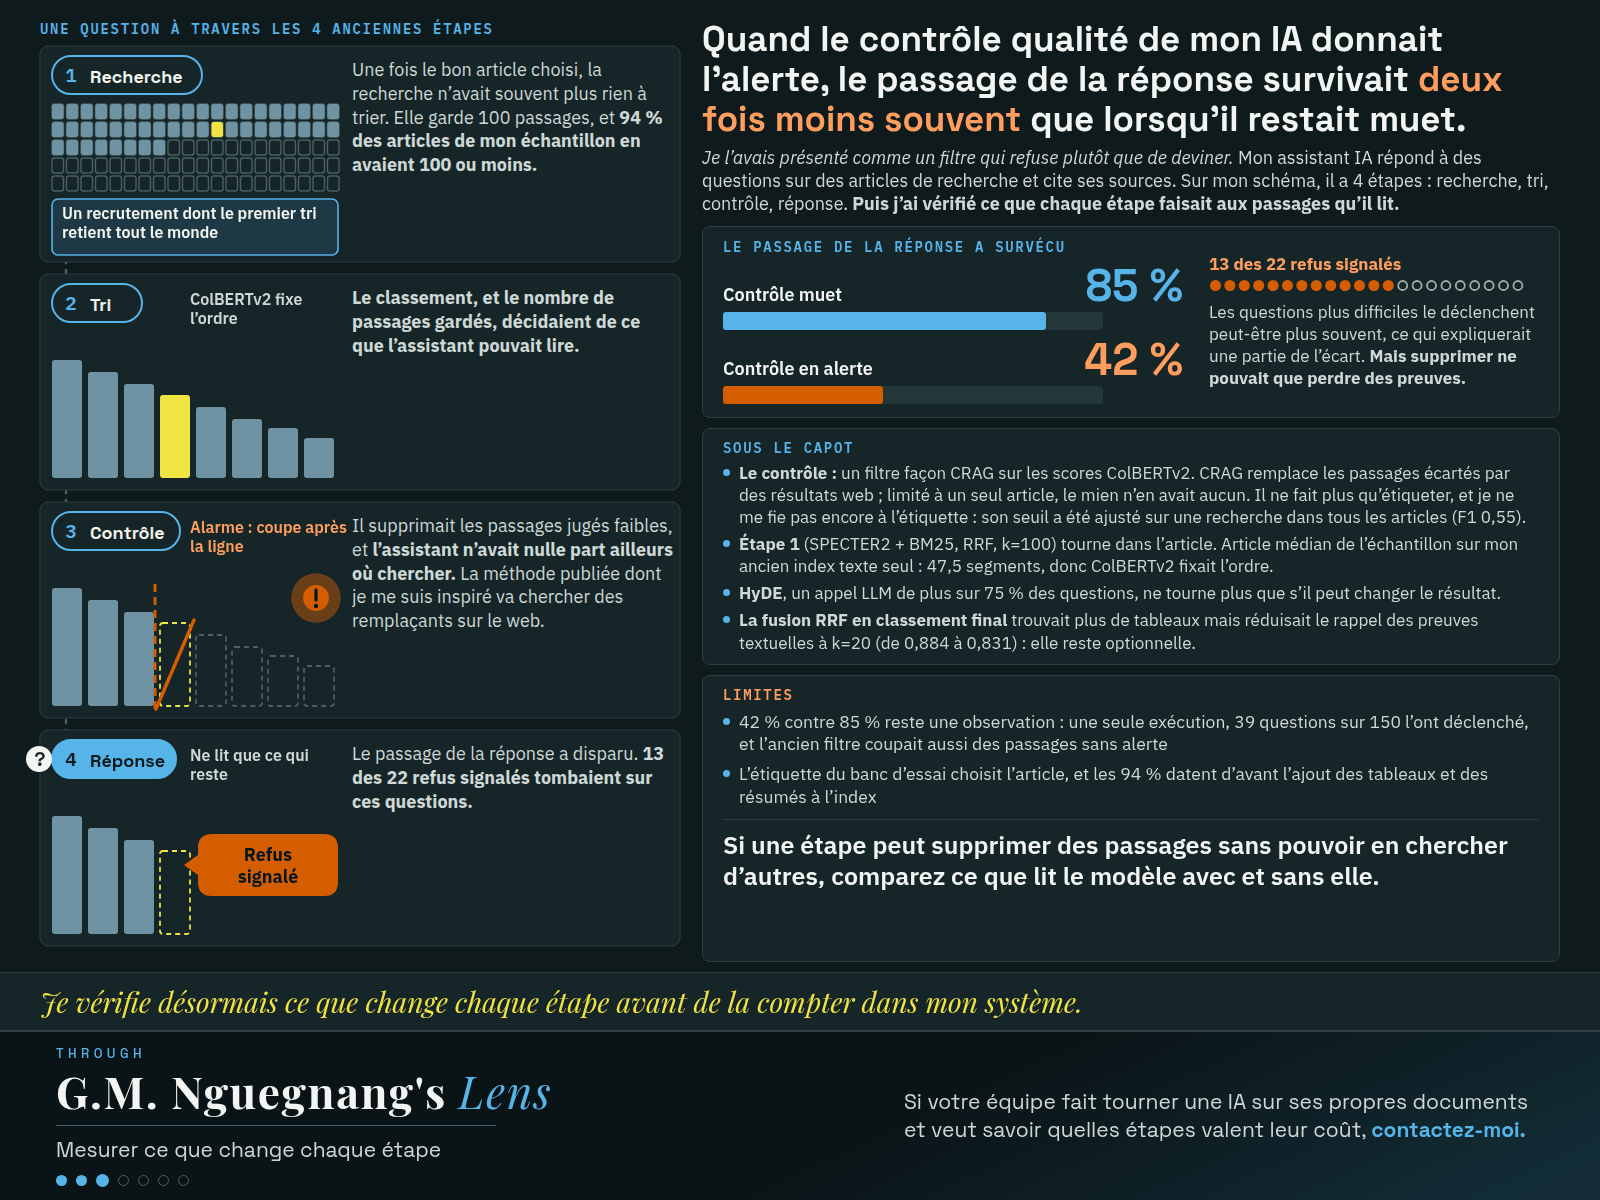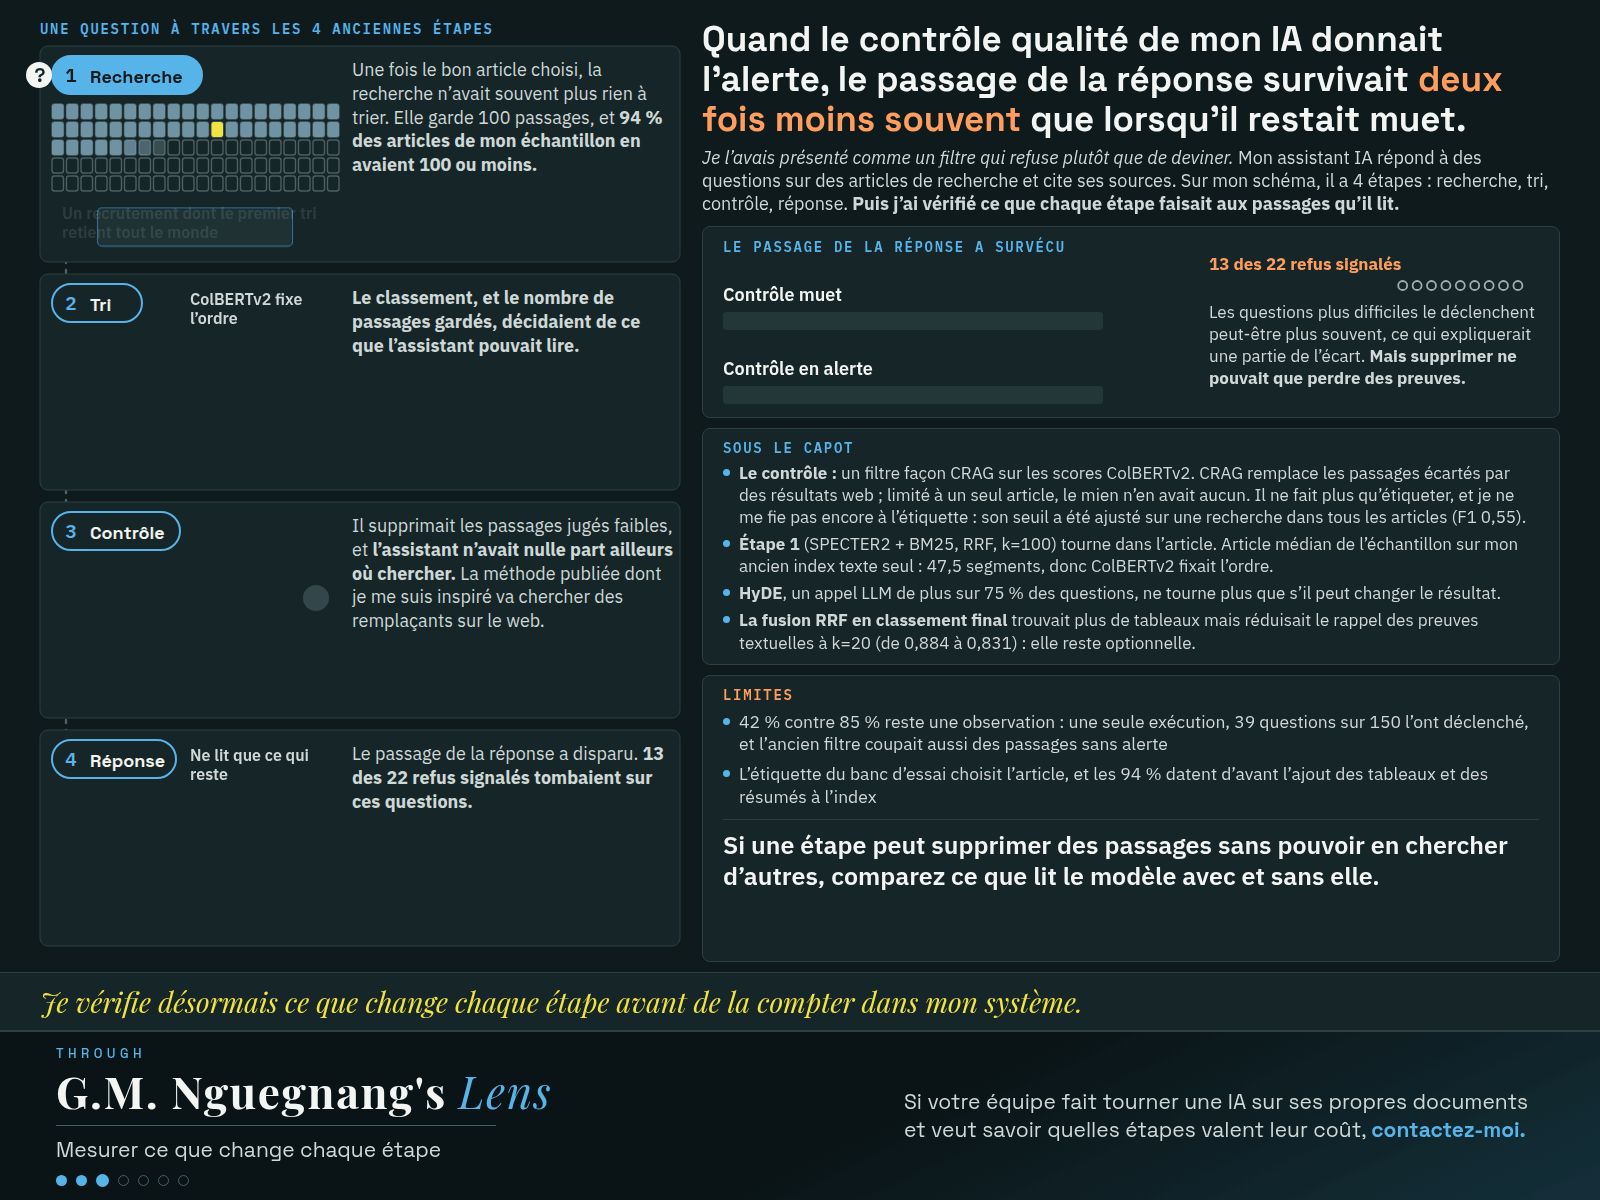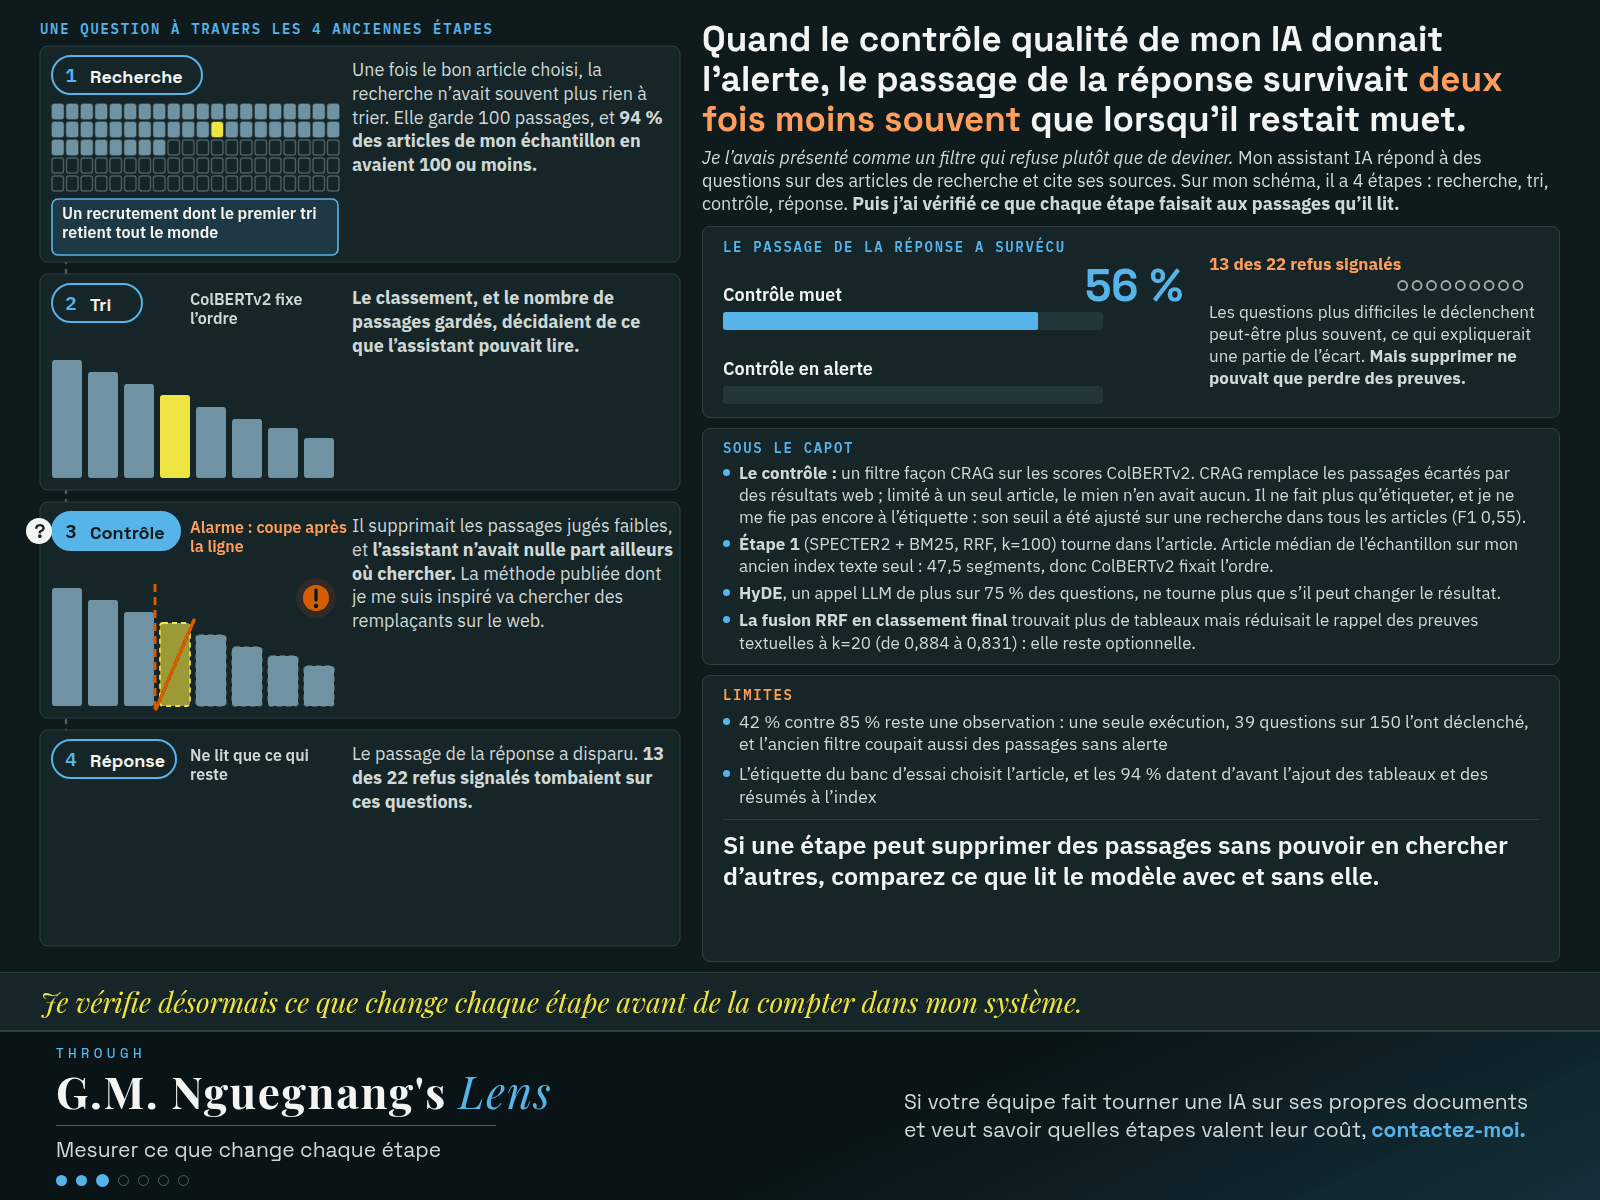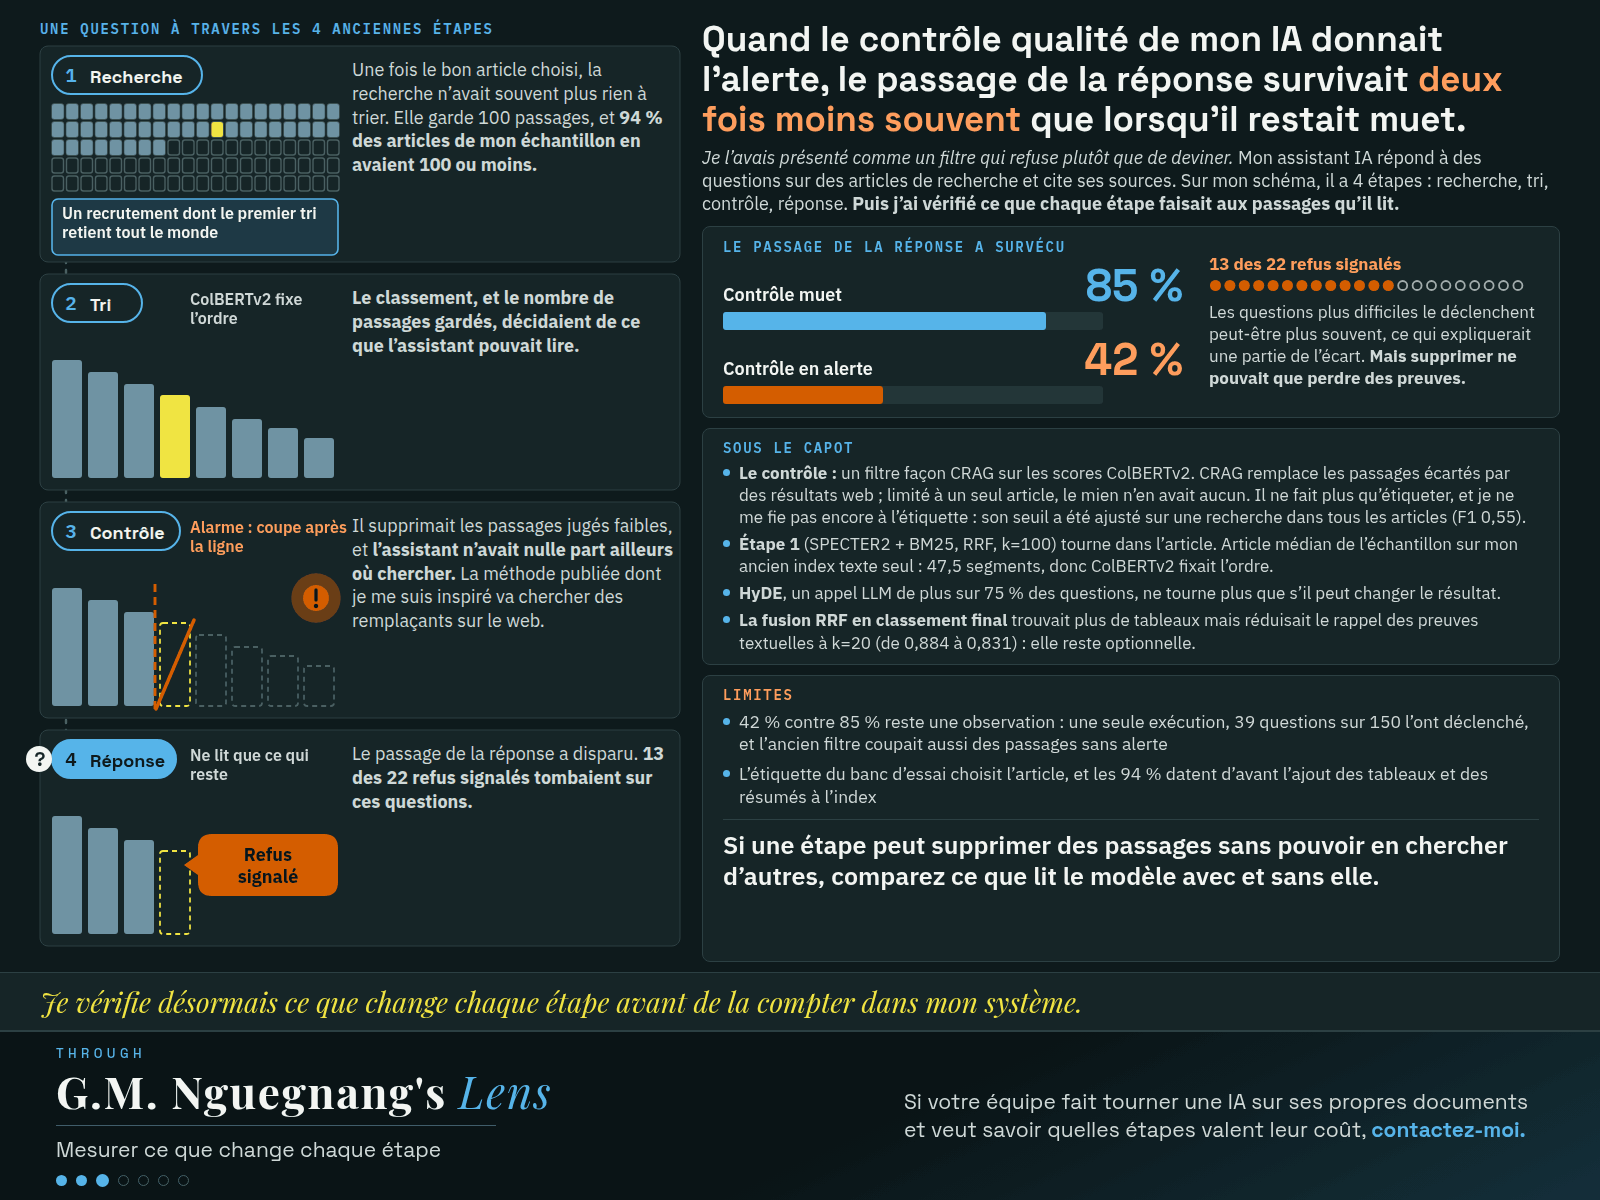
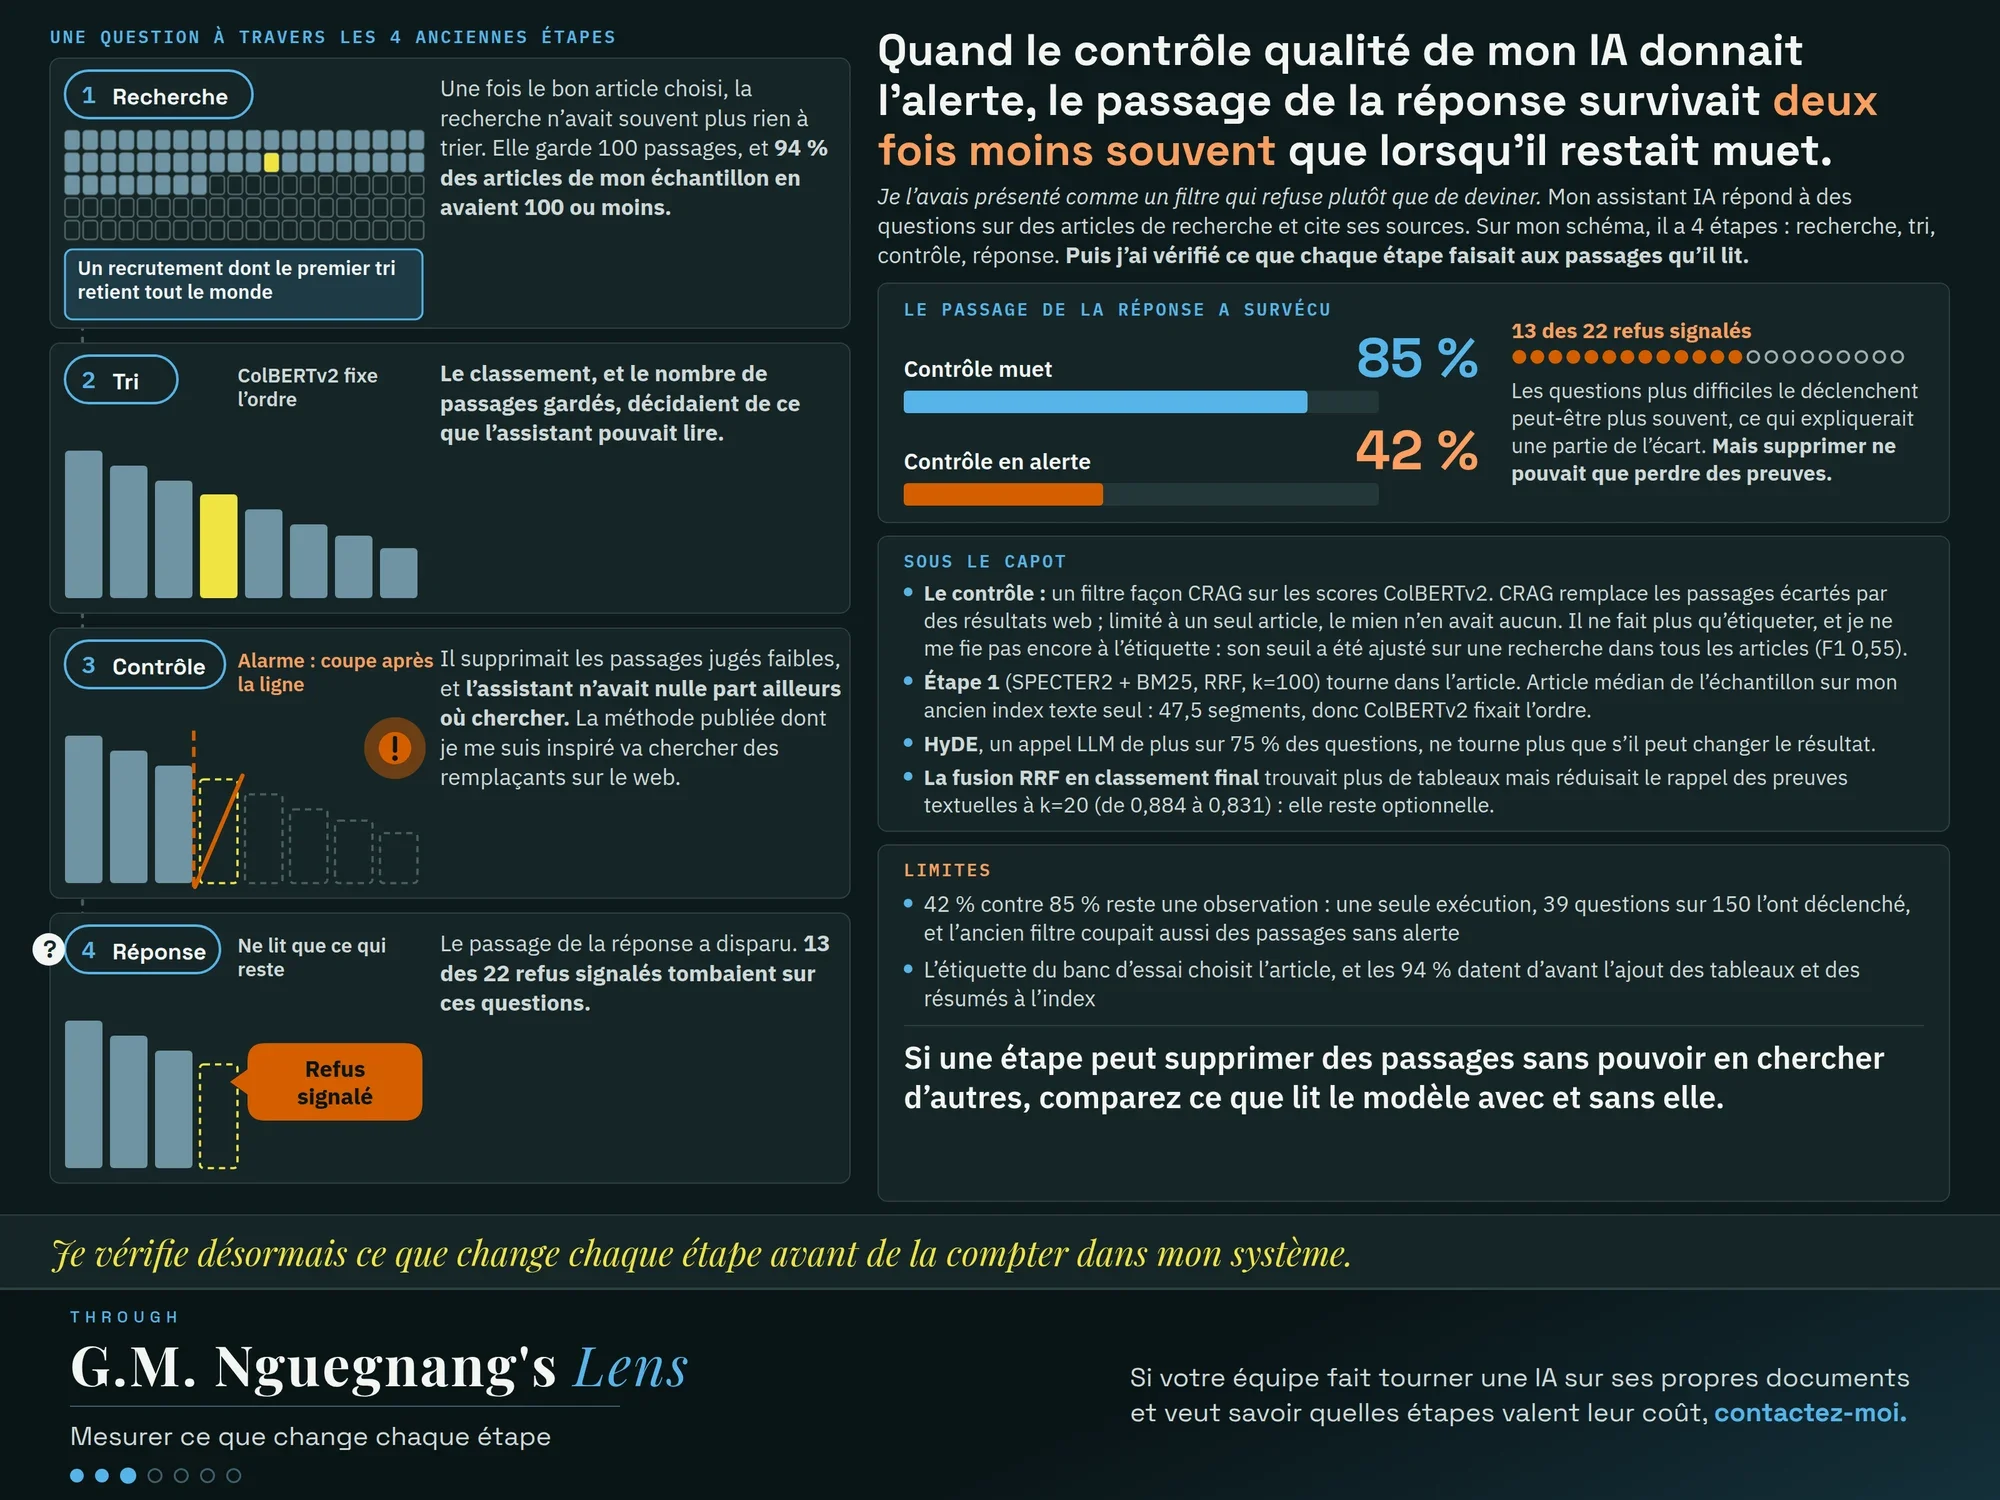
Quand le contrôle qualité de mon IA donnait l’alerte, le passage qui contenait la réponse survivait deux fois moins souvent que lorsqu’il restait muet.
Je l’avais présenté comme un filtre qui refuse plutôt que de deviner.
Pourquoi cela compte
Je développe un assistant IA qui répond à des questions sur des articles de recherche et cite ses sources. Sur mon schéma, il a 4 étapes : recherche, tri, contrôle, réponse.
J’ai ensuite vérifié ce que chaque étape faisait aux passages qu’il lit.
Une fois le bon article choisi, la recherche n’avait le plus souvent plus rien à trier. Elle garde 100 passages, et 94 % des articles de mon échantillon en avaient 100 ou moins. Imaginez un recrutement dont le premier tri retient tous les candidats.
Le contrôle qualité faisait pire. Il supprimait les passages qu’il jugeait faibles, et l’assistant n’avait nulle part ailleurs où chercher. Quand il donnait l’alerte, le passage de la réponse survivait dans 42 % des cas, contre 85 % quand il restait muet. 13 des 22 refus signalés tombaient sur ces questions.
Les questions plus difficiles le déclenchent peut-être plus souvent, ce qui expliquerait une partie de l’écart. Mais supprimer ne pouvait que perdre des preuves. La méthode publiée dont je me suis inspiré va chercher des remplaçants sur le web.
C’est donc le tri, avec le nombre de passages gardés, qui décidait de ce que l’assistant pouvait lire.
Je vérifie désormais ce que change chaque étape avant de la compter dans mon système.
Comment cela fonctionne
Le contrôle est un filtre de type CRAG appliqué aux scores de ColBERTv2. CRAG remplace les passages écartés par des résultats web ; limité à un seul article, le mien n’en avait aucun. Il se contente désormais d’étiqueter, et je ne me fie pas encore à cette étiquette : son seuil a été ajusté sur une recherche dans tous les articles (F1 0,55).
L’étape 1 (SPECTER2 + BM25, RRF, k=100) tourne à l’intérieur de l’article. Sur mon ancien index, limité au texte, l’article médian de l’échantillon comptait 47,5 segments : l’étape 1 renvoyait donc le plus souvent l’article entier, et c’est ColBERTv2 qui fixait l’ordre. HyDE, un appel supplémentaire au LLM sur 75 % des questions, ne tourne plus que lorsqu’il peut changer le résultat. Utilisée comme classement final, la fusion RRF trouvait plus de tableaux mais faisait baisser le rappel des preuves textuelles à k=20 (de 0,884 à 0,831) ; elle reste donc optionnelle.
Limites :
- 42 % contre 85 % reste une observation : une seule exécution, 39 questions sur 150 ont déclenché l’alerte, et l’ancien filtre coupait aussi des passages sans alerte
- C’est l’étiquette du banc d’essai qui choisit l’article, et les 94 % datent d’avant l’ajout des tableaux et des résumés à l’index
La leçon que j’en tire : si une étape peut supprimer des passages sans pouvoir en chercher d’autres, comparez ce que lit le modèle avec et sans elle.
L’animation montre une question qui traverse les 4 anciennes étapes.
Si votre équipe fait tourner une IA sur ses propres documents et veut savoir quelles étapes valent leur coût, contactez-moi.