Le filet de sécurité a répondu à 32 des 150 questions depuis le mauvais document
Si la recherche ne trouvait rien dans le bon document, mon système cherchait partout, pour que l'utilisateur ait toujours une réponse. Ce repli a transformé un échec visible en une réponse fausse et assurée.
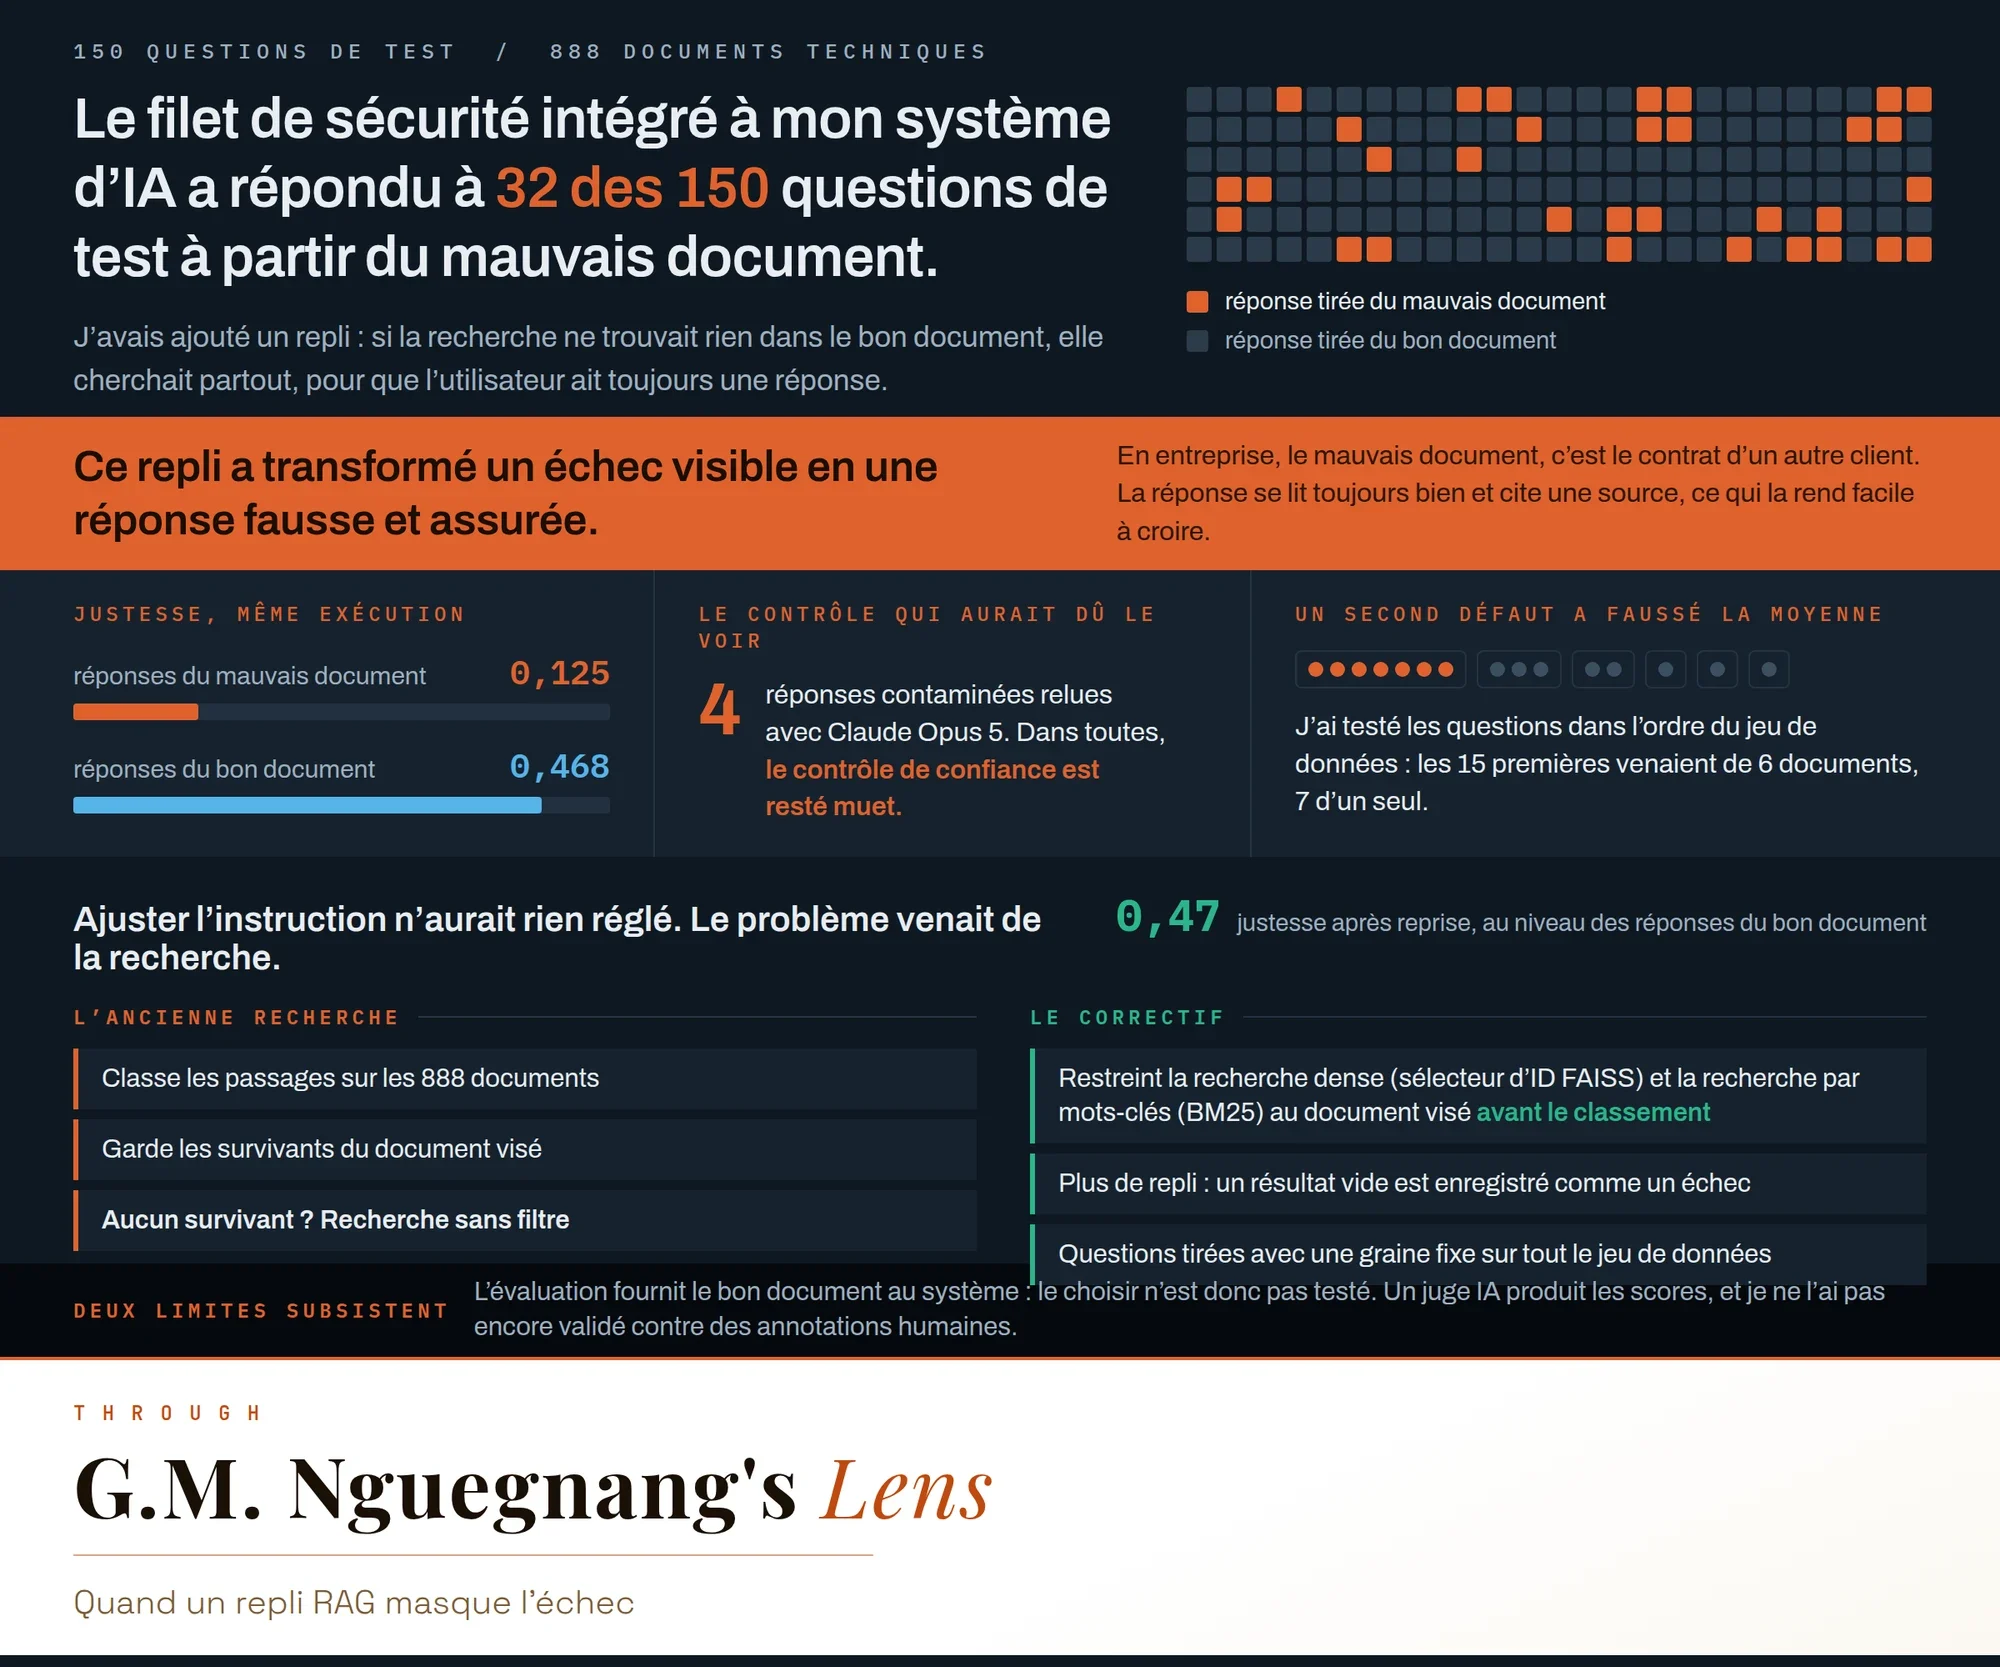
Le filet de sécurité que j’avais intégré à mon système d’IA a répondu à 32 des 150 questions de test depuis le mauvais document.
Pourquoi cela compte
Le système répond à des questions sur 888 documents techniques, avec citations. J’avais ajouté un repli : si la recherche ne trouvait rien dans le bon document, elle cherchait partout, pour que l’utilisateur ait toujours une réponse.
Ce repli a transformé un échec visible en une réponse fausse et assurée.
En entreprise, le mauvais document, c’est le contrat d’un autre client. La réponse se lit toujours bien et cite une source, ce qui la rend précisément facile à croire.
Mes scores ont montré le coût. Dans la même exécution, les réponses issues du mauvais document obtiennent 0,125 de justesse ; celles issues du bon document, 0,468. Dans les 4 réponses contaminées que j’ai relues avec Claude Opus 5, le contrôle de confiance est resté muet.
Un second défaut a faussé la moyenne : j’ai testé les questions dans l’ordre du jeu de données, et les 15 premières venaient de 6 documents, dont 7 d’un seul.
Ajuster l’instruction n’aurait rien réglé. Le problème venait de la recherche.
Comment cela fonctionne
L’ancienne recherche classait les passages sur les 888 documents, gardait les survivants du document visé, puis cherchait sans filtre quand aucun ne survivait. Filtrer après le classement est courant en recherche vectorielle, et c’est exactement là que cela casse : au moment où le filtre s’applique, le classement a déjà dépensé ses places sur le reste du corpus.
Le correctif restreint la recherche dense (un sélecteur d’ID FAISS) et la recherche par mots-clés (BM25) au document visé avant le classement. Le repli a disparu : un résultat vide est enregistré comme un échec plutôt que répondu depuis ailleurs. Les questions sont désormais tirées avec une graine fixe sur tout le jeu de données, si bien que le mélange ne dépend plus de l’endroit où le fichier commence.
Justesse après reprise : 0,47, au niveau des réponses issues du bon document. Les 32 réponses contaminées n’étaient pas un problème de génération qu’une meilleure instruction aurait pu atteindre.
Deux limites subsistent, et les deux sont à moi de lever. L’évaluation fournit le bon document au système : le choisir reste donc non testé. Un juge IA produit les scores, et je ne l’ai pas encore validé contre des annotations humaines.